Qu'est-ce que Clairic et sa place dans l'écosystème de l'IA
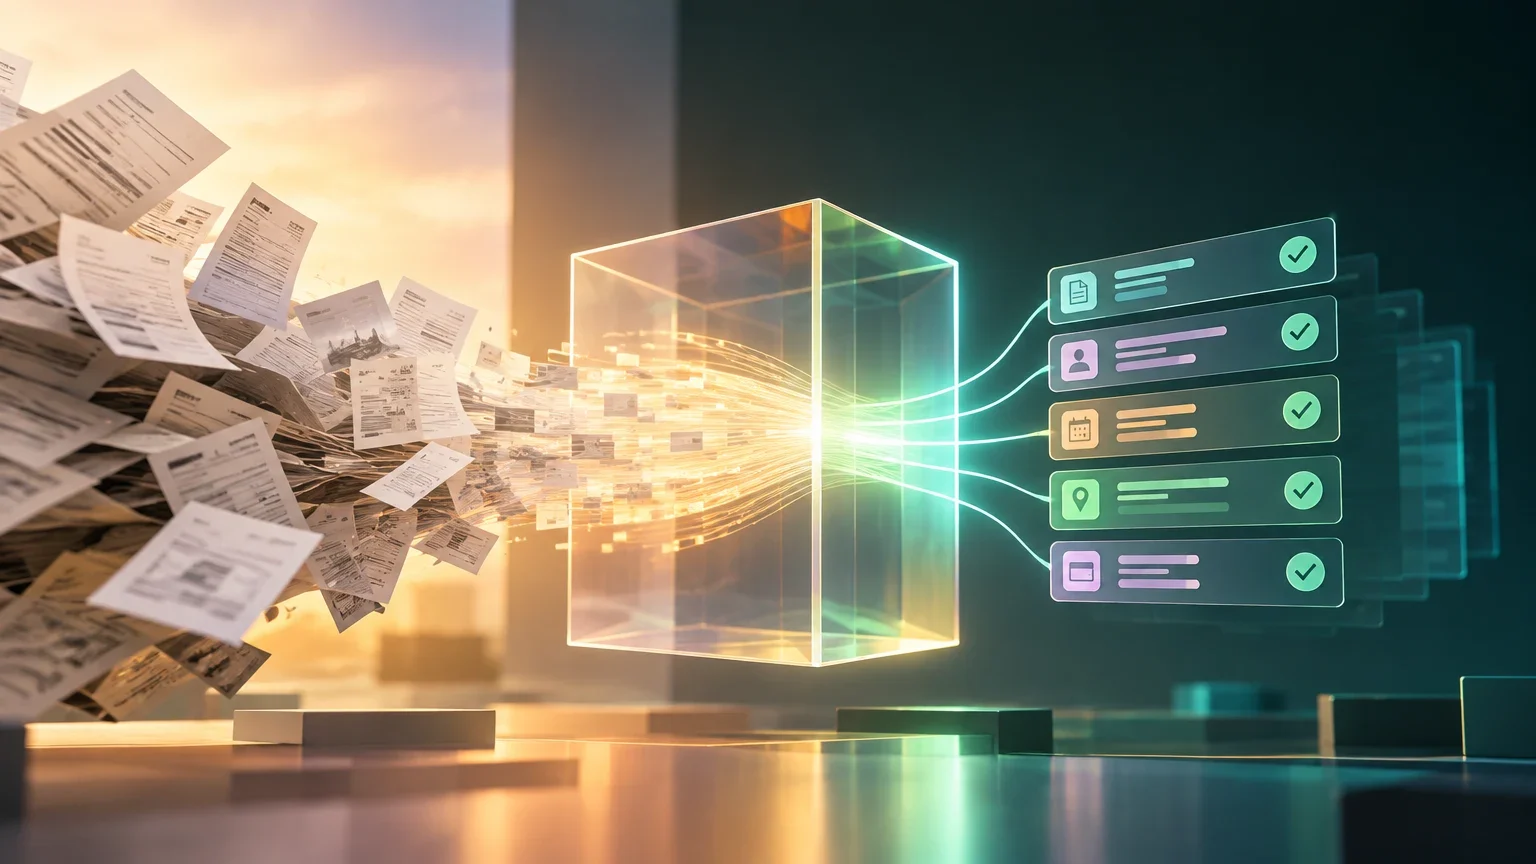
Cloudflare a lancé l'aperçu de Clairic, un modèle d'extraction classé « System One ». Contrairement aux grands modèles de langage (LLM), qui génèrent du texte jeton par jeton et nécessitent un raisonnement délibéré, Clairic est conçu pour répondre en un seul passage avec des valeurs typées extraites, calculées ou estimées directement à partir de l'entrée.
Le modèle s'intègre dans une architecture à trois couches proposée par Cloudflare : les modèles d'extraction (comme Clairic) convertissent l'entrée brute en valeurs typées ; les modèles de décision (comme Clef) transforment ces valeurs en décisions ; et les LLM (comme GLM-5.3) rédigent la réponse finale. Cette séparation permet à chaque composant d'effectuer la tâche pour laquelle il est optimisé, réduisant la charge cognitive et computationnelle des modèles généralistes.
Comparaison des architectures System One vs System Two
Différences clés entre l'extraction directe et la génération de texte.
| Caractéristique | Clairic (Extraction) | LLM (Génération) |
|---|---|---|
| Sortie | Valeurs typées (nombres, dates, texte) | Texte libre (nécessite un parsing) |
| Processus | Un seul passage parallèle | Génération séquentielle de jetons |
| Coût de sortie | Nul | Par jeton généré |
| Risque d'hallucination | Limité par le type de donnée | Élevé (peut inventer des données) |
Architecture technique : extraction en un seul passage
La mécanique centrale de Clairic est l'élimination de la génération de texte intermédiaire. Le développeur envoie un « état » (texte et images) et un schéma de champs typés. Le modèle traite ces informations en une seule passe d'inférence et renvoie une valeur valide pour chaque champ, ou « null » si la donnée n'est pas présente dans l'entrée.
Chaque réponse scalaire inclut un score de confiance et « p_null », la probabilité que la valeur ne soit pas déterminée par l'entrée. Pour les champs de texte, le modèle renvoie les décalages de caractères (spans) permettant de retracer le fragment original dans le document. Cette traçabilité est cruciale pour les audits et les corrections, car elle élimine l'ambiguïté de savoir d'où provient une donnée extraite.
Analyse des coûts et des performances par rapport aux LLM
Le prix de Clairic est de 0,10 USD par million de jetons d'entrée, sans frais pour les jetons de sortie. Cette structure de coûts est significativement plus basse que celle des LLM, qui facturent à la fois l'entrée et la sortie générée. Dans le test de référence de Cloudflare, un pipeline de réclamations de produits endommagé combinant Clairic, Clef et GLM-5.3 a coûté 6 032 USD par million de réclamations, contre 11 740 USD pour un pipeline basé exclusivement sur GLM-5.3.
En termes de latence, l'extraction avec Clairic a pris 0,46 seconde, tandis que GLM-5.3 a mis 16,1 secondes pour la même tâche. Le pipeline complet avec Clairic s'est terminé en 19,3 secondes, soit 69 % plus rapide que les 61,7 secondes du flux basé uniquement sur des LLM. Il est important de noter que la majeure partie du temps restant (18,6 secondes) a été consacrée à la rédaction de la réponse par le LLM, et non à l'extraction.
Métriques de performance dans un pipeline de réclamations
Comparaison directe entre le flux hybride (Clairic + Clef + LLM) et le flux 100 % LLM.
| Métrique | Flux Hybride | Flux LLM (GLM-5.3) |
|---|---|---|
| Latence totale | 19,3 s | 61,7 s |
| Temps d'extraction | 0,46 s | 16,1 s |
| Coût par million | 6 032 $ | 11 740 $ |
| Réduction des coûts | 49 % | - |
Cas d'usage optimaux et limites connues
Clairic est supérieur dans les tâches d'extraction de données structurées de documents semi-structurés, tels que les factures, les e-mails de support, les formulaires de réclamation et les rapports d'incidents. Sa capacité à gérer jusqu'à quatre images par requête le rend utile pour traiter des photographies de reçus ou des documents scannés de faible qualité.
Cependant, Cloudflare avertit que le modèle actuel est un point de contrôle précoce. Les chaînes arithmétiques de plus de deux étapes (comme l'addition de plusieurs lignes d'un tableau) ne sont pas fiables et il est recommandé d'effectuer ces opérations dans le code. De plus, les estimations nécessitent des preuves dans l'entrée (comme des prix comparables) ; sans cela, les intervalles de confiance peuvent être trop larges. La prévision de séries temporelles est basique et ne remplace pas les modèles spécialisés entraînés sur des données spécifiques.
Implications pour les développeurs et adoption
Pour les développeurs, Clairic offre un moyen de réduire la complexité des pipelines d'IA. En séparant l'extraction de la génération, on élimine les validateurs JSON et les nouvelles tentatives qui sont souvent nécessaires lorsqu'on utilise un LLM pour des tâches structurées. L'intégration est directe via Workers AI avec env.AI.run() ou l'API REST.
La disponibilité des poids ouverts est prévue pour l'avenir, ce qui permettra aux organisations de réaliser du fine-tuning ou d'exécuter le modèle localement. Pour l'instant, l'adoption doit être progressive, en commençant par des tâches d'extraction à faible risque et en surveillant de près les scores de confiance. La question ouverte est de savoir comment le modèle se comportera avec des formats de documents non standard ou dans des langues autres que l'anglais, un point crucial pour l'adoption sur des marchés comme l'Amérique latine.
Processus d'intégration recommandé
Étapes pour implémenter Clairic dans un pipeline existant.
- 01Identifier les tâches d'extraction répétitives dans le flux actuel.
- 02Définir le schéma des champs typés (text, number, date, etc.).
- 03Implémenter l'appel à Clairic et capturer les scores de confiance.
- 04Établir des seuils de confiance pour transmettre les cas douteux à une révision.
- 05Effectuer les opérations arithmétiques complexes dans le code, et non dans le modèle.
Questions ouvertes
- Aucun benchmark de précision standard indépendant n'a été publié ; les métriques proviennent de tests internes de Cloudflare.
- Le comportement du modèle avec des documents dans des langues autres que l'anglais (espagnol, portugais) n'est pas documenté dans les sources primaires.
- La date exacte de publication des poids ouverts du modèle n'a pas été spécifiée par Cloudflare.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction