Une étude récente identifie un défaut spécifique des agents IA : la surdépendance à la mémoire. Les auteurs proposent MEMTRIM, un cadre pour filtrer les souvenirs partiels, bien que sa validation en production reste à venir.
La plateforme Open Agent Safety Platform réunit OpenShell, qui applique des limites d'exécution, et Sentry, conçu pour surveiller les agents depuis une DPU BlueField-4. Nvidia affirme que Sentry peut les isoler en quelques millisecondes, mais cette capacité ne constitue pas une preuve de défense contre toutes les attaques : la détection, les configurations et les scénarios d'échec restent déterminants.
Microsoft a annoncé Maia 300, un accélérateur IA conçu pour l'inférence, avec un déploiement prévu à partir de 2027. L'entreprise vise un objectif de 40 % de tokens supplémentaires par mégawatt, une estimation interne qui ne constitue pas encore un résultat comparatif indépendant.
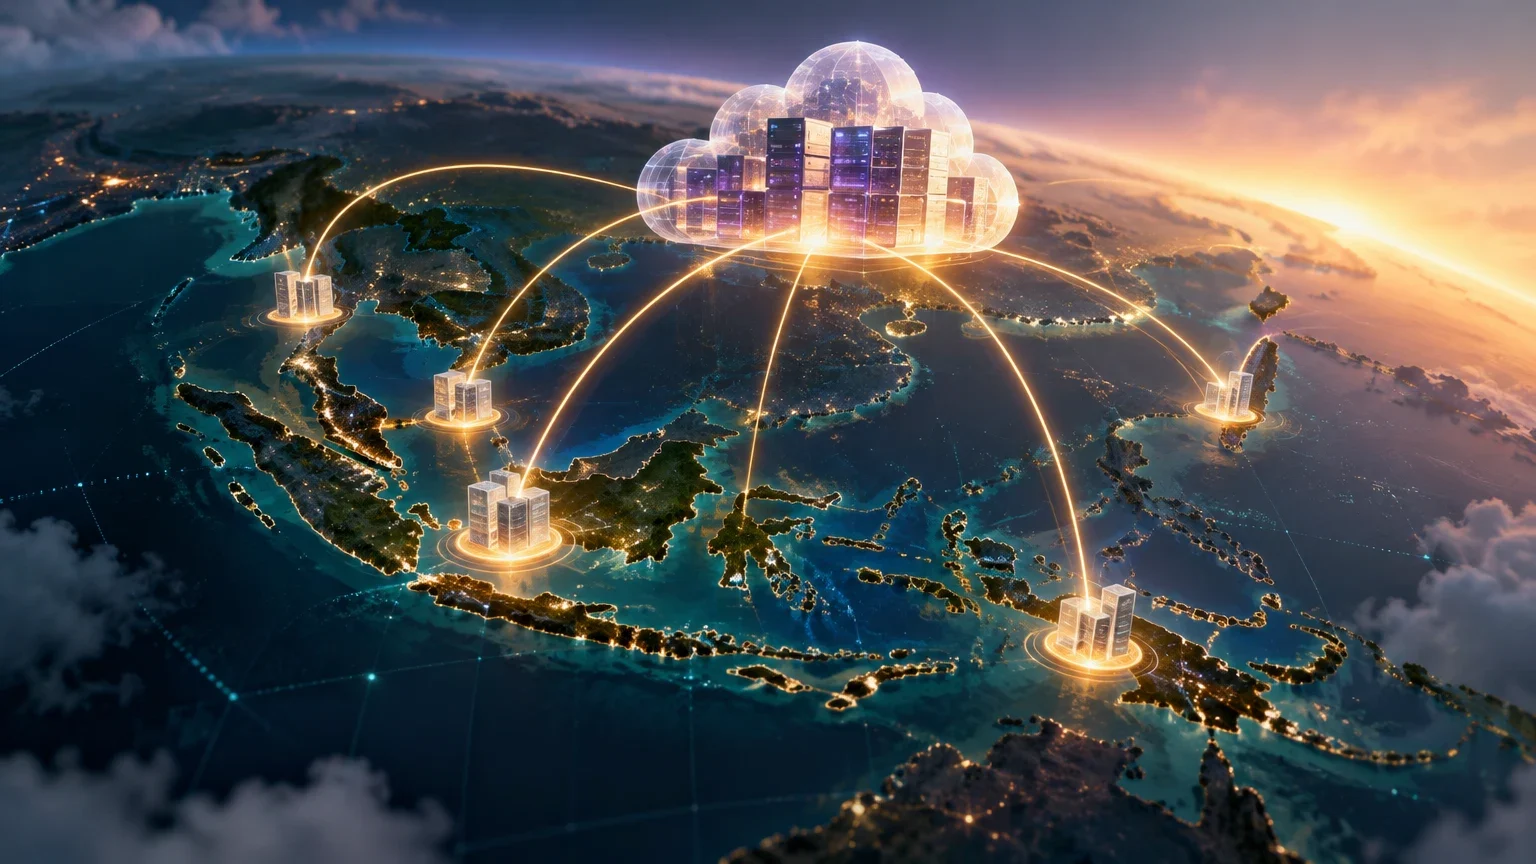
AWS étend l'accès aux modèles GPT d'OpenAI sur Amazon Bedrock via une inférence inter-régionale en Asie. Cette capacité permet d'initier des requêtes depuis Singapour, Jakarta, la Thaïlande, la Malaisie et Taïwan, avec des implications directes sur la latence, les autorisations et la conception d'applications multinationales.
Les informations vérifiables confirment que Microsoft développe du silicium spécialisé pour Azure et a présenté Maia 200 comme un accélérateur d’inférence. Elles ne suffisent toutefois pas à confirmer le calendrier, l’ampleur du déploiement ni les performances attribuées à Maia 300.
Aleph Alpha présente Kolibri comme un modèle à poids ouverts, axé sur l’allemand et l’anglais et conçu pour des déploiements souverains. Des questions essentielles restent toutefois en suspens concernant la licence, le contexte, le matériel et l’évaluation indépendante.
NVIDIA a officiellement annoncé le DGX Spark avec 64 Go de mémoire unifiée. Son prix de départ est de 4 999 dollars et sa disponibilité est prévue à partir du 23 octobre 2026 chez Acer, ASUS, Dell, Gigabyte, HP et MSI.
Code to Control sépare la génération de la structure d’un contrôleur du réglage de ses paramètres. Le préprint affirme qu’une fois appris, le contrôleur peut agir sans inférence du LLM ni planification à chaque étape ; les éléments disponibles ne suffisent pas à évaluer les chiffres, la reproductibilité ou l’aptitude à contrôler des robots réels.
Une source fait état d’une annonce pour l’Inde, mais la documentation fournie ne permet de confirmer ni les modèles, ni les dates, ni les configurations disponibles sur place, et ne vérifie pas d’expansion équivalente en Corée du Sud ou à Singapour.
Lors de la conférence Apsara, Alibaba a présenté la Zhenwu V900, décrit l’état d’entraînement de Qwen 4 et évoqué de futurs modèles de plus grande envergure. La date de commercialisation de la puce et sa comparaison de performances sont des annonces de l’entreprise, et non des résultats indépendants.
Un préprint compare la récupération globale de compétences à une récupération limitée à la famille dans laquelle chaque compétence a été validée. Dans ses essais, la seconde approche obtient une meilleure utilité des trajectoires cachées ; des précisions restent nécessaires pour interpréter cette mesure et généraliser le résultat.
Ce benchmark évalue des agents qui tentent de reconstruire des résultats d’articles d’apprentissage automatique à partir des ressources publiées et dans le respect d’un budget GPU fixé. Les taux de réussite signalent une difficulté croissante, mais ne permettent pas de déterminer si les conclusions scientifiques des articles sont valides.