DE · Internationale Ausgabe · 30/10/2026
Inferama täglich · 30/10/2026
Die wichtigsten KI-Neuigkeiten seit dem letzten Newsletter, nach redaktioneller Relevanz ausgewählt.
Zeitraum der Neuigkeiten: 28/10/2026 08:30 → 30/10/2026 08:30 (Europe/Madrid).
Google DeepMind stellt Genie 4 vor: ein interaktives Weltmodell in der experimentellen Forschungsphase
Genie 4 erzeugt erkundbare Umgebungen mit Audio, die sich während der Simulation durch Anweisungen verändern lassen. Google DeepMind stellt das Modell als Forschungsvorschau bereit und räumt Grenzen bei längerfristiger Kohärenz, Physik, Audio und lesbarem Text ein.
Artikel lesen →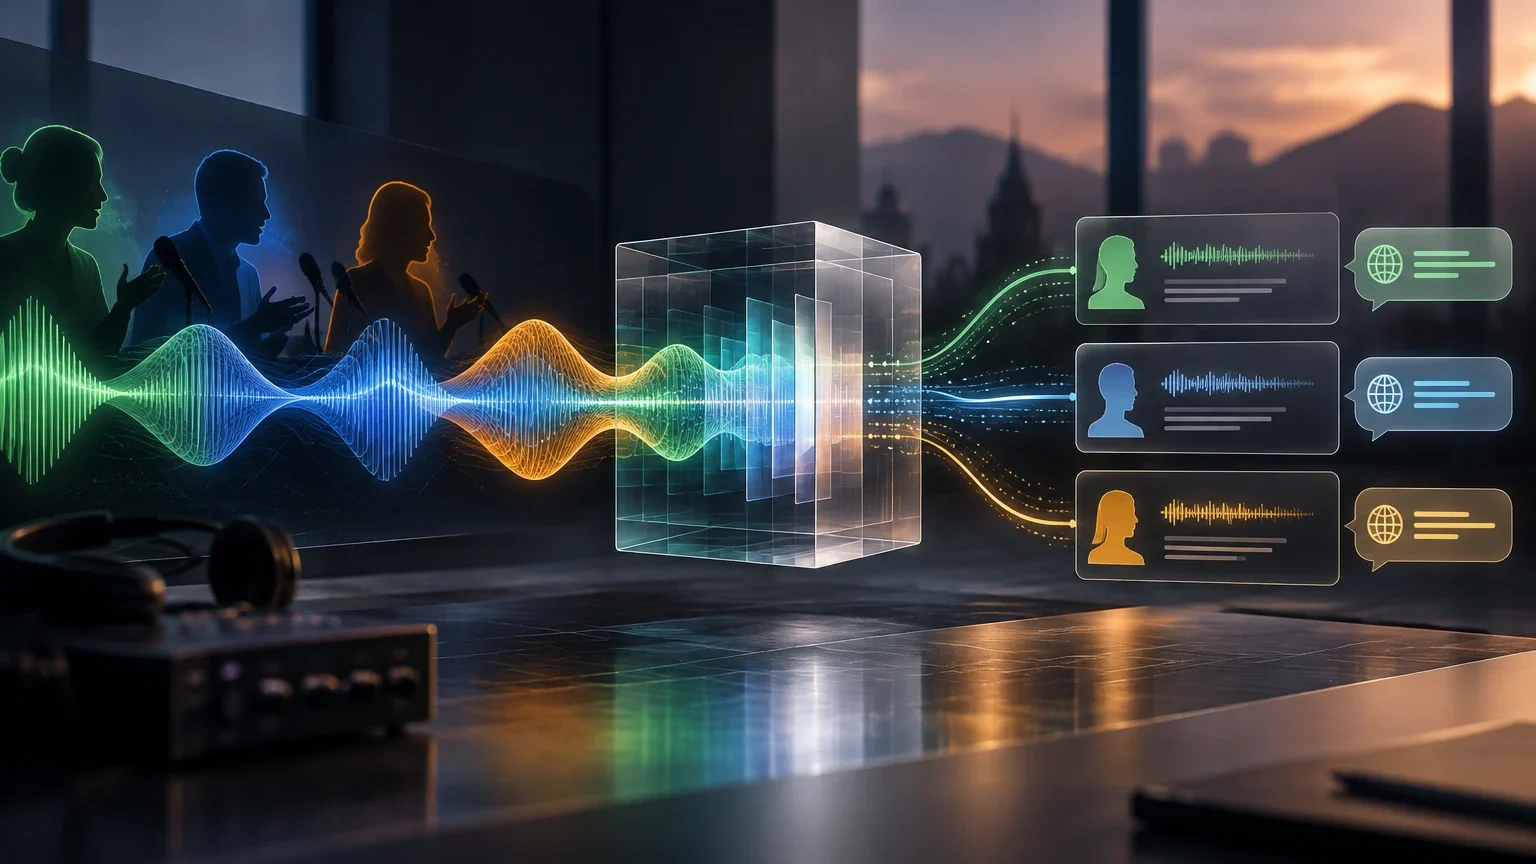
NVIDIA veröffentlicht Nemotron 3.5 Transcribe für Aufnahmen: Transkription, Übersetzung und Sprecherzuordnung
Nemotron 3.5 Transcribe vereint mehrsprachige Transkription, Übersetzung und Sprecherzuordnung in einem Modell mit offenen Gewichten für Aufnahmen von bis zu einer Stunde. NVIDIA veröffentlichte außerdem Granary v2 und Werkzeuge zur Anpassung. Die verfügbaren Leistungsdaten stammen von NVIDIA selbst.
Artikel lesen →
OpenAI aktualisiert die Model Spec – konkrete Änderungen sind noch nicht bestätigt
OpenAI kündigt eine aktualisierte Model Spec an, die das Urteilsvermögen leistungsfähigerer Modelle, menschliche Selbstbestimmung und die Orientierung an menschlichen Absichten stärken soll. Welche fünf Werte genau gemeint sind und wie sie praktisch umgesetzt werden, lässt sich anhand der verfügbaren Informationen nicht verifizieren.
Artikel lesen →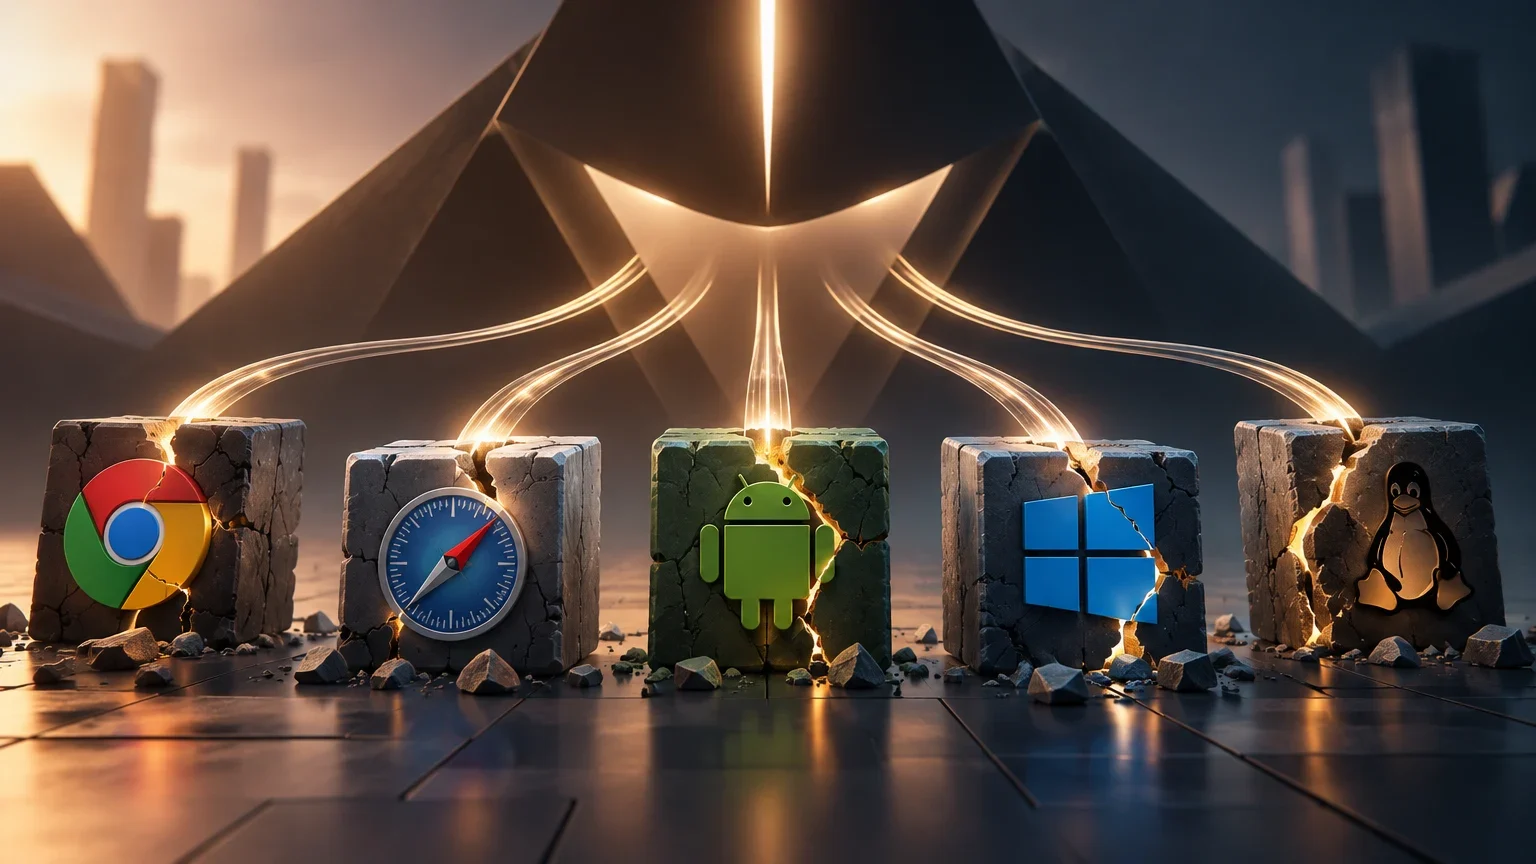
Anthropic berichtet von fünf mit Claude entdeckten Exploit-Ketten und kritischen Schwachstellen
Anthropic beschreibt, wie ein internes, nicht veröffentlichtes Forschungsmodell Schwachstellen in Chrome, Safari, Android, Windows und Linux aufspürte. Das Unternehmen gibt an, die Funde gemeldet und die Fehler seien behoben worden. Eine unabhängige Validierung der Ergebnisse legt die Veröffentlichung jedoch nicht vor.
Artikel lesen →
Epsilon automatisiert UI-Tests mit Nova Act in von AWS verwalteten Browsern
AWS beschreibt Epsilons Plattform für UI-Tests: Sie wandelt natürlichsprachliche Anweisungen in Tests um, die in verwalteten Browsern ausgeführt werden. Die verfügbaren Informationen erläutern die Architektur, liefern jedoch keine reproduzierbaren, Epsilon-spezifischen Kennzahlen und beschreiben weder die menschliche Aufsicht noch die Trennung zwischen Kunden.
Artikel lesen →
AWS Batch führt gemeinsame Kontingente und Präemption für SageMaker-Trainingsjobs ein
Mit der neuen Funktion lässt sich Rechenkapazität zwischen Teams aufteilen, ungenutzte Kapazität verleihen und die Priorität von SageMaker-Trainingsjobs festlegen. AWS nennt bis zu 20 gemeinsame Kontingente pro Jobwarteschlange; verfügbar ist die Funktion in den Regionen, in denen AWS Batch angeboten wird.
Artikel lesen →
Anthropic-Experiment: Analysten folgten bei vier Entscheidungen in 86 Prozent der Fälle der Präferenz ihres KI-Agenten
In einer Aufgabe zur Kausalanalyse wählten 50 Fachleute, die Claude Code nutzten, bei vier methodischen Entscheidungen in 86 Prozent der Fälle die Option, zu der ihr Agent gezielt hingelenkt worden war. Das Ergebnis stammt aus einem Experiment mit absichtlich verstärkten Präferenzen und ist keine allgemeine Gehorsamsquote für KI.
Artikel lesen →