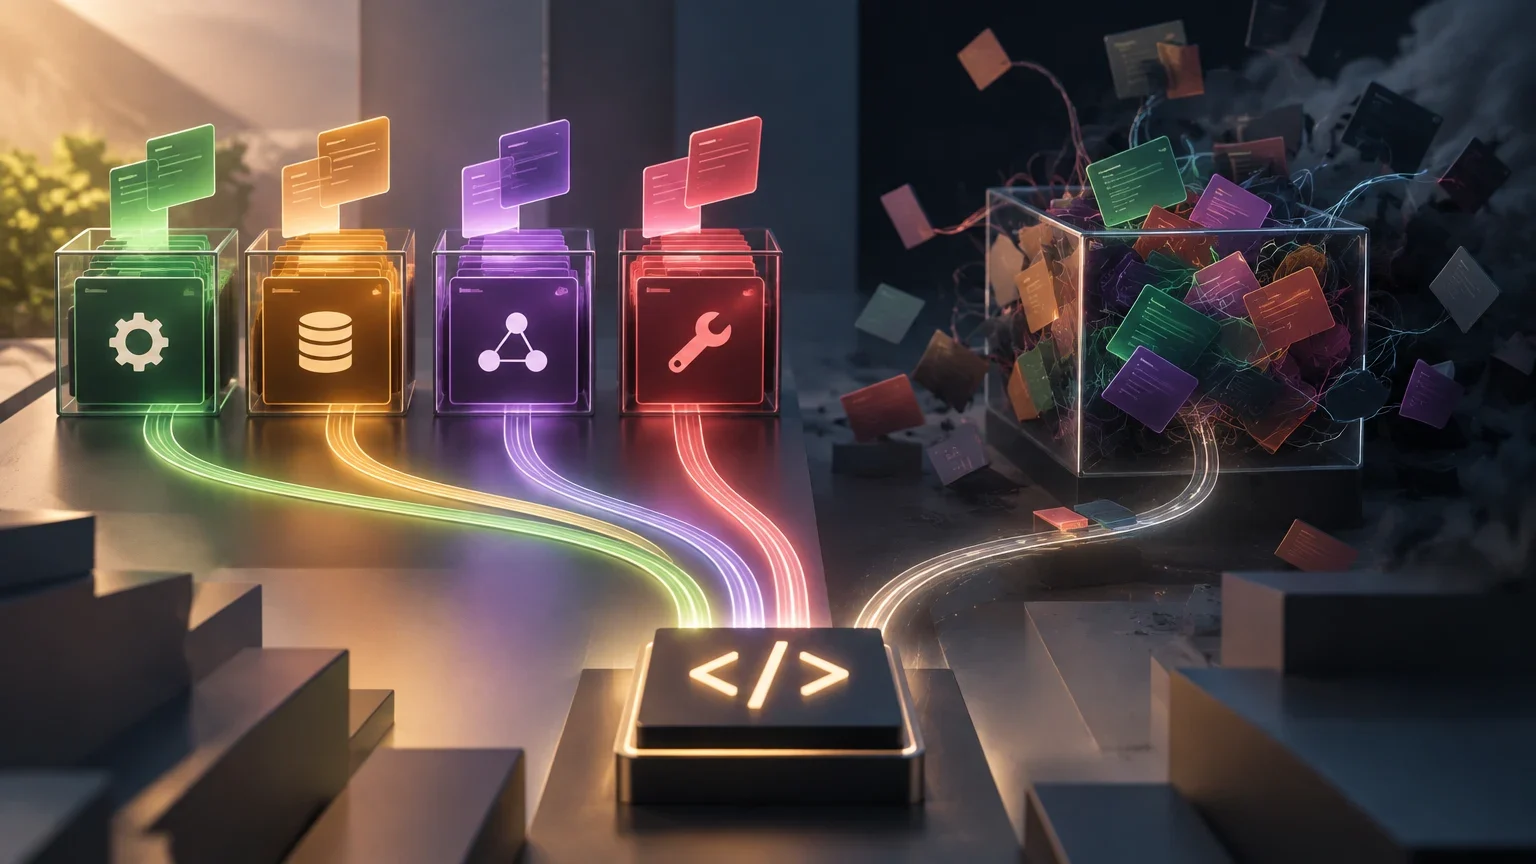
Das Problem: Eine Fähigkeit kann in einem Kontext nützen und in einem anderen stören
Ein Preprint mit dem Titel „Scope Before You Persist: Preventing Cross-Family Interference in Agent Memory“ untersucht, wie sich der Einsatz persistenter Fähigkeiten bei Sprachmodell-Agenten begrenzen lässt. Die zentrale Idee ist einfach: Eine Fähigkeit sollte für jene Aufgabenfamilie abgerufen werden, für die sie validiert wurde, statt allein deshalb für jede beliebige Aufgabe verfügbar zu sein, weil sie in einem gemeinsamen Speicher abgelegt ist.
Diese Unterscheidung ist wichtig, weil persistenter Speicher einem Agenten ermöglichen kann, Anweisungen oder Verfahren über mehrere Ausführungen hinweg beizubehalten, ohne die Modellgewichte zu verändern. Dass eine Anweisung bei einer Aufgabe geholfen hat, belegt für sich genommen jedoch nicht, dass sie sich auch für andere Aufgaben eignet. Wendet der Agent sie außerhalb des geprüften Geltungsbereichs an, kann eine lokal nützliche Änderung mit den Anforderungen einer anderen Aufgabenfamilie in Konflikt geraten. Die Arbeit untersucht diese Möglichkeit als Interferenz zwischen Aufgabenfamilien.
Der Artikel plädiert nicht dafür, jede Wiederverwendung zu verhindern. Stattdessen soll der Abrufbereich mit dem Geltungsbereich der Zertifizierung übereinstimmen: Wurde eine Fähigkeit nach einer Prüfung für eine Aufgabenfamilie akzeptiert, stützt diese Evidenz ihren Einsatz innerhalb dieser Familie – nicht zwangsläufig in allen anderen. Es handelt sich um eine Regel für den Geltungsbereich des Speichers, nicht um einen Nachweis, dass die Fähigkeit universell sicher oder wirksam ist.
Dieser Beitrag stützt sich auf die Zusammenfassung eines Preprints. Laut Eintrag ist zwar der Volltext verfügbar, doch die hier vorliegenden Informationen reichen nicht aus, um sämtliche Versuchsverfahren nachzuvollziehen. Deshalb wird zwischen den in der Zusammenfassung berichteten Ergebnissen und den offenen Fragen unterschieden.
Was der Preprint verglichen hat
Die Studie verwendet ProcStream-RSI, das in der Zusammenfassung als zwölf Runden umfassender Code-Reparatur-Stream beschrieben wird. Die untersuchten Agenten arbeiten mit einem eingefrorenen Modell: Die betrachtete Anpassung erfolgt über persistente Fähigkeiten und deren Abruf, nicht über eine Aktualisierung der Modellgewichte. Außerdem kommt Orthogonal Regression Control (ORC) zum Einsatz – ein ausführungsbasierter Kontrollmechanismus, der entscheidet, ob Änderungen an Fähigkeiten dauerhaft übernommen werden dürfen.
Der zentrale Vergleich trennt zwei Entscheidungen voneinander. Die erste lautet, ob eine Änderung an einer Fähigkeit akzeptiert wird; die zweite, an welchen Stellen sie später abgerufen werden darf. Im globalen Kontrollverfahren bleibt akzeptierter Speicher verfügbar, ohne auf die Ursprungsfamilie beschränkt zu sein. Scoped-ORC begrenzt den Abruf dagegen auf diese Familie. Laut Zusammenfassung hält ein Interventionsexperiment sowohl die vorgeschlagenen Fähigkeiten als auch die Akzeptanzentscheidungen konstant und verändert nur den Abrufbereich. Damit soll der Effekt einer Einschränkung des Einsatzbereichs isoliert werden.
Die Zusammenfassung berichtet außerdem über eine Evaluation mit 27 gepaarten Streams und randomisierter Reihenfolge. In diesem Vergleich erzielt Scoped-ORC einen höheren mittleren Nutzen auf Trajektorien als Global-ORC. Das sind zwei verwandte, aber zu unterscheidende Ergebnisse: Die Intervention mit festen Vorschlägen und Akzeptanzentscheidungen untersucht unmittelbar den Abrufbereich; die Evaluation über 27 Streams berichtet über die Leistung der verglichenen Systeme in diesen Streams.
Ablauf der beschriebenen Intervention
- 01Der Agent schlägt während des Reparatur-Streams Änderungen an Fähigkeiten vor.
- 02ORC entscheidet anhand einer ausführungsbasierten Kontrolle, welche Änderungen zur dauerhaften Speicherung akzeptiert werden.
- 03In der Intervention bleiben die Vorschläge und Akzeptanzentscheidungen unverändert.
- 04Der Abrufbereich wird variiert: global oder auf die Ursprungsfamilie der jeweiligen akzeptierten Fähigkeit begrenzt.
- 05Die Ergebnisse werden anhand zurückgehaltener Trajektorien verglichen; die Zusammenfassung enthält nicht die vollständige Formel der Metrik.
Was die Veränderung von 0,713 auf 0,816 bedeutet
In der beschriebenen Intervention steigt der mittlere Nutzen der zurückgehaltenen Trajektorien bei familienbezogenem Abruf von 0,713 mit globalem Speicher auf 0,816. Laut Zusammenfassung sinkt zugleich die Zahl schädlicher Einsätze von sechs von acht auf keinen. Diese Angaben stützen die begrenzte Schlussfolgerung, dass die Einschränkung des Einsatzes akzeptierter Fähigkeiten in dieser Intervention mit besseren Ergebnissen und weniger schädlichen Einsätzen einherging.
Die Zahl belegt weder eine allgemeine Verbesserung des Agenten noch eine Metrik, deren Bedeutung sich ohne Kenntnis ihrer Definition voraussetzen ließe. Die Zusammenfassung bezeichnet die Messgröße als „utility of hidden trajectories“ – Nutzen zurückgehaltener Trajektorien –, erläutert aber nicht, wie sie berechnet wird, welche Werte sie annehmen kann, wie diese Trajektorien erzeugt werden oder welcher Schwellenwert eine Trajektorie als nützlich einstuft. Die Veränderung beschreibt daher einen berichteten Unterschied zwischen zwei Bedingungen; sie lässt sich nicht ohne Weiteres als prozentuale Verbesserung der Qualität, Erfolgsquote oder Leistung im Produktivbetrieb deuten.
Für die 27 gepaarten Streams mit randomisierter Reihenfolge berichtet die Zusammenfassung einen mittleren Vorteil von 0,063 für Scoped-ORC gegenüber Global-ORC sowie ein Intervall von 0,037 bis 0,094. Außerdem nennt sie 63 akzeptierte Aktualisierungen gegenüber 12 und mehrere akzeptierte Aktualisierungen in 19 der 27 Streams. Für Scoped-ORC werden unter 63 Akzeptanzen null schädliche Akzeptanzen ausgewiesen. Das sind Zahlen aus dem von den Autoren berichteten Experiment und kein Beleg dafür, dass sich eine vergleichbare Rate in anderen Systemen oder Bereichen erzielen lässt.
Die globale Kontrolle erreicht 0,713 und liegt damit unter dem statischen Agenten, der im beschriebenen Vergleich 0,775 erzielt. Der Artikel führt diesen Unterschied darauf zurück, dass lokal gültige Änderungen mit nicht verwandten Aufgabenfamilien interferieren können. Diese Deutung passt zur Hypothese der Arbeit. Die Zusammenfassung bietet jedoch nicht genügend Details, um alle Faktoren, die zu diesem Unterschied beitragen, einzeln zu bewerten.
In der Zusammenfassung berichtete Ergebnisse
Die Zahlen beziehen sich auf unterschiedliche Vergleiche und sollten nicht so zusammengeführt werden, als stammten sie aus einer einzigen Intervention.
| Vergleich | Berichtetes Ergebnis | Vorsichtige Einordnung |
|---|---|---|
| Intervention mit festen Vorschlägen und Akzeptanzentscheidungen | Mittlerer Nutzen: 0,713 mit globalem Speicher und 0,816 mit familienbezogenem Abruf; schädliche Einsätze: 6 von 8 gegenüber keinem. | Isoliert die beschriebene Änderung des Abrufbereichs, doch die Zusammenfassung definiert die Metrik nicht und erläutert die acht Beobachtungen nicht im Detail. |
| 27 gepaarte Streams mit randomisierter Reihenfolge | Mittlerer Vorteil von Scoped-ORC: 0,063; berichtetes Intervall: 0,037–0,094. | Das ist das aggregierte Ergebnis für diese Streams; eine Verallgemeinerung auf andere Aufgaben folgt daraus nicht. |
| Akzeptierte Aktualisierungen in diesen Streams | 63 für Scoped-ORC und 12 für Global-ORC; mehrere Aktualisierungen in 19 von 27 Streams; für Scoped-ORC werden 0 von 63 schädlichen Akzeptanzen berichtet. | Die Zusammenfassung erläutert hier weder sämtliche Akzeptanzkriterien noch, wie eine Akzeptanz als schädlich eingestuft wird. |
| Statischer Agent gegenüber globaler Kontrolle | Berichteter Nutzen von 0,775 für den statischen Agenten und 0,713 für Global-ORC. | Stützt die Sorge vor Interferenzen in diesem Testfeld, belegt aber nicht, dass globaler Speicher generell unterlegen ist. |
Geltungsbereich und offene Fragen
Die Ergebnisse sind als experimenteller Hinweis zur Gestaltung von Agentengedächtnis vielversprechend, doch ihr Geltungsbereich ist durch die Zusammenfassung selbst begrenzt: Berichtet werden ein Code-Reparatur-Stream, Agenten mit eingefrorenem Modell und ein Vergleich über 27 gepaarte Streams. Die verfügbaren Informationen bestätigen keine Tests mit anderen Modellen, weiteren Aufgabensätzen oder anderen Anwendungsbereichen. Sie zeigen auch nicht, ob der Vorteil bestehen bliebe, wenn sich die Art der Fähigkeitsvorschläge, die Akzeptanzkriterien oder die Zusammensetzung der Aufgabenfamilien änderten.
Einen wichtigen Teil der Frage zum Interventionsdesign beantwortet die Zusammenfassung: Bei der Gegenüberstellung der Abrufbereiche seien die Vorschläge und Akzeptanzentscheidungen konstant gehalten worden. Das vollständige Protokoll beschreibt sie jedoch nicht, und es lässt sich nicht überprüfen, ob diese Bedingung für sämtliche dargestellten Vergleiche gilt. Diese Aussage sollte daher auf die Intervention beschränkt bleiben, die in der Zusammenfassung ausdrücklich so gekennzeichnet ist.
Auch die genaue Definition des Nutzens zurückgehaltener Trajektorien lässt sich anhand der vorliegenden Informationen nicht rekonstruieren. Ohne Formel, Angaben zu den Trajektorien und eine Erklärung der Analyseeinheit kann nicht vollständig beurteilt werden, wofür der Anstieg von 0,713 auf 0,816 steht. Das für die 27 Streams angegebene Intervall vermittelt Informationen zur Streuung dieses Vergleichs; die Zusammenfassung erläutert jedoch weder seine Berechnungsmethode noch die statistische Analyse vollständig.
Der Befund zeigt folglich nicht, dass jeder Agent seinen Speicher auf dieselbe Weise aufteilen sollte. Er hebt aber eine praktische Unterscheidung hervor, die weiter untersucht werden sollte: Eine Kontrollinstanz, die entscheidet, ob eine Fähigkeit hinreichend gestützt ist, klärt nicht automatisch, wo diese Fähigkeit eingesetzt werden darf. Um den Nutzen des Ansatzes über dieses Experiment hinaus einzuschätzen, wären Replikationen mit mehr Modellen und Aufgabenfamilien, transparente Metrikdefinitionen sowie Vergleiche nötig, die sowohl die Vorteile als auch die Kosten einer eingeschränkten Wiederverwendung erfassen.
Was vor einer Verallgemeinerung geprüft werden sollte
Für Teams, die Agenten entwickeln, besteht die unmittelbare Konsequenz nicht darin, ungeprüft eine bestimmte Architektur zu übernehmen. Sinnvoll wäre vielmehr, den Geltungsbereich zu dokumentieren, für den jede Fähigkeit validiert wurde, und zu prüfen, was geschieht, wenn sie außerhalb dieses Bereichs abgerufen wird. Eine aussagekräftige Evaluation sollte angeben, welche Aufgabenfamilien einbezogen werden, wie viele Aufgaben und Ausführungen untersucht wurden, was als schädliche Akzeptanz gilt und wie der Nutzen der Trajektorien berechnet wird.
Ebenso wichtig wäre die Frage, ob die Einschränkung einen nützlichen Transfer zwischen Aufgabenfamilien verhindert. Eine Fähigkeit kann tatsächlich über ihren ursprünglichen Kontext hinaus wiederverwendbar sein. So, wie die Zusammenfassung die Arbeit beschreibt, vergleicht sie die Folgen des globalen und familienbezogenen Abrufs in einem bestimmten Stream; eine allgemeingültige Regel dafür, wann der Geltungsbereich erweitert werden sollte, liefert sie nicht. Die Kosten einer strikten Regel – etwa eine Fähigkeit nicht mehr anzuwenden, die auch in einer anderen Familie funktionieren würde – werden in den bereitgestellten Informationen nicht quantifiziert.
Die belastbarste Lesart ist daher methodischer Art: Die Evidenz, auf deren Grundlage eine Änderung akzeptiert wird, und der Bereich, in dem sie eingesetzt werden darf, sind zwei verschiedene Entscheidungen. Die Arbeit deutet darauf hin, dass ihre getrennte Behandlung in dem untersuchten Testfeld Interferenzen verringern kann. Ob dieses Prinzip die Anpassungsfähigkeit auch in anderen Umgebungen verbessert, müssen weitere Replikationen und zusätzliche experimentelle Details zeigen.
Offene Fragen
- Die verfügbare Zusammenfassung erläutert weder die Berechnung des Nutzens zurückgehaltener Trajektorien noch, wie diese Trajektorien erstellt werden.
- Es liegen nicht genügend Details vor, um die acht Beobachtungen der Intervention oder die Kriterien für die Einstufung eines Einsatzes als schädlich vollständig nachzuvollziehen.
- Das Intervall von 0,037 bis 0,094 wird für den mittleren Vorteil berichtet, aber die Zusammenfassung erklärt nicht, mit welcher Methode es berechnet wurde.
- Die beschriebene Evidenz beschränkt sich auf ProcStream-RSI und bestätigt keine Replikation mit anderen Modellen, Aufgaben-Benchmarks oder Anwendungsbereichen.
- Die Zusammenfassung bestätigt, dass Vorschläge und Akzeptanzentscheidungen in der bezeichneten Intervention konstant gehalten wurden; das vollständige experimentelle Protokoll lässt sich daraus jedoch nicht überprüfen.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen