Welche Frage diese Bewertung beantworten soll
Ein System zur Retrieval-Augmented Generation (RAG) erhält abgerufene Dokumente und nutzt sie als Kontext für seine Antworten. Der hier vorgeschlagene Test untersucht eine eng umrissene Frage: Kann Command R 08-2024, wenn es einen festgelegten Satz von Dokumentauszügen erhält, zwischen Aussagen unterscheiden, die durch diese Auszüge gestützt werden, Aussagen, denen sie widersprechen, und Fragen, die sie nicht beantworten lassen? Es geht weder darum, die gesamten sprachlichen Fähigkeiten des Modells zu messen, noch darum, eine vom Anbieter veröffentlichte Punktzahl zu reproduzieren.
Analyseeinheit ist eine Antwort, die mit einem genau beschriebenen Dokumentkontext erzeugt wird. Getrennt bewertet werden die inhaltliche Richtigkeit der Antwort, die Beleglage für ihre Aussagen, die Qualität der Zitate, der Umgang mit Widersprüchen und die Entscheidung, sich einer Antwort zu enthalten. Die Trennung dieser Dimensionen verhindert, dass eine flüssige Antwort oder ein aggregierter Wert unterschiedliche Fehlerarten verdeckt: etwa eine zufällig richtige Schlussfolgerung, ein Zitat, das zwar das Thema erwähnt, aber die Aussage nicht belegt, oder eine Enthaltung trotz explizit vorhandener Information.
Der Untersuchungsumfang schließt außerdem allgemeine Schlussfolgerungen über sämtliche Versionen von Command R, über Command R+ oder über die Leistung eines vollständigen Produktionssystems aus. Ein Test mit einem bestimmten Korpus, konkreten Anweisungen und festgelegten Parametern beschreibt genau diese Bedingungen. Für sich genommen erlaubt er keine Aussage darüber, ob sich das Modell bei anderen Dokumenten, Nutzern, Abrufkonfigurationen oder Nutzungsbedingungen genauso verhält.
Das Modell vor dem Test eindeutig identifizieren
Der Produktname allein reicht nicht aus, um reproduzierbar festzustellen, welches System eine Antwort erzeugt hat. Das Protokoll sollte die genaue Modellkennung, den Zugangsweg, das Datum jedes Durchlaufs und die verfügbare Konfiguration enthalten. Außerdem sollten die gesendete Anfrage und – sofern der Zugangsweg dies ermöglicht – die Generierungsparameter sowie zurückgegebene Metadaten gespeichert werden. Wenn ein Anbieter das Modell hinter einem Namen austauscht, ohne eine bestimmte Revision festlegen zu lassen, muss diese Einschränkung als Teil der Methode dokumentiert werden.
Die Dokumentation von Cohere zum August-Update nennt Command R 08-2024 und beschreibt Verbesserungen bei mehrsprachiger Retrieval-Augmented Generation und der Verwendung von Tools. Diese Beschreibung dokumentiert, was der Anbieter über das Update angibt, ist aber kein unabhängiger Nachweis für die Messwerte des hier vorgeschlagenen Protokolls. Ein Modelleinartrag oder eine Anbieterbewertung darf daher das kontrollierte Experiment, das hier skizziert wird, nicht ersetzen.
Die verfügbare Oracle-Dokumentation führt cohere.command-r-08-2024 für ihren Dienst auf und kennzeichnet das Modell als veraltet. Das weist auf eine Einschränkung dieses Zugangswegs hin, beweist aber nicht, dass die Modellkennung über andere Wege nicht verfügbar ist. Das Repository von Cohere Labs wiederum führt eine Forschungsfassung mit offenen Gewichten auf. Vor der Durchführung müsste direkt geprüft werden, welches Artefakt oder welcher Dienst verwendet wird, welche konkrete Version angeboten wird und welche Nutzungsbedingungen gelten. Die bereitgestellten Quellen reichen nicht aus, um die aktuelle Verfügbarkeit oder sämtliche Betriebsparameter zu bestätigen.
Mindestangaben zu Identität und Konfiguration
Für jeden Durchlauf oder jede Gruppe von Durchläufen eine Zeile ausfüllen. Kann ein Feld nicht festgelegt oder überprüft werden, ist es als unbekannt zu kennzeichnen, statt es durch Schlussfolgerungen zu ergänzen.
| Angabe | Zu dokumentieren | Warum das wichtig ist |
|---|---|---|
| Modell | Name, genaue Kennung und – sofern verfügbar – Revision | Verhindert, dass Ergebnisse einer anderen oder nicht näher bestimmten Version zugeschrieben werden. |
| Zugang | Verwendeter Dienst oder verwendetes Artefakt sowie Abrufdatum | Ermöglicht die Beschreibung des Zugangswegs und möglicher Verfügbarkeitsbeschränkungen. |
| Eingabe | Anweisung, Frage und übergebene Auszüge einschließlich ihrer Reihenfolge | Macht sichtbar, welchen Kontext das Modell tatsächlich erhalten hat. |
| Generierung | Verfügbare Parameter und verwendete Werte | Hilft, Unterschiede zwischen Durchläufen einzuordnen. |
| Vorfälle | Fehler, leere Antworten, Beschränkungen oder beobachtete Änderungen | Verhindert, dass Fehlschläge stillschweigend ausgeschlossen werden. |
Einen Korpus mit drei Bedingungen erstellen
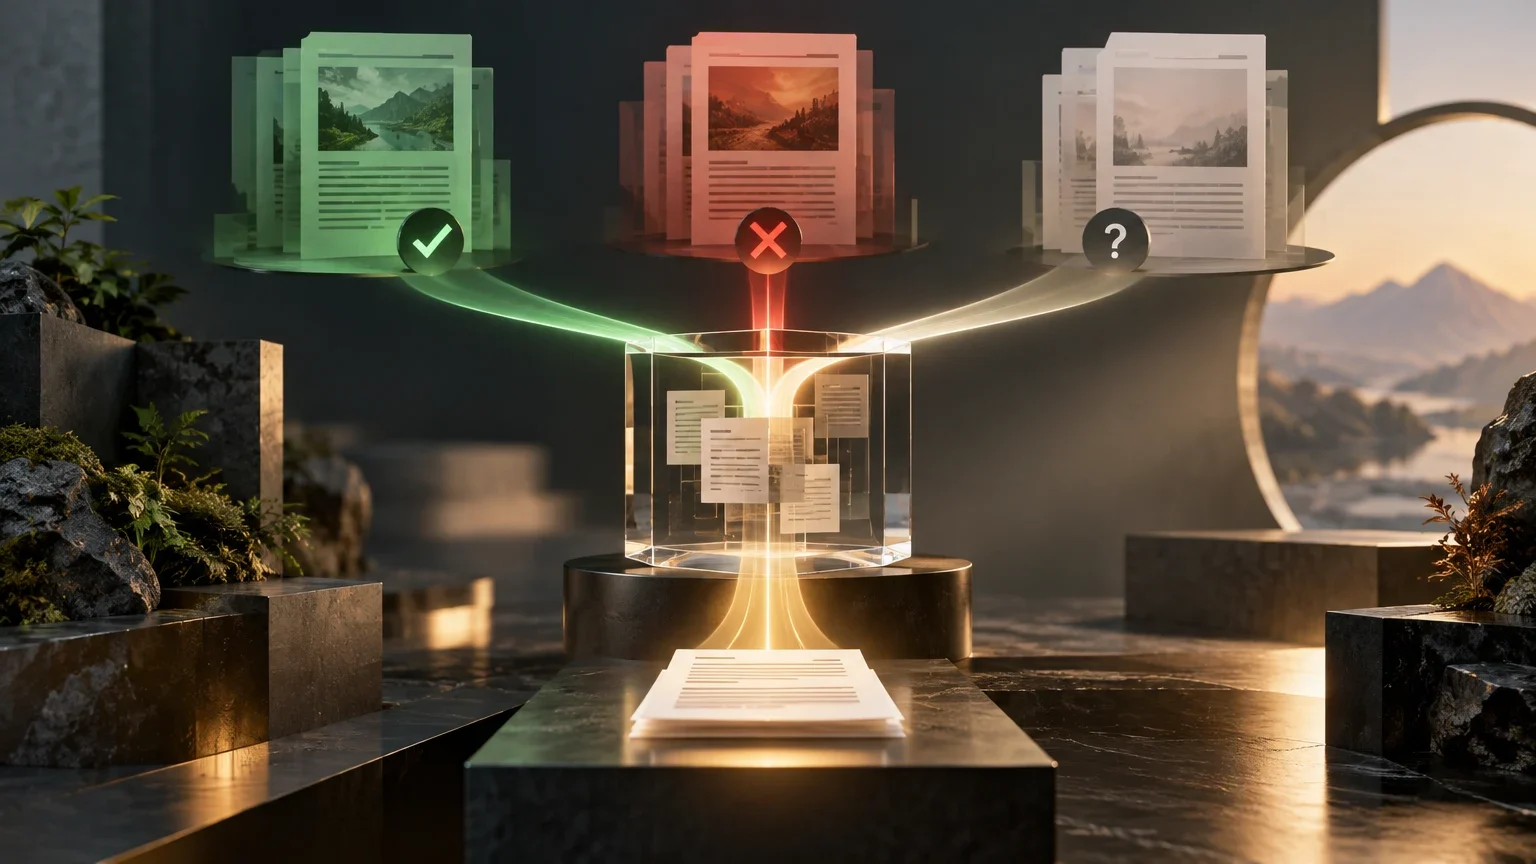
Der Testsatz sollte von Anfang an drei getrennte Fallgruppen enthalten. Bei Fällen mit ausreichender Evidenz lässt sich eine Antwort aus einer oder mehreren eindeutig auffindbaren Passagen ableiten. Bei widersprüchlichen Fällen stützen zwei oder mehr Dokumente miteinander unvereinbare Versionen einer relevanten Angabe. Bei Fällen ohne ausreichende Evidenz erlaubt das bereitgestellte Material keine begründete Antwort, auch wenn die Frage plausibel klingt. Diese dritte Kategorie darf nicht mit einem Dokument verwechselt werden, das lediglich schwer zu finden ist: Das Fehlen einer Antwort muss im für den Test festgelegten Korpus überprüft werden.
Sinnvoll sind kontrollierte Dokumente mit dokumentierter Herkunft und Datierung sowie Fragen, die formuliert werden, bevor die Antworten des Modells vorliegen. Für jede Frage sollte eine prüfende Person vorab ermitteln, welche Passagen sie stützen, ob ein Konflikt besteht und welche Informationen fehlen. Diese Prüfung legt die Referenzannotation fest und verringert das Risiko, eine unerwartete Antwort im Nachhinein allein deshalb als richtig einzustufen, weil sie plausibel klingt.
Der Korpus sollte die zu untersuchenden Anwendungsfälle abbilden, ohne unbeabsichtigte Unterschiede zwischen den Kategorien einzuführen. Sind die widersprüchlichen Fälle beispielsweise wesentlich länger oder anders formatiert als Fälle mit ausreichender Evidenz, könnten die Ergebnisse neben der Fähigkeit, Konflikte zu erkennen, auch diese Unterschiede widerspiegeln. Eine Übersicht zur Zusammensetzung sollte die Zahl der Fragen je Bedingung, Anzahl und Länge der Dokumente, Sprachen, Datumsangaben und Auswahlkriterien nennen. Diese Entscheidungen dürfen nicht als repräsentative Stichprobe sämtlicher interner Dokumentation ausgegeben werden.
Testsatz vorbereiten und prüfen
- 01Dokumentbereich festlegen und Herkunft sowie Datum jedes Dokuments dokumentieren.
- 02Fragen formulieren, deren Antworten auffindbar sind, deren Belege miteinander in Konflikt stehen oder die sich anhand des Korpus nicht begründen lassen.
- 03Jedem Fall eine Bedingung zuordnen und die relevanten Passagen beziehungsweise den Grund für die unzureichende Evidenz festhalten.
- 04Die Klassifizierung vorab von Menschen prüfen lassen, ohne ihnen die Modellantworten zu zeigen.
- 05Unstimmigkeiten vor der Ausführung klären oder dokumentieren und eine Version des Testsatzes für das Experiment einfrieren.
Abruf, Anweisungen und Durchführung festlegen
Für die Bewertung des Modellverhaltens angesichts einer bestimmten Evidenz müssen alle Komponenten dokumentiert werden, die den Kontext beeinflussen. Wird die Frage zusammen mit bereits ausgewählten Auszügen übergeben, wird die Antwort des Modells unter diesen Auszügen untersucht – nicht die Qualität einer Suchkomponente. Kommt ein Abrufsystem zum Einsatz, müssen außerdem die Anfrage, die Kandidatendokumente, ihre Reihenfolge, die Zahl der Auszüge und die Auswahlregel gespeichert werden. Ohne diese Unterscheidung könnte ein Fehler des Abrufsystems dem generativen Modell zugeschrieben werden oder umgekehrt.
Die Anweisung sollte für alle Fälle gleich bleiben, es sei denn, ein kontrollierter Vergleich verändert absichtlich eine einzelne Variable. Sie sollte erklären, wie Evidenz darzustellen ist und was bei fehlenden oder widersprüchlichen Belegen zu tun ist. Die Aufforderung zur Enthaltung erfordert besondere Sorgfalt: Eine unklare Anweisung kann ebenso sehr die Interpretation des Prompts messen wie die Fähigkeit, unzureichende Evidenz zu erkennen. Deshalb sollte ihr genauer Wortlaut veröffentlicht und vermieden werden, sie nach Einsicht in die Ausgaben fallweise anzupassen.
Der Plan muss festlegen, wie viele Durchläufe je Frage erfolgen. Lassen sich bestimmte Parameter über den Zugangsweg weder kontrollieren noch ermitteln, ist dies zu vermerken. Wiederholte Durchläufe können helfen, die Variabilität zu untersuchen, machen den Testsatz aber nicht automatisch repräsentativ. Fehlgeschlagene Ausgaben und Antworten, die das verlangte Format nicht einhalten, müssen ebenfalls gespeichert werden, statt sie stillschweigend zu entfernen.
Jede Bewertungsdimension getrennt messen
Bei der Prüfung der sachlichen Richtigkeit wird bewertet, ob die Antwort mit dem vereinbar ist, was sich aus dem Korpus und der geprüften Referenz ableiten lässt. Die Prüfung der Beleglage stellt eine andere Frage: Wird jede inhaltlich relevante Aussage der Antwort durch die bereitgestellten Dokumente gestützt? Eine Antwort kann die Hauptangabe richtig wiedergeben und zugleich Details hinzufügen, für die der Korpus keine Belege enthält. Ein einziges Label wie „richtig“ würde dieses Problem verdecken.
Bei der Bewertung von Zitaten ist zu prüfen, ob die angeführte Passage die konkrete zugehörige Aussage stützt. Eine thematische Übereinstimmung genügt nicht: Ein Zitat, in dem eine Rückgabe erwähnt wird, belegt nicht zwangsläufig die angegebene Frist. Enthält die Ausgabe keine expliziten Verweise auf Passagen, ist diese Dimension als nicht bewertbar zu kennzeichnen oder an das vereinbarte Ausgabeformat anzupassen. Sie darf nicht so bewertet werden, als lägen Zitate vor.
Bei der Bewertung des Umgangs mit Widersprüchen wird gemessen, ob die Antwort den Konflikt erkennt, die relevanten Versionen benennt und eine davon nicht ohne Grundlage in den Dokumenten als unbestreitbar darstellt. Die Bewertung angemessener Enthaltung muss zwischen einer Enthaltung bei fehlender Grundlage und einer unnötigen Antwortverweigerung trotz vorhandener Evidenz unterscheiden. Für jede Kategorie lassen sich Raten oder Fallzahlen berichten, stets zusammen mit den Nennern, den Annotationsregeln und Beispielen. Es empfiehlt sich nicht, alle Dimensionen ohne Begründung ihrer Gewichtung auf eine einzige Punktzahl zu reduzieren.
Vorgeschlagene Bewertungsrichtlinie
Die Richtlinie auf jede Antwort anwenden und die Belege festhalten, die das jeweilige Label begründen. Skalen können vor dem Test angepasst werden, aber nicht, nachdem die Ergebnisse bekannt sind.
| Dimension | Frage an die annotierende Person | Zu erkennender Fehler |
|---|---|---|
| Sachliche Richtigkeit | Ist die Antwort mit der anhand des Korpus ermittelten Referenz vereinbar? | Falsche Angabe oder Schlussfolgerung, die von der verfügbaren Evidenz nicht gestützt wird. |
| Beleglage | Ist jede inhaltlich relevante Aussage durch die Auszüge gestützt? | Hinzugefügte Details ohne dokumentarische Grundlage. |
| Zitat | Stützt die zitierte Passage die konkrete Aussage? | Thematisches, unvollständiges oder für die Schlussfolgerung irrelevantes Zitat. |
| Widerspruch | Erkennt die Antwort unvereinbare Versionen und stellt sie den Konflikt angemessen dar? | Stillschweigende Auswahl einer Version oder unbegründete Darstellung als sicher. |
| Enthaltung | Antwortet das Modell bei vorhandener Grundlage und enthält es sich, wenn sie fehlt? | Erfindungen bei fehlender Evidenz oder unnötige Verweigerung trotz ausreichender Evidenz. |
Annotation, Kontrollen und Kontamination
Die Annotation sollte schriftlich festgelegten Regeln folgen, die vor der Prüfung der Ausgaben erstellt wurden. Wenn es praktikabel ist, können zwei Personen unabhängig voneinander bewerten, ohne zu wissen, welche Konfiguration die jeweilige Antwort erzeugt hat. Abweichende Bewertungen sollten nicht in einem undurchsichtigen Durchschnitt verschwinden: Es ist festzuhalten, bei welchen Dimensionen Uneinigkeit besteht, wie die einzelnen Fälle geklärt werden und welche Beispiele mehrdeutig bleiben. Außerdem sollten sowohl die ursprünglichen Antworten als auch die für die Analyse normalisierte Fassung gespeichert werden; jede Transformation ist zu erläutern.
Eine mögliche Kontamination des Testsatzes ist von der Qualität des Abrufs zu unterscheiden. Fragen oder Dokumente, die bereits in Trainingsdaten enthalten waren, könnten eine Antwort beeinflussen. Die hier verfügbaren Quellen erlauben jedoch keine Feststellung, ob dies bei einem konkreten Testsatz der Fall war. Zu dokumentieren sind die bekannten Angaben zur Herkunft der Dokumente und zum Erstellungsdatum der Fragen sowie nicht überprüfbare mögliche frühere Expositionen. Ohne ausreichende Belege darf nicht behauptet werden, ein Testsatz sei frei von Kontamination.
Zu den Kontrollen gehört auch die Prüfung, ob Referenzlabels die Antwort nicht unbeabsichtigt bereits in der Frage verraten, ob Auszüge konsistent übergeben werden und ob Zugriffsfehler nicht mit Modellantworten verwechselt werden. Werden Prompt, Abruf oder Korpus während der Studie verändert, ist die neue Bedingung als eigene Variante zu behandeln und zu dokumentieren. Vergleichbarkeit setzt voraus, dass sich nachvollziehen lässt, was geändert wurde.
Vergleichbarkeit und Grenzen der Interpretation
Ein Test dieser Art beschreibt das beobachtete Verhalten unter einer bestimmten Konfiguration, mit einem bestimmten Korpus und konkreten Anweisungen. Daraus lässt sich weder ableiten, dass Command R 08-2024 für jedes RAG-System geeignet ist, noch lassen sich damit ohne Weiteres Modelle vergleichen, die mit anderen Dokumenten, Prompts, Zugängen oder Bewertungsrichtlinien getestet wurden. Ein direkter Vergleich mit Command R+ würde eine parallele Bewertung mit identifizierten Versionen und gleichwertigen Bedingungen erfordern. Das hier beschriebene Protokoll liefert selbst keine Vergleichsergebnisse.
Aussagen des Anbieters zu einem Update können helfen, die beabsichtigten Verbesserungsbereiche einzuordnen, dürfen aber nicht in Ergebnisse dieses Experiments umgedeutet werden. Ebenso beschreibt die Verfügbarkeit über einen Zugangsweg nicht zwangsläufig die Verfügbarkeit über andere Wege. Werden offene Gewichte und ein verwalteter Dienst eingesetzt, sind sie als unterschiedliche Konfigurationen zu behandeln, es sei denn, es lässt sich überprüfen, dass sie dasselbe Artefakt und vergleichbare Bedingungen verwenden.
Auch die Verallgemeinerbarkeit hängt vom Korpusdesign ab. Ein kleiner oder auf einen Dokumentbereich konzentrierter Testsatz kann beim Erkennen von Fehlern und bei der Optimierung einer Konfiguration nützlich sein. Er rechtfertigt jedoch kein Versprechen, dass sich das Modell in anderen Fachbereichen, Sprachen oder Dokumenttypen gleich verhält. Der Bericht sollte Unsicherheit und Abdeckung vermitteln, nicht nur das auffälligste Ergebnis. Kann das genaue Modell nicht identifiziert und festgelegt werden, ist es methodisch redlich, keine dem Modell zugeschriebenen Punktzahlen zu veröffentlichen.
So veröffentlichen, dass andere den Test wiederholen können
Ein reproduzierbarer Bericht sollte das Protokoll, Modellkennung und Zugangsweg, Ausführungsdatum, den genauen Wortlaut der Anweisungen, die dokumentierte Konfiguration, das Kontextformat, die Fragen, die Annotationsregeln und nach Dimensionen aufgeschlüsselte Ergebnisse enthalten. Außerdem ist zu erläutern, wie ungültige Ausgaben, Dienstfehler und Meinungsverschiedenheiten zwischen Prüfenden behandelt wurden. Kann ein Element nicht geteilt werden, ist genau anzugeben, welches Element aus welchem Grund fehlt. Fehlende Artefakte dürfen nicht so dargestellt werden, als sei die Methode vollständig reproduzierbar.
Vor der Veröffentlichung von Dokumenten oder Anfragen muss geprüft werden, ob Rechte, Vertraulichkeit oder andere Bedingungen einer Offenlegung entgegenstehen. Können die Materialien nicht geteilt werden, sind mögliche Alternativen eine Beschreibung des Aufbaus des Testsatzes, klar als synthetisch gekennzeichnete Beispiele oder eine kontrollierte Evaluation. Solche Alternativen ersetzen die Veröffentlichung der Daten nicht automatisch: Sie schränken die Möglichkeit einer unabhängigen Wiederholung ein. Diese Einschränkung muss ausdrücklich genannt werden.
Für ein Team sollte der Test als diagnostischer Filter dienen, nicht als automatische Freigabe für einen Einsatz. Gibt das System Antworten mit Zitaten aus, ist zu prüfen, ob die Zitate die jeweiligen Aussagen tatsächlich stützen. Besteht das Hauptrisiko in veralteten oder widersprüchlichen Dokumenten, müssen solche Fälle mit den eigenen Materialien und geeigneten Regeln zum Umgang mit Konflikten getestet werden. Und wenn sichere Enthaltung wichtig ist, muss vor der Auswertung festgelegt werden, welches Verhalten im jeweiligen Fachbereich akzeptabel ist.
Checkliste vor der Veröffentlichung von Ergebnissen
- 01Die genaue Modellkennung bestätigen und Unsicherheiten bezüglich Revision oder Zugangsweg beschreiben.
- 02Den Korpus veröffentlichen oder präzise erklären, welche Einschränkungen die Weitergabe verhindern.
- 03Prompts, Konfiguration, Fragen, Kontextformat und Annotationsregeln beifügen.
- 04Jede Metrik getrennt mit ihrem Nenner, den Einschränkungen und Fehlerbeispielen berichten.
- 05Offenlegen, was zu Zugang, Parametern, möglicher vorheriger Exposition oder Reproduzierbarkeit nicht überprüft werden konnte.
Fazit: Ein Protokoll ist kein Ergebnis
Die hilfreiche Frage lautet nicht, ob ein Modell abstrakt „gut zitiert“, sondern wie es mit festgelegter Evidenz und unter Bedingungen umgeht, die andere prüfen können. Die Trennung zwischen ausreichender Evidenz, Widerspruch und fehlender Evidenz ermöglicht unterschiedliche Kontrollen für die jeweiligen Situationen. Werden Richtigkeit, Beleglage, Zitatqualität und Enthaltung getrennt betrachtet, können weder eine einzelne Punktzahl noch eine überzeugend formulierte Antwort relevante Fehler so leicht verdecken.
Die geprüften Quellen identifizieren Command R 08-2024 in der Dokumentation von Cohere und in einem Repository von Cohere Labs. Außerdem weisen sie darauf hin, dass die herangezogene Oracle-Dokumentation das Modell für diesen Dienst als veraltet kennzeichnet. Sie belegen weder, dass der vorgeschlagene Test durchgeführt wurde, noch bestätigen sie die aktuelle Verfügbarkeit über alle Zugangswege oder liefern unabhängige Ergebnisse zu Zitaten, Widersprüchen oder Enthaltung. Dieser Artikel stellt daher den Entwurf und die Gültigkeitsbedingungen vor, ohne dem Modell Punktzahlen zuzuschreiben.
Ein Team, das das Protokoll auf interne Dokumentation übertragen möchte, muss einen eigenen geprüften Testsatz erstellen, festlegen, was als belegte Antwort gilt, und entscheiden, welche Unsicherheiten akzeptabel sind. Erst nach Überprüfung der Version und Ausführung unter den dokumentierten Bedingungen ist es sinnvoll, Ergebnisse zu berichten. Auch dann beschränken sich die Schlussfolgerungen auf die untersuchte Konfiguration und den verwendeten Korpus.
Offene Fragen
- Der aktuelle Zugriff auf die genaue Kennung von Command R 08-2024 und die über die einzelnen Zugangswege festlegbaren Parameter wurden nicht überprüft.
- Die vorliegenden Oracle-Unterlagen kennzeichnen das Modell in OCI als veraltet; daraus folgt nicht, dass es über andere Zugangswege nicht verfügbar ist.
- Das Protokoll wurde nicht ausgeführt. Es liegen daher keine experimentellen Ergebnisse vor, die dem Modell zugeschrieben werden könnten.
- Anhand der bereitgestellten Quellen lässt sich nicht feststellen, ob Dokumente oder Fragen eines bestimmten Testsatzes in Trainingsdaten enthalten waren.
- Ob Korpus, Fragen und Konfigurationen veröffentlicht werden können, hängt von Rechten, Vertraulichkeit und Nutzungsbedingungen ab, die im jeweiligen Einzelfall geprüft werden müssen.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen