Definition in einem Satz
Beobachtbare Fähigkeit, Informationen, Einschränkungen und Zwischenschritte zu kombinieren, um eine Aufgabe zu lösen.
Definition und Konzepte, die nicht verwechselt werden dürfen
Die Schlussfolgerung (Reasoning) in Sprachmodellen wird als die beobachtbare Fähigkeit definiert, Informationen, Einschränkungen und Zwischenschritte zu kombinieren, um eine komplexe Aufgabe zu lösen. Im Gegensatz zur einfachen Vorhersage des nächsten Wortes bewertet ein schließendes Modell die Struktur der Aufgabe, identifiziert kausale Zusammenhänge und baut eine Kette logischer Schritte auf, die zu einem Schluss führt. Diese Fähigkeit ist in Aufgaben essenziell, bei denen nicht nur das Endergebnis, sondern auch die Gültigkeit des Weges dorthin von Bedeutung ist.
Es ist entscheidend, Schlussfolgerung von anderen verwandten Konzepten zu unterscheiden. Sie darf nicht mit faktischem Gedächtnis verwechselt werden, das die Abrufung von während des Trainings gespeicherten Daten ist, noch mit statistischer Interpolation, die Muster basierend auf der Ko-Okkurrenzfrequenz vervollständigt. Auch ist sie nicht synonym mit der Gedankenkette (Chain-of-Thought), die eine Prompting-Technik oder ein spezifischer Generierungsmechanismus ist, während Schlussfolgerung die zugrunde liegende Fähigkeit darstellt. Schließlich unterscheidet sich Schlussfolgerung von Inferenz im strengen logischen Sinne; aktuelle Modelle führen keine deterministischen formalen Regeln aus, sondern generieren Token-Sequenzen, die die Struktur einer gültigen Schlussfolgerung imitieren, was eine inhärente Schicht der Unsicherheit einführt.
Unterschiede zwischen Schlüsselkonzepten
Vergleichstabelle zur Unterscheidung von Schlussfolgerung und benachbarten Konzepten.
| Konzept | Kurze Definition | Hauptunterschied zur Schlussfolgerung |
|---|---|---|
| Schlussfolgerung | Prozess der Ableitung von Schlüssen durch logische Zwischenschritte. | Ist die Ziel-Fähigkeit dieses Eintrags. |
| Gedankenkette (CoT) | Technik zur Generierung oder Erzwingung sichtbarer Zwischenschritte. | Ist ein Implementierungsmechanismus, nicht die Fähigkeit an sich. |
| Inferenz | Formale oder statistische logische Deduktion. | Schlussfolgerung in LLMs ist probabilistisch, nicht deterministisch. |
| Faktisches Gedächtnis | Abruf von vorhandener Information. | Impliziert keine logische Transformation der Information. |
Funktionsweise Schritt für Schritt
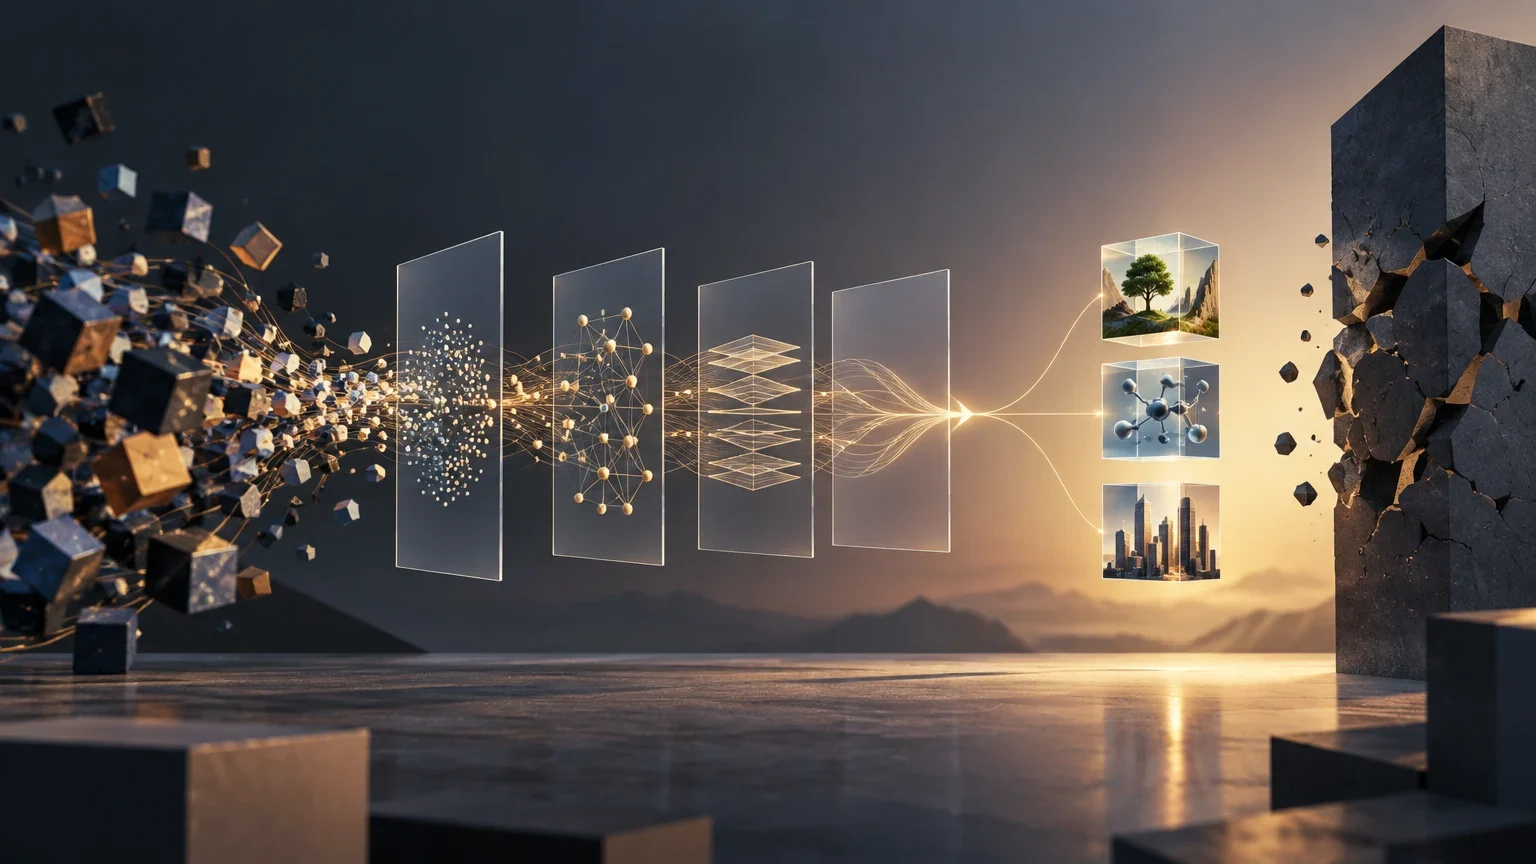
Die Funktionsweise der Schlussfolgerung in modernen Sprachmodellen, insbesondere in Large Reasoning Models (LRMs), folgt einem strukturierten Prozess, der sich von der Standardgenerierung unterscheidet. Zuerst analysiert das Modell die Eingabe, um die erforderliche Logikart zu identifizieren, sei es Deduktion, Induktion oder Abduktion. Anschließend zerlegt es das Problem in handhabbare Teilprobleme. Anstatt die Endantwort sofort zu generieren, erzeugt das Modell eine Sequenz von Zwischen-Tokens, oft als 'Thinking-Tokens' bezeichnet, die den Zustand der teilweisen Lösung darstellen.
Während dieser Zwischenphase kann das Modell verschiedene Lösungspfade erkunden, die Kohärenz seiner Schritte überprüfen und Fehler korrigieren, bevor es die Endantwort ausgibt. Dieser Prozess verbraucht mehr Rechenressourcen und Inferenzzeit als die direkte Generierung. Die Qualität der Schlussfolgerung hängt von mehreren Faktoren ab: der Modellgröße, der Vielfalt der Trainingsdaten, die explizite logische Strukturen enthalten, und Feinabstimmungstechniken, die die logische Konsistenz stärken. Die Beweise deuten darauf hin, dass dieses Verhalten aus der Interaktion zwischen Architektur, Daten und Training entsteht, nicht aus einem isolierten logischen Modul.
Schlussfolgerungsfluss in einem LRM
Typischer sequenzieller Prozess eines Large Reasoning Models.
- 01Eingabeanalyse: Identifizierung von Einschränkungen und Logikart.
- 02Zerlegung: Aufteilung des Problems in logische Zwischenschritte.
- 03Generierung von Gedankenspuren: Erstellung von Zwischen-Tokens, die die Logik dokumentieren.
- 04Interne Verifikation: Überprüfung der Kohärenz der generierten Schritte.
- 05Finale Synthese: Formulierung der definitiven Antwort basierend auf der Spur.
Drei ausgearbeitete Beispiele in relevanten Bereichen
Um die praktische Anwendung der Schlussfolgerung zu veranschaulichen, werden drei Beispiele in verschiedenen Bereichen vorgestellt. Im mathematischen Bereich muss ein Modell ein Optimierungsproblem mit mehreren Variablen lösen. Anstatt die Antwort zu raten, generiert das Modell eine Sequenz von Gleichungen, wendet Einschränkungen schrittweise an und verifiziert die Gültigkeit jeder algebraischen Transformation. Wenn es eine Inkonsistenz in einem Zwischenschritt erkennt, kann es zurückgehen und eine Alternative ausprobieren, etwas, das ein Standardmodell nicht explizit tun würde.
In der Softwareentwicklung wird Schlussfolgerung auf die Fehlersuche in komplexem Code angewendet. Das Modell analysiert den Aufrufstapel, identifiziert die Ursache eines Fehlers und schlägt eine Korrektur vor, die nicht nur das Symptom löst, sondern auch erklärt, warum die Lösung im Systemkontext gültig ist. Schließlich im Datenanalysebereich muss das Modell einen mehrdeutigen Datensatz interpretieren. Hier impliziert Schlussfolgerung, kausale Beziehungen aus Korrelationen abzuleiten, alternative Hypothesen zu berücksichtigen und zu rechtfertigen, warum eine Interpretation wahrscheinlicher ist als eine andere, wobei jede Inferenz dokumentiert wird, um eine menschliche Prüfung zu ermöglichen.
Wie das Ergebnis bewertet wird
Die Bewertung der Qualität der Schlussfolgerung ist komplexer als die Bewertung der Genauigkeit einer Endantwort. Traditionelle Benchmarks wie GSM8K oder MMLU messen oft nur die Richtigkeit des Ergebnisses, was verdecken kann, ob das Modell tatsächlich geschlossen hat oder nur ein gemerktes Muster abgerufen hat. Ein Modell kann die richtige Antwort über einen statistischen Shortcut erhalten, was keine robuste Schlussfolgerungsfähigkeit beweist. Daher sollte sich die Bewertung auf die Struktur und Kohärenz der Schlussfolgerungsspur konzentrieren, nicht nur auf das Ergebnis.
Fortgeschrittene Methodologien umfassen die Analyse der internen Konsistenz, bei der überprüft wird, ob die Zwischenschritte logisch gültig sind und keine Widersprüche enthalten. Es werden auch Störungstechniken verwendet, bei denen die Eingabe leicht verändert wird, um zu sehen, ob das Modell die Kohärenz seiner Schlussfolgerung beibehält oder zusammenbricht. Darüber hinaus wird die Verwendung von Prozess-Belohnungsmodellen (Process Reward Models) empfohlen, die jeden Schritt einzeln bewerten, anstatt nur das Endergebnis. Menschliche Bewertung bleibt für Fälle hoher Komplexität notwendig, da automatische Metriken subtile logische Nuancen verfehlen können.
Metriken zur Bewertung der Schlussfolgerung
Vergleich von Bewertungsmethoden.
| Metrik | Was es misst | Einschränkung |
|---|---|---|
| Endgenauigkeit | Ob die Antwort korrekt ist. | Unterscheidet nicht zwischen Schlussfolgerung und Merken. |
| Spurkonsistenz | Logische Kohärenz der Zwischenschritte. | Erfordert Belohnungsmodelle oder menschliche Prüfung. |
| Robustheit gegenüber Störungen | Stabilität bei kleinen Eingabeänderungen. | Kostenintensiv in großem Maßstab zu implementieren. |
Häufige Fehler und Grenzen
Trotz ihrer Fortschritte weisen Schlussfolgerungsmodelle signifikante, in der Literatur dokumentierte Einschränkungen auf. Eine der wichtigsten ist der 'Genauigkeitszusammenbruch' bei Aufgaben hoher Komplexität. Aktuelle Studien, wie die von Apple ML Research, zeigen, dass Frontier-Modelle einen drastischen Rückgang der Genauigkeit erfahren, wenn die kompositionelle Komplexität eines Problems einen bestimmten Schwellenwert überschreitet. Darüber hinaus wird eine kontraintuitive Skalierungsgrenze beobachtet: Der Schlussfolgerungsaufwand (gemessen in Tokens) steigt mit der Komplexität bis zu einem Punkt, fällt dann aber ab, selbst wenn das Modell ein ausreichendes Token-Budget hat.
Weitere häufige Fehler umfassen logische Halluzinationen, bei denen das Modell Schritte generiert, die kohärent erscheinen, aber erfundene Fakten enthalten oder die Einschränkungen des Problems verletzen. Es gibt auch das Problem der fehlenden Interpretierbarkeit: Es kann nicht mit Sicherheit garantiert werden, dass das Modell die generierte Gedankenspur befolgt hat, da es sie möglicherweise 'post hoc' generiert hat, um eine vorbestimmte Antwort zu rechtfertigen. Außerdem neigen Modelle dazu, 'überzudenken' (unnötige Schritte zu generieren) oder 'unterzudenken' (kritische Schritte zu überspringen), wenn ihnen keine klaren und spezifischen Anweisungen gegeben werden. Der Rechenkosten- und Latenzfaktor sind auch wichtige praktische Einschränkungen, da explizite Schlussfolgerung deutlich langsamer und teurer ist als die Standardgenerierung.
Häufig gestellte Fragen und Primärquellen
Ist Schlussfolgerung eine emergente oder gelernte Fähigkeit? Die Beweise deuten auf eine Kombination aus beidem hin. Sie erscheint mit der Modellgröße, wird aber durch Feinabstimmung an strukturierten Daten und Reinforcement Learning signifikant gestärkt. Kann ich der Erklärung des Modells vertrauen? Nicht vollständig. Die Erklärung ist nützlich für Fehlersuche und Verständnis, sollte aber als zu prüfende Hypothese und nicht als absolute Wahrheit behandelt werden. Welche Modelle sind besser für Schlussfolgerung? Large Reasoning Models (LRMs) wie die o-Serie von OpenAI, Gemini 2.5 Pro und Claude 3.7 Sonnet sind speziell dafür designed, aber ihre Leistung hängt von der Komplexität der Aufgabe ab.
Die Primärquellen für diese Informationen umfassen die Studie 'The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity' von Apple ML Research, präsentiert auf NeurIPS 2025, die experimentelle Beweise für die Komplexitätsgrenzen von LRMs liefert. Es wurden auch technische Prompting-Guides und Artikel zur Modellarchitektur konsultiert, um die praktische und ingenieurwissenschaftliche Perspektive zu ergänzen.