Définition en une phrase
Capacité observable de combiner informations, contraintes et étapes intermédiaires pour résoudre une tâche.
Définition et concepts à ne pas confondre
Le raisonnement dans les modèles de langage se définit comme la capacité observable de combiner des informations, des contraintes et des étapes intermédiaires pour résoudre une tâche complexe. Contrairement à la simple prédiction du mot suivant, un modèle qui raisonne évalue la structure de la tâche, identifie les relations causales et construit une chaîne d'étapes logiques menant à une conclusion. Cette capacité est essentielle dans les tâches où non seulement le résultat final compte, mais aussi la validité du chemin suivi pour y parvenir.
Il est crucial de distinguer le raisonnement d'autres concepts liés. Il ne doit pas être confondu avec la mémoire factuelle, qui est la récupération de données stockées lors de l'entraînement, ni avec l'interpolation statistique, qui consiste à compléter des motifs basés sur la fréquence de co-occurrence. Ce n'est pas non plus synonyme de la chaîne de pensée (chain-of-thought), qui est une technique de prompting ou un mécanisme de génération spécifique, tandis que le raisonnement est la capacité sous-jacente. Enfin, le raisonnement diffère de l'inférence au sens logique strict ; les modèles actuels n'exécutent pas de règles formelles déterministes, mais génèrent des séquences de jetons qui imitent la structure d'un raisonnement valide, ce qui introduit une couche d'incertitude inhérente.
Différences entre les concepts clés
Tableau comparatif pour distinguer le raisonnement des concepts proches.
| Concept | Définition brève | Différence principale avec le raisonnement |
|---|---|---|
| Raisonnement | Processus de déduction de conclusions par des étapes logiques intermédiaires. | C'est la capacité cible de cette fiche. |
| Chaîne de pensée (CoT) | Technique pour générer ou forcer des étapes intermédiaires visibles. | C'est un mécanisme d'implémentation, pas la capacité elle-même. |
| Inférence | Déduction logique formelle ou statistique. | Le raisonnement dans les LLM est probabiliste, non déterministe. |
| Mémoire factuelle | Récupération d'informations préexistantes. | N'implique pas de transformation logique de l'information. |
Fonctionnement étape par étape
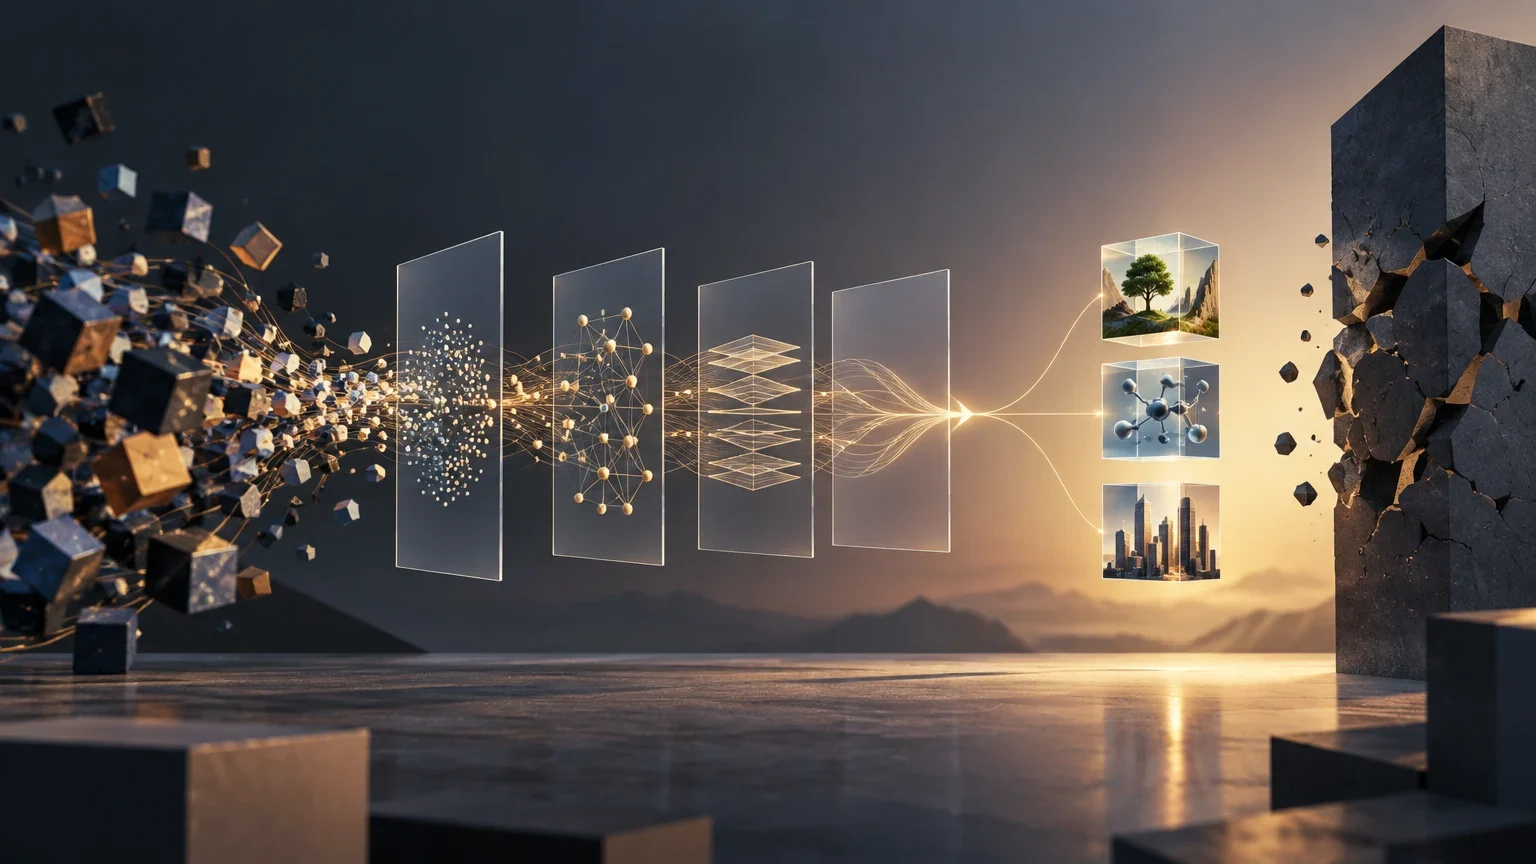
Le fonctionnement du raisonnement dans les modèles de langage modernes, en particulier dans les Grands Modèles de Raisonnement (LRM), suit un processus structuré qui diffère de la génération standard. D'abord, le modèle analyse l'entrée pour identifier le type de logique requise, qu'il s'agisse de déduction, d'induction ou d'abduction. Ensuite, il décompose le problème en sous-problèmes gérables. Au lieu de générer immédiatement la réponse finale, le modèle produit une séquence de jetons intermédiaires, souvent appelés « jetons de pensée », qui représentent l'état de la solution partielle.
Lors de cette phase intermédiaire, le modèle peut explorer différentes voies de solution, vérifier la cohérence de ses étapes et corriger les erreurs avant d'émettre la réponse finale. Ce processus consomme plus de ressources computationnelles et de temps d'inférence que la génération directe. La qualité du raisonnement dépend de plusieurs facteurs : l'échelle du modèle, la diversité des données d'entraînement incluant des structures logiques explicites, et les techniques de fine-tuning qui renforcent la cohérence logique. Les preuves suggèrent que ce comportement émerge de l'interaction entre l'architecture, les données et l'entraînement, plutôt que d'un module logique isolé.
Flux de raisonnement dans un LRM
Processus séquentiel typique d'un grand modèle de raisonnement.
- 01Analyse de l'entrée : identification des contraintes et du type de logique.
- 02Décomposition : division du problème en étapes logiques intermédiaires.
- 03Génération de traces de pensée : création de jetons intermédiaires documentant la logique.
- 04Vérification interne : révision de la cohérence des étapes générées.
- 05Synthèse finale : formulation de la réponse définitive basée sur la trace.
Trois exemples développés dans des domaines pertinents
Pour illustrer l'application pratique du raisonnement, trois exemples sont présentés dans des domaines distincts. Dans le domaine mathématique, un modèle doit résoudre un problème d'optimisation avec plusieurs variables. Au lieu de deviner la réponse, le modèle génère une séquence d'équations, applique les contraintes étape par étape et vérifie la validité de chaque transformation algébrique. S'il détecte une incohérence à une étape intermédiaire, il peut reculer et essayer une alternative, ce qu'un modèle standard ne ferait pas de manière explicite.
Dans le développement logiciel, le raisonnement s'applique au débogage de code complexe. Le modèle analyse la pile d'appels, identifie la cause racine d'une erreur et propose une correction qui ne résout pas seulement le symptôme, mais explique pourquoi la solution est valide dans le contexte du système. Enfin, dans l'analyse de données, le modèle doit interpréter un ensemble de données ambigu. Ici, le raisonnement implique d'inférer des relations causales à partir de corrélations, de considérer des hypothèses alternatives et de justifier pourquoi une interprétation est plus probable qu'une autre, en documentant chaque inférence pour permettre l'audit humain.
Comment évaluer le résultat
Évaluer la qualité du raisonnement est plus complexe qu'évaluer la précision d'une réponse finale. Les benchmarks traditionnels, comme GSM8K ou MMLU, mesurent souvent l'exactitude du résultat, ce qui peut masquer si le modèle a réellement raisonné ou s'il a simplement récupéré un motif mémorisé. Un modèle peut obtenir la bonne réponse par un raccourci statistique, ce qui ne démontre pas une capacité de raisonnement robuste. Par conséquent, l'évaluation doit se concentrer sur la structure et la cohérence de la trace de raisonnement, et non seulement sur le résultat.
Les méthodologies avancées incluent l'analyse de la cohérence interne, où l'on vérifie si les étapes intermédiaires sont logiquement valides et ne contiennent pas de contradictions. Des techniques de perturbation sont également utilisées, où l'on modifie légèrement l'entrée pour voir si le modèle maintient la cohérence de son raisonnement ou s'il s'effondre. En outre, l'utilisation de modèles de récompense de processus (Process Reward Models) est recommandée, qui évaluent chaque étape individuellement, plutôt que seulement le résultat final. L'évaluation humaine reste nécessaire pour les cas de haute complexité, car les métriques automatiques peuvent échouer à capturer les nuances logiques subtiles.
Métriques d'évaluation du raisonnement
Comparaison des méthodes d'évaluation.
| Métrique | Ce qu'elle mesure | Limitation |
|---|---|---|
| Précision finale | Si la réponse est correcte. | Ne distingue pas entre raisonnement et mémorisation. |
| Cohérence de la trace | Cohérence logique des étapes intermédiaires. | Nécessite des modèles de récompense ou une revue humaine. |
| Robustesse aux perturbations | Stabilité face à de petits changements dans l'entrée. | Coûteuse à mettre en œuvre à grande échelle. |
Erreurs courantes et limites
Malgré leurs avancées, les modèles de raisonnement présentent des limites significatives documentées dans la littérature. L'une des principales est l'« effondrement de précision » dans les tâches de haute complexité. Des études récentes, comme celle menée par Apple ML Research, montrent que les modèles de frontière connaissent une chute drastique de l'exactitude lorsque la complexité compositionnelle d'un problème dépasse un certain seuil. De plus, une limite d'échelle contre-intuitive est observée : l'effort de raisonnement (mesuré en jetons) augmente avec la complexité jusqu'à un point, puis diminue, même si le modèle dispose d'un budget de jetons suffisant.
D'autres erreurs courantes incluent l'hallucination logique, où le modèle génère des étapes qui semblent cohérentes mais contiennent des faits fabriqués ou violent les contraintes du problème. Il existe également le problème du manque d'interprétabilité : on ne peut pas garantir avec certitude que le modèle a suivi la trace de pensée qu'il a générée, car il pourrait l'avoir générée « a posteriori » pour justifier une réponse prédéterminée. De plus, les modèles ont tendance à « sur-réfléchir » (générer des étapes inutiles) ou « sous-réfléchir » (sauter des étapes critiques) s'ils ne reçoivent pas des instructions claires et spécifiques. Le coût computationnel et la latence sont également des limites pratiques importantes, car le raisonnement explicite est significativement plus lent et plus coûteux que la génération standard.
Questions fréquentes et sources primaires
Le raisonnement est-il une capacité émergente ou apprise ? Les preuves suggèrent qu'il s'agit d'une combinaison des deux. Il apparaît avec l'échelle du modèle, mais est considérablement renforcé par le fine-tuning sur des données structurées et l'apprentissage par renforcement. Puis-je faire confiance à l'explication donnée par le modèle ? Pas entièrement. L'explication est utile pour le débogage et la compréhension, mais doit être traitée comme une hypothèse à vérifier, et non comme une vérité absolue. Quels modèles sont meilleurs pour le raisonnement ? Les Grands Modèles de Raisonnement (LRM) comme ceux de la série o d'OpenAI, Gemini 2.5 Pro et Claude 3.7 Sonnet sont conçus spécifiquement pour cela, mais leurs performances dépendent de la complexité de la tâche.
Les sources primaires pour ces informations incluent l'étude « The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity » d'Apple ML Research, présentée à NeurIPS 2025, qui fournit des preuves expérimentales sur les limites de complexité des LRM. Des guides techniques de prompting et des articles sur l'architecture des modèles ont également été consultés pour compléter la perspective pratique et d'ingénierie.