Definition in einem Satz
Antwort, die einem definierten Schema entsprechen muss, um automatisch validiert und verarbeitet zu werden.
Definition und Abgrenzung vom Freitext
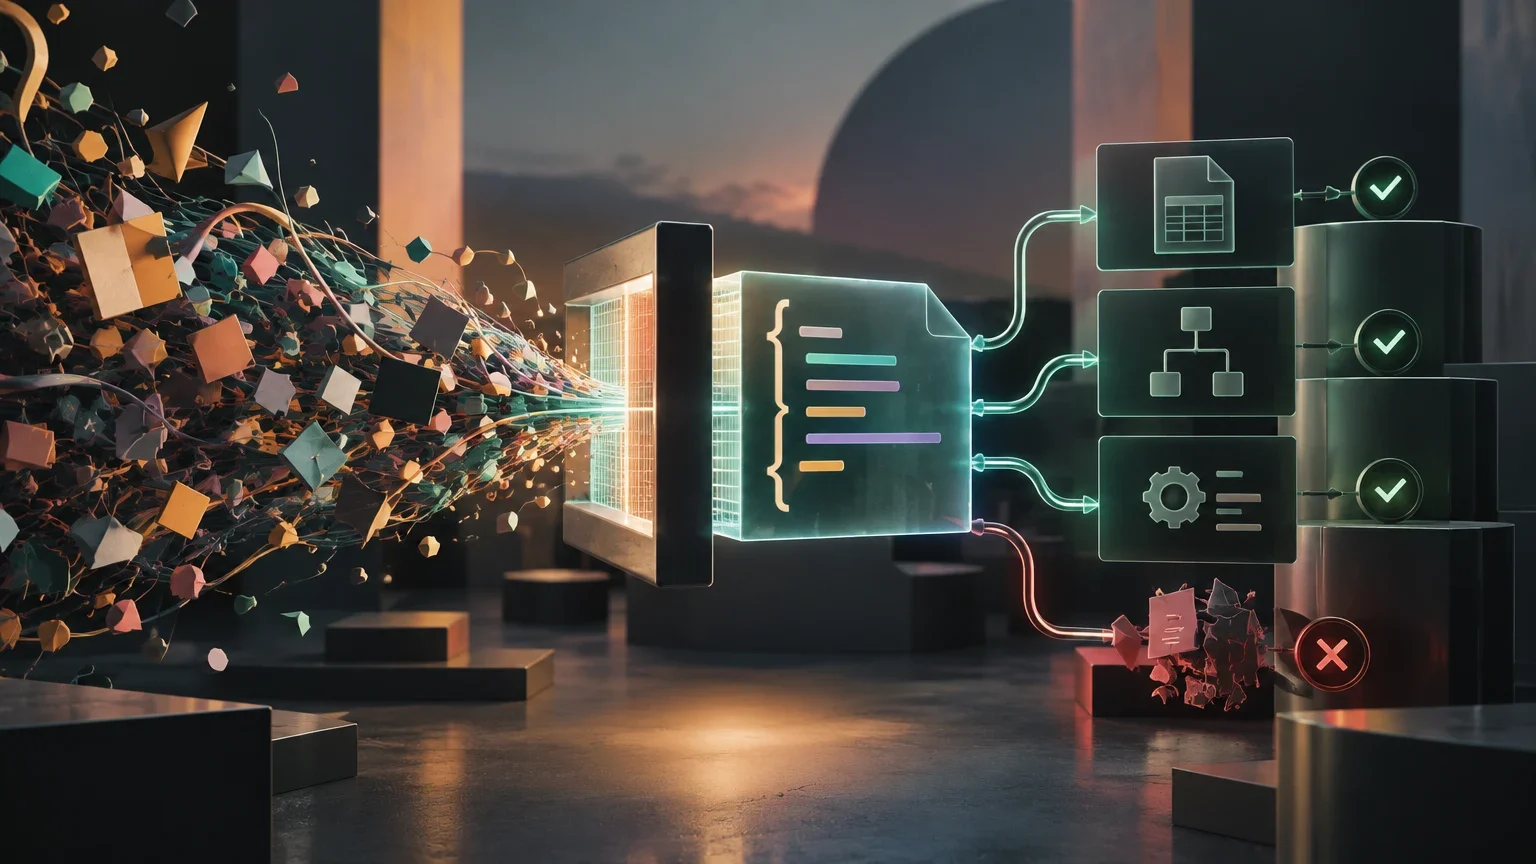
Strukturierte Ausgabe wird definiert als die Generierung von Antworten durch ein Sprachmodell, die einem vordefinierten formalen Schema, typischerweise JSON, XML oder CSV, entsprechen, sodass ein Programm sie ohne Mehrdeutigkeit oder menschliches Eingreifen parsen kann. Im Gegensatz zum Freitext, in dem das Modell volle Formatfreiheit hat, erzwingt die strukturierte Ausgabe einen Datenvertrag, der die maschinenlesbare Interpretation garantiert. Diese Unterscheidung ist in Produktions-Pipelines kritisch, da ein Formatfehler komplette Automatisierungsketten brechen kann.
Der operative Wert der strukturierten Ausgabe liegt in der Eliminierung der Parsing-Ungewissheit. Im Freitext kann ein Modell eine Zahl in Wortform zurückgeben, JSON in Markdown-Zäunen einbetten oder Pflichtfelder weglassen. Die strukturierte Ausgabe mildert diese Risiken, indem sie die Konformität mit einem Schema erzwingt, beseitigt jedoch nicht vollständig die Möglichkeit semantischer Fehler. Es ist die Standardtechnik für Datenerfassungs-, Ticket-Klassifizierungs- oder Funktionsargument-Generierungsaufgaben.
Vergleich: Freitext vs. Strukturierte Ausgabe
Wesentliche Unterschiede zwischen beiden Generierungsmodi im Kontext von LLMs.
| Kriterium | Freitext | Strukturierte Ausgabe |
|---|---|---|
| Format | Variabel, nicht garantiert | Fest, schemakonform (JSON/XML) |
| Parsing | Erfordert Heuristiken oder fragile Regex | Direkt über Validatoren (Pydantic, Zod) |
| Hauptrisiko | Semantische und Format-Mehrdeutigkeit | Schemakomplexität und Latenz |
| Typischer Einsatz | Chat, Redaktion, Brainstorming | APIs, Daten-Pipelines, Agenten |
Technische Mechanismen der Erzwingung und Validierung
Es gibt drei dominierende Ansätze, um strukturierte Ausgabe zu erhalten: JSON per Prompt, schemabasierte eingeschränkte Generierung (constrained Decoding) und Funktionsaufrufe (Function Calling). JSON per Prompt besteht darin, das Modell in natürlicher Sprache anzuweisen, in einem bestimmten Format zu antworten. Es ist schnell zu implementieren, bietet aber keine Garantien; das Modell kann erklärenden Text hinzufügen oder ungültiges JSON erzeugen. Es eignet sich für Prototypen, immer begleitet von Client-Validierung.
Die schemabasierte eingeschränkte Generierung, oder constrained Decoding, ist der robusteste Mechanismus. Sie funktioniert, indem sie die Tokens begrenzt, die das Modell in jedem Generierungsschritt emittieren kann, und die Wahrscheinlichkeiten von Tokens maskiert, die die Syntax des Schemas verletzen würden. Dies garantiert die syntaktische Gültigkeit, bevor auch nur ein ungültiges Token generiert wird. Der Funktionsaufruf kombiniert diese Garantie mit der Entscheidungsfähigkeit des Modells und ermöglicht es ihm, eine Aktion auszuwählen und die erforderlichen typisierten Argumente zu generieren. Für selbst gehostete Modelle implementieren Tools wie Outlines oder vLLM diese Erzwingung über endliche Zustandsautomaten oder kontextfreie Grammatiken.
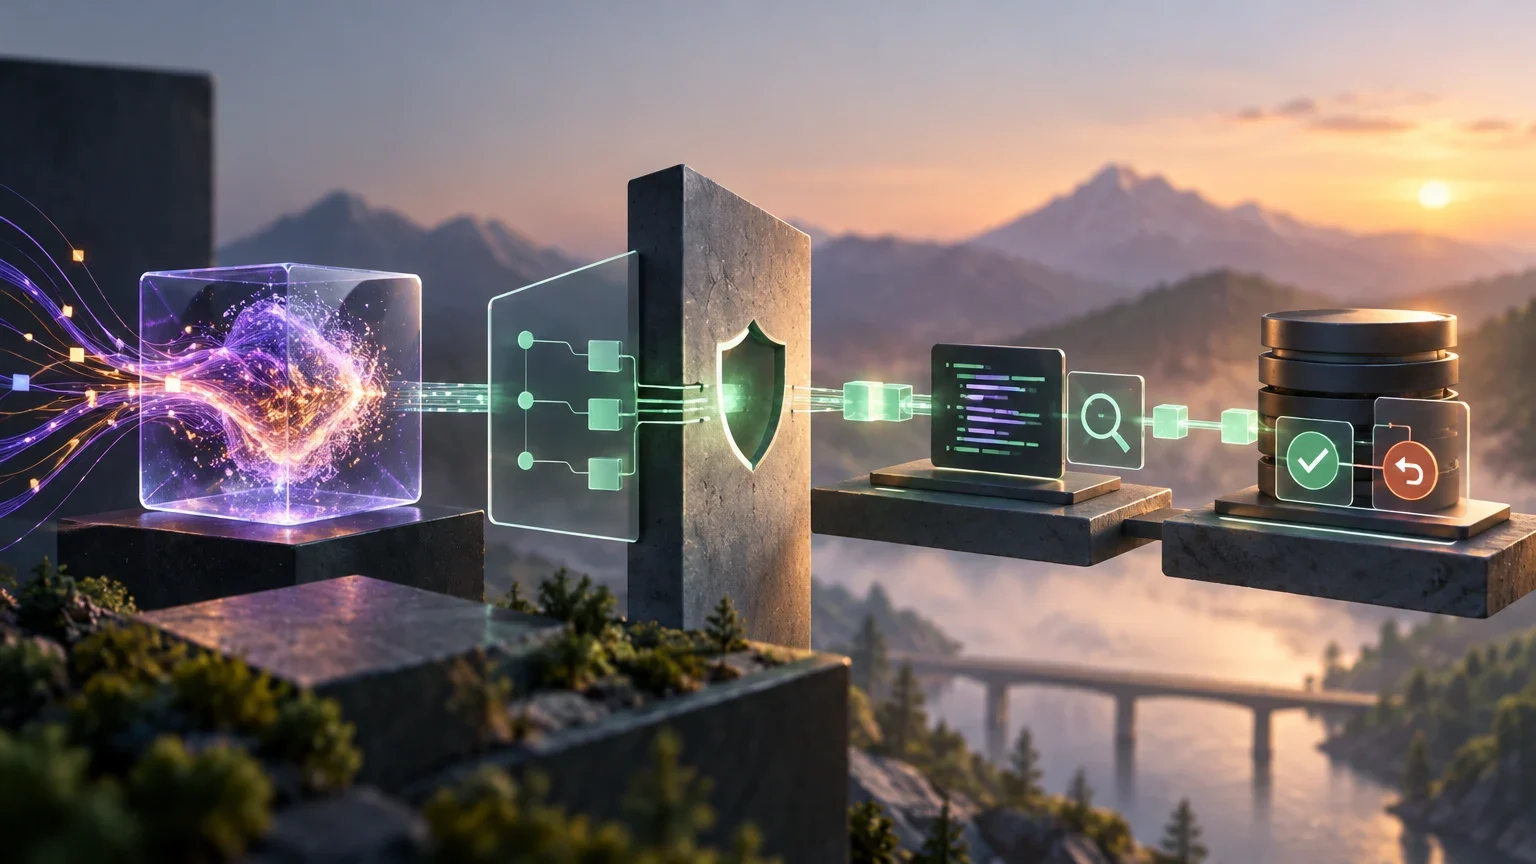
Validierungsfluss in der Produktion
Empfohlene Sequenz zur Handhabung strukturierter Ausgabe in einer robusten Pipeline.
- 01Definieren Sie ein minimales JSON-Schema mit Pflichtfeldern, strikten Typen und Enums für geschlossene Optionen.
- 02Fordern Sie die Generierung vom Anbieter an, wobei Sie den Parameter response_format oder constrained Decoding verwenden, wenn verfügbar.
- 03Parsen Sie die rohe Antwort mit einem Validator (Pydantic in Python, Zod in TypeScript).
- 04Wenn die Validierung fehlschlägt, protokollieren Sie die vollständige rohe Ausgabe zur Fehlersuche.
- 05Führen Sie einen einzelnen Wiederholungsversuch mit einem angepassten Prompt oder einem strengeren Schema durch.
- 06Wenn der Wiederholungsversuch fehlschlägt, leiten Sie an eine menschliche Prüfungs-Warteschlange weiter oder wenden Sie einen sicheren Standardwert an.
Angewandte Beispiele in verschiedenen Bereichen
Bei der Datenerfassung aus Dokumenten ermöglicht die strukturierte Ausgabe die Umwandlung unstrukturierter Rechnungen oder Verträge in JSON-Objekte, die bereit für die Datenbank sind. Zum Beispiel ermöglicht ein Schema mit den Feldern 'total' (Zahl), 'due_date' (ISO-Datum) und 'vendor' (Zeichenkette), dass das Abrechnungssystem die Daten eingibt, ohne Freitext zu parsen. Die syntaktische Erzwingung verhindert, dass das Modell den Gesamtbetrag als 'vierhundert zweiunddreißig Dollar' zurückgibt, was die Berechnungslogik brechen würde.
Bei der Agenten-Orchestrierung ist die strukturierte Ausgabe für das Tool-Calling fundamental. Der Agent muss entscheiden, welches Tool aufgerufen wird, und die richtigen Argumente generieren. Ein Schema, das die Funktion 'get_customer_info' mit den Pflichtparametern 'name' (Zeichenkette) und 'id' (Ganzzahl) definiert, garantiert, dass der Agent die API nicht mit fehlerhaften Argumenten aufruft. Dies ist in mehrstufigen Systemen entscheidend, wo ein struktureller Fehler in einer Zwischenstufe den Agentenzustand in den folgenden Stufen korrupt machen kann.
Häufige Verwechslungen: Syntax vs. Semantik
Ein häufiger Fehler ist die Annahme, dass syntaktische Gültigkeit semantische Korrektheit impliziert. Die technische Erzwingung garantiert, dass die Ausgabe der Struktur des Schemas entspricht (z. B. dass 'phone_number' eine Zeichenkette ist), garantiert aber nicht, dass der Wert korrekt ist. Das Modell kann eine syntaktisch gültige, aber nicht existierende oder falsche Telefonnummer generieren. Diese Unterscheidung ist vital: Die automatische Validierung erkennt Formatfehler, aber keine Inhaltsfehler.
Empirische Studien deuten darauf hin, dass selbst wenn syntaktische Fehler durch eingeschränktes Decoding eliminiert werden, erhebliche strukturelle und semantische Fehler bestehen bleiben. Die Hauptengstelle liegt nicht in der Syntax, sondern in der Fähigkeit des Modells, die semantische Kohärenz unter strukturellen Einschränkungen aufrechtzuerhalten. Daher sollte die strukturierte Ausgabe durch Geschäftsvalidierungen, Domänenregeln und in kritischen Fällen durch menschliche Prüfung ergänzt werden.
Operative Grenzen und Leistungsüberlegungen
Die strukturierte Ausgabe führt zu operativen Grenzen, die berücksichtigt werden müssen. Erstens die Schemakomplexität: Sehr große Schemata oder solche mit vielen Optionen können die Modellleistung beeinträchtigen, da die Token-Beschränkung die Reasoning-Fähigkeit des LLM stören kann. Einige Studien legen nahe, dass Modelle bei komplexen Aufgaben schlechter abschneiden, wenn ihnen eine strenge Struktur aufgezwungen wird; es wird daher empfohlen, die strukturierte Ausgabe als Elicitation-Technik zu testen und ihren Einfluss auf die Antwortqualität zu messen.
Zweitens die zusätzliche Latenz: Das eingeschränkte Decoding erfordert die Berechnung der Wahrscheinlichkeiten der erlaubten Tokens in jedem Schritt, was die Inferenzzeit erhöhen kann. Drittens die Anbieterabhängigkeit: Nicht alle Anbieter unterstützen denselben JSON-Schema-Untermenge oder dieselben Erzwingungsparameter. Es wird empfohlen, Abstraktionsbibliotheken wie Instructor oder Pydantic AI zu verwenden, um diese Unterschiede zu verwalten und die Portabilität zwischen Anbietern zu gewährleisten.
Entscheidungshilfe: Welche Methode verwenden?
Kriterien zur Auswahl zwischen Prompt, constrained Decoding und Function Calling.
| Szenario | Empfohlene Methode | Begründung |
|---|---|---|
| Schnelle Prototypisierung | JSON per Prompt + Validierung | Maximale Flexibilität, keine API-Abhängigkeiten |
| Deterministische Datenerfassung | Constrained Decoding | Syntaxgarantie, geringeres Parsing-Risiko |
| Agent, der Aktionen entscheidet | Function Calling | Kombiniert Entscheidung und typisierte Argumente |
| Selbst gehostetes Modell | Outlines / vLLM guided Decoding | Volle Kontrolle über die Inferenzebene |
Verwandte Konzepte und Vertiefung
Die strukturierte Ausgabe steht in engem Zusammenhang mit der Datenvalidierung, der Agenten-Orchestrierung und der LLM-Beobachtbarkeit. Zur Vertiefung ist es nützlich, die JSON-Schema-Spezifikationen, die Anbieterleitfäden zu strukturierten Ausgaben und die Observability-Tools zu erkunden, die es ermöglichen, strukturierte Ausgaben in mehrstufigen Pipelines zu verfolgen. Die Kombination aus technischer Erzwingung, Client-Validierung und kontinuierlicher Observability ist die empfohlene Praxis für Produktionssysteme.
Es wird empfohlen, Schemata minimal zu halten, sie ab dem ersten Tag zu versionieren und sowohl die rohe als auch die validierte Ausgabe zu protokollieren. Dies ermöglicht die Erkennung stiller Regressionen, wenn Modelle aktualisiert oder Anbieter gewechselt werden. Die strukturierte Ausgabe ist keine magische Lösung, sondern ein Werkzeug, das bei rigoroser Anwendung die zuverlässige und wartbare Integration von LLMs in Softwaresysteme ermöglicht.