Ein multimodales Modell zum Auffinden von Inhalten
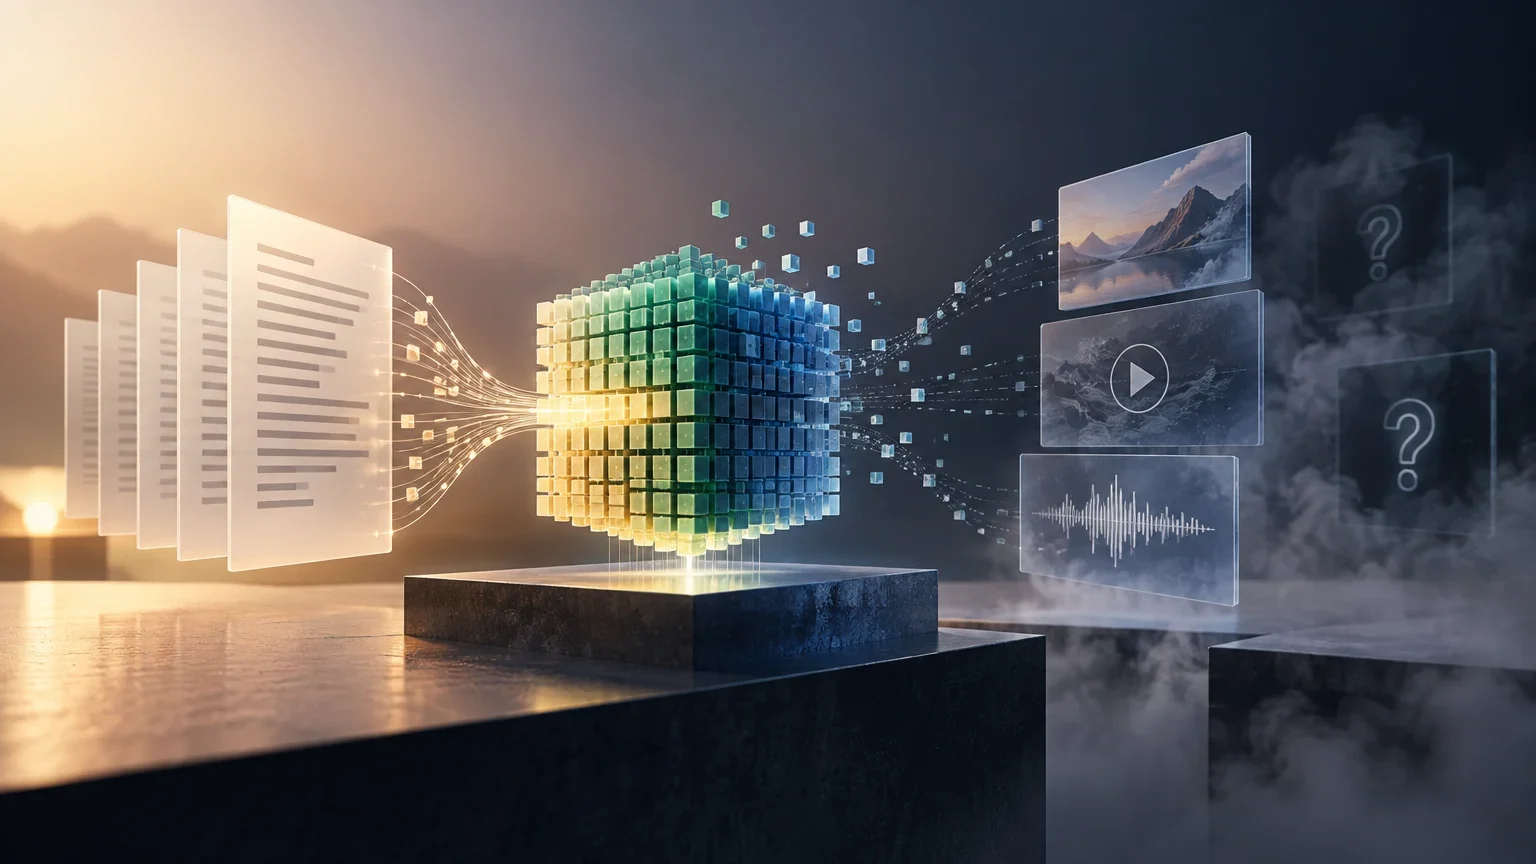
Google stellte EmbeddingGemma 2 als multimodale Erweiterung des vorherigen Text-Embedding-Modells vor. Die neue Version bildet Text – einschließlich Code –, Bilder, Audio und Video in einem gemeinsamen Vektorraum ab. Sie soll dabei helfen, Inhalte zu einer Anfrage zu finden. Das Modell ist nicht als dialogorientiertes System zum Verfassen von Antworten oder zum Generieren von Bildern, Audio und Video ausgelegt.
Das Modell hat insgesamt 740 Millionen Parameter und kombiniert eine Textkomponente mit Bild- und Audio-Encodern, die sich gezielt laden lassen. Laut Google umfasst die Textkomponente 270 Millionen Parameter, der Bild-Encoder 170 Millionen und der Audio-Encoder 300 Millionen. Diese Werte und die gewählte Konfiguration sind für die Abschätzung des Ressourcenbedarfs wichtig: Bei einer reinen Textanwendung müssen nicht zwangsläufig alle Komponenten des multimodalen Modells geladen werden.
EmbeddingGemma 2 erzeugt Vektoren mit 768 Dimensionen und unterstützt mithilfe von Matryoshka Representation Learning kürzere Vektoren mit 512, 256 oder 128 Dimensionen. Kürzere Vektoren können den Speicherbedarf senken und bestimmte Suchvorgänge beschleunigen. Die Qualität kann jedoch je nach Dimension und Aufgabe variieren. Nach dem Kürzen muss ein Vektor normalisiert werden, bevor er mit Kosinusähnlichkeit verglichen wird. Außerdem müssen Suchanfragen und Dokumente im Index dieselbe Dimension haben.
Google veröffentlicht das Modell unter der Lizenz Apache 2.0. Die Lizenz beseitigt weder die Betriebskosten noch legt sie allein die Pflichten zum Umgang mit Anwendungsdaten fest. Das technische Datenblatt nennt ein gemeinsames Kontextfenster von 8.192 Tokens für die Modalitäten. Wie viele Eingaben tatsächlich hineinpassen, hängt davon ab, wie sie kombiniert und aufbereitet werden.
So funktioniert multimodale Suche
Ein Embedding ist eine numerische Repräsentation eines Elements, etwa eines Satzes, Bildes oder Audiosegments. Ein Suchsystem vergleicht die Vektoren und ordnet mögliche Treffer nach ihrer Ähnlichkeit. Bei der Dokumentsuche könnte eine Anfrage zu „Schuhen für Regenwetter“ beispielsweise einen Eintrag zu wasserdichten Stiefeln finden, obwohl darin das Wort „Regen“ nicht vorkommt. Das ist ein möglicher Treffer, aber kein Beweis dafür, dass das Modell den vorgesehenen Einsatzzweck verstanden hat oder der Eintrag korrekt ist.
EmbeddingGemma 2 kann Inhalte aus verschiedenen Modalitäten miteinander verknüpfen, sofern die Anwendung die Daten für die jeweilige Aufgabe vorbereitet. So lässt sich etwa eine Textanfrage mit Bildern aus einem Produktkatalog abgleichen. Das Modell kann außerdem Eingaben verarbeiten, die Text und Medien kombinieren. Für die Repräsentation eines Produkts könnte eine Anwendung dessen Beschreibung und Bilder gemeinsam übergeben; für die Suche in Videos könnte sie die Suchanfrage zusammen mit den nach der gewählten Konfiguration verarbeiteten Einzelbildern verwenden.
Aufgabenpräfixe helfen, Textrepräsentationen auf den jeweiligen Zweck auszurichten. Bei einer asymmetrischen Suche erfüllen Anfrage und Dokument unterschiedliche Rollen: Die Anfrage wird als Suchanfrage vorbereitet, die Elemente des Korpus als Dokumente. Bei symmetrischen Aufgaben, etwa dem Gruppieren von Texten oder dem Bestimmen der Satzähnlichkeit, wird dieselbe Art von Anweisung für die verglichenen Elemente verwendet. Diese Präfixe gelten für Text, nicht für Bilder, Audio oder Video.
Auch die Eingabekonfiguration beeinflusst, wie viel Inhalt in den Kontext passt. Laut technischem Datenblatt teilen sich alle Modalitäten ein gemeinsames Budget. Werden Text, Bilder, Audio und Video kombiniert, steht jeder Modalität entsprechend weniger davon zur Verfügung. Bei Videos beeinflussen die Auswahl der Einzelbilder und die Abtastrate, welche Informationen repräsentiert werden. Für Audio ist ein einkanaliges Format mit 16 kHz angegeben. Diese Parameter beschreiben die Verarbeitung; sie garantieren nicht, dass alle relevanten Details gefunden werden.
Was sich je nach Aufgabe ändert
| Aufgabe | Verglichene Eingaben | Was die Bewertung misst |
|---|---|---|
| Dokumentsuche | Suchanfrage und Textdokumente | Ob relevante Dokumente weit oben erscheinen |
| Text-Bild-Suche | Textanfrage und Bilder | Ob relevante Bilder unter den ersten Treffern erscheinen |
| Audio-Suche | Suchanfrage und Aufnahmen oder Ausschnitte | Ob die anhand der festgelegten Kriterien relevanten Audios gefunden werden |
| Video-Suche | Suchanfrage und repräsentierte Videos oder Einzelbilder | Ob relevantes Material mit der verwendeten Abtastung und den Testdaten gefunden wird |
Modellgröße, Kontext und lokale Konfiguration
Die 740 Millionen Parameter beziehen sich auf das multimodale Gesamtmodell. Laut technischem Datenblatt benötigt die reine Textkonfiguration 270 Millionen Parameter, Text und Bild benötigen 440 Millionen, Text und Audio 570 Millionen und das vollständige Modell 740 Millionen. Diese Zahlen beschreiben die veröffentlichten Ladekonfigurationen, nicht den gesamten Speicherbedarf einer laufenden Anwendung.
Die Größe der Modellgewichte und der tatsächliche Speicherverbrauch hängen unter anderem von der numerischen Präzision, der Bibliothek, der Hardware, der Eingabelänge und der Batchgröße ab. Google empfiehlt bfloat16, wenn die Hardware es unterstützt, und ansonsten float32. float16 kann ungültige Werte oder qualitativ beeinträchtigte Embeddings erzeugen. Die Parameterzahl allein reicht daher nicht aus, um Speicherbedarf oder Latenz einer konkreten Bereitstellung abzuschätzen.
Mit Matryoshka Representation Learning können Vektoren 768, 512, 256 oder 128 Dimensionen haben. In den von Google veröffentlichten Ergebnissen sinkt die Vektorgröße beim Wechsel von 768 auf 256 Dimensionen auf ein Drittel; gleichzeitig verändern sich mehrere Benchmarkwerte. Bei 128 Dimensionen fallen einige Werte für multimodale Aufgaben stärker ab. Diese Ergebnisse gelten für die angegebenen Tests und Metriken des Anbieters. Sie legen nicht fest, welche Dimension für einen bestimmten Korpus oder eine konkrete Anwendung am besten geeignet ist.
Für die Kosinusähnlichkeit müssen gekürzte Vektoren nach der Kürzung normalisiert werden. Der Vektor einer Anfrage und die Vektoren der indexierten Elemente müssen dieselbe Dimension haben. Ein Wechsel der Dimension erfordert, den Index entsprechend neu zu erzeugen oder anzupassen. Einen 768-dimensionalen Vektor direkt mit einem 128-dimensionalen zu vergleichen, ist keine gültige Operation.
Veröffentlichte Konfigurationen nach aktiven Modalitäten
Die angegebene Parameterzahl bezieht sich auf die geladenen Komponenten, nicht auf den gesamten Speicherbedarf des Prozesses.
| Aktive Modalitäten | Angegebene Parameterzahl |
|---|---|
| Nur Text | 270 Millionen |
| Text und Bild | 440 Millionen |
| Text und Audio | 570 Millionen |
| Text, Bild, Audio und Video | 740 Millionen |
Gekürzte Vektoren für die Suche vorbereiten
- 01Eine gemeinsame Dimension für Suchanfragen und alle Elemente im Index wählen.
- 02Vektoren mit der Inferenzkonfiguration oder einer kompatiblen Bibliotheksoption auf diese Dimension kürzen.
- 03Vektoren nach dem Kürzen normalisieren, wenn sie mit Kosinusähnlichkeit verglichen werden.
- 04Die Suche anhand eigener Anfragen und Dokumente überprüfen, bevor die Änderung bereitgestellt wird.
So lässt sich die Suchleistung bewerten
Ein aussagekräftiger Vergleich beginnt mit einer konkreten Aufgabe und einem Relevanzkriterium, das vor dem Test festgelegt wird. Ein Benchmark kann die Suche in einem bestimmten Datensatz messen, garantiert aber nicht dieselben Ergebnisse in einer anderen Sprache, einem anderen Fachgebiet oder mit anderen Inhaltstypen. Das technische Datenblatt von Google veröffentlicht Werte für verschiedene Tests zu Text, Code, Bildern, visuellen Dokumenten, Video und Audio. Jeder Wert gehört zu einer bestimmten Metrik und einem bestimmten Evaluationsdatensatz.
Für eine Text-Bild-Suche sollten echte Anfragen und eine Bildsammlung mit Relevanzkennzeichnungen vorbereitet werden. Bei Audio- oder Videosuche muss festgelegt werden, was als relevanter Treffer gilt: eine vollständige Aufnahme, ein Segment oder ein einzelnes Bild. Werden Modalitäten kombiniert, ist vor der Interpretation der Metriken festzulegen, wie die Eingaben aufbereitet und gewichtet werden.
Vergleiche das Modell mit einer Alternative anhand derselben Suchanfragen, desselben Korpus, derselben Anweisungen, Vektordimension und Rankingregeln. Miss die Suchqualität, Latenz und verwendeten Ressourcen getrennt. Halte numerische Präzision, Hardware, Eingabelängen und Modalitätenkonfiguration fest, damit sich die Ergebnisse einordnen und wiederholen lassen.
Die Bewertung sollte auch die Sprachen und Einsatzbedingungen abdecken, die für die Anwendung vorgesehen sind. Laut Modelldokumentation kann die Leistung zwischen Sprachen variieren und von Mehrdeutigkeiten und sprachlichen Nuancen beeinflusst werden. Ein aggregierter Wert ersetzt nicht die Prüfung der Suchanfragen, die eine Anwendung tatsächlich erhält.
Mindesttest für eine eigene Anwendung
- 01Die Aufgabe festlegen: Textsuche, Text-Bild-Suche, Audio- oder Video-Retrieval oder eine andere Kombination.
- 02Repräsentative Suchanfragen sammeln und relevante Treffer kennzeichnen.
- 03Eingabeaufbereitung, Dimension und Rankingregeln festlegen.
- 04Das Kandidatenmodell und eine Alternative mit demselben Korpus und derselben Konfiguration vergleichen.
- 05Suchqualität, Latenz und Ressourcenverbrauch getrennt messen.
- 06Den Test in den Sprachen, auf den Geräten und unter den Bedingungen wiederholen, die für den späteren Einsatz vorgesehen sind.
Was die Ergebnisse zeigen – und wo ihre Grenzen liegen
Google veröffentlicht Ergebnisse aus verschiedenen Benchmarks und vergleicht einige Textaufgaben mit dem Vorgängermodell EmbeddingGemma. Im MTEB-Benchmark für mehrsprachige Aufgaben liegt der veröffentlichte Wert für EmbeddingGemma 2 bei 61,36 gegenüber 61,15 für das Vorgängermodell. Im MTEB-Test für Code beträgt der veröffentlichte Wert 78,68 gegenüber 68,76. Diese Unterschiede beschreiben Ergebnisse in den angegebenen Tests; sie garantieren keine Verbesserung in jedem Suchsystem.
Das technische Datenblatt enthält auch Werte für Bilder, visuelle Dokumente, Video und Audio. Sie stammen aus konkreten Benchmarks und belegen nicht, dass das Modell eine Szene, ein Gespräch oder ein Ereignis allgemein versteht. Wenn eine Suche ein relevantes Video weit oben einordnet, beweist das weder, dass das System alle darin enthaltenen Fakten erkennt, noch dass es offene Fragen korrekt beantworten oder die Relevanz des Videos erklären kann.
Das Modell erzeugt Repräsentationen, keine dialogorientierte Antwort. Eine Anwendung kann gefundene Inhalte einem anderen generativen System als Kontext übergeben. Die Qualität des Endergebnisses hängt dann zusätzlich von diesem System, dem Korpus und den Anwendungsregeln ab. Deshalb sollten Retrieval und die anschließende Antwort getrennt bewertet werden.
Laut Google wird EmbeddingGemma 2 unter Apache 2.0 mit offenen Gewichten veröffentlicht. Die technische Dokumentation weist darauf hin, dass Embedding-Modelle im Gegensatz zu generativen Modellen kein nachträgliches Sicherheits-Finetuning und keine Moderation ihrer Ausgaben erhalten. Schutzmaßnahmen in der Anwendung, etwa Filter für abgerufene Inhalte und Fairness-Tests, liegen in der Verantwortung derjenigen, die sie bereitstellen. Eine offene Lizenz macht Suchergebnisse nicht zu überprüften Fakten und hebt die Notwendigkeit nicht auf, Verzerrungen, Datenschutz und vorgesehene Einsatzbereiche zu prüfen.
Retrieval und Verständnis sind nicht dasselbe
| Beobachtetes Ergebnis | Was sich daraus ableiten lässt | Was es allein nicht belegt |
|---|---|---|
| Ein relevantes Dokument erscheint unter den ersten Treffern | Das System hat dieses Dokument in einem konkreten Test gefunden | Dass es den Inhalt überprüft oder die Frage korrekt beantwortet hat |
| Ein passendes Bild erscheint zu einer Textanfrage | Der Test hat in dieser Konfiguration einen nützlichen Treffer gezeigt | Dass das Modell jedes Bild oder jede Szene interpretieren kann |
| Ein Video wird zu einer Anfrage gefunden | Das Video galt nach dem verwendeten Kriterium als relevant | Dass das System alle Ereignisse im Video versteht |
| Ein Benchmark erzielt einen hohen Wert | Das Modell hat bei dieser Aufgabe und Metrik entsprechend abgeschnitten | Ein allgemeiner Vorteil oder eine Garantie für den Produktivbetrieb |
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen