Ankündigung und Modellarchitektur
Google hat die Gemini Decisions API vorgestellt, einen neuen Endpunkt, der für schnelle und geschlossene Entscheidungen über multimodale Eingaben entwickelt wurde. Dieses Werkzeug basiert auf dem Modell Gemini Decision 1 (identifiziert als gemini-decision-1), das über die Gemini API in Google AI Studio verfügbar ist. Im Gegensatz zu generativen Modellen, die Text Token für Token erzeugen, bewertet dieses Modell die Kandidatenoptionen in einem einzigen Inferenzdurchlauf und liefert Wahrscheinlichkeiten sowie Konfidenzpunkte.
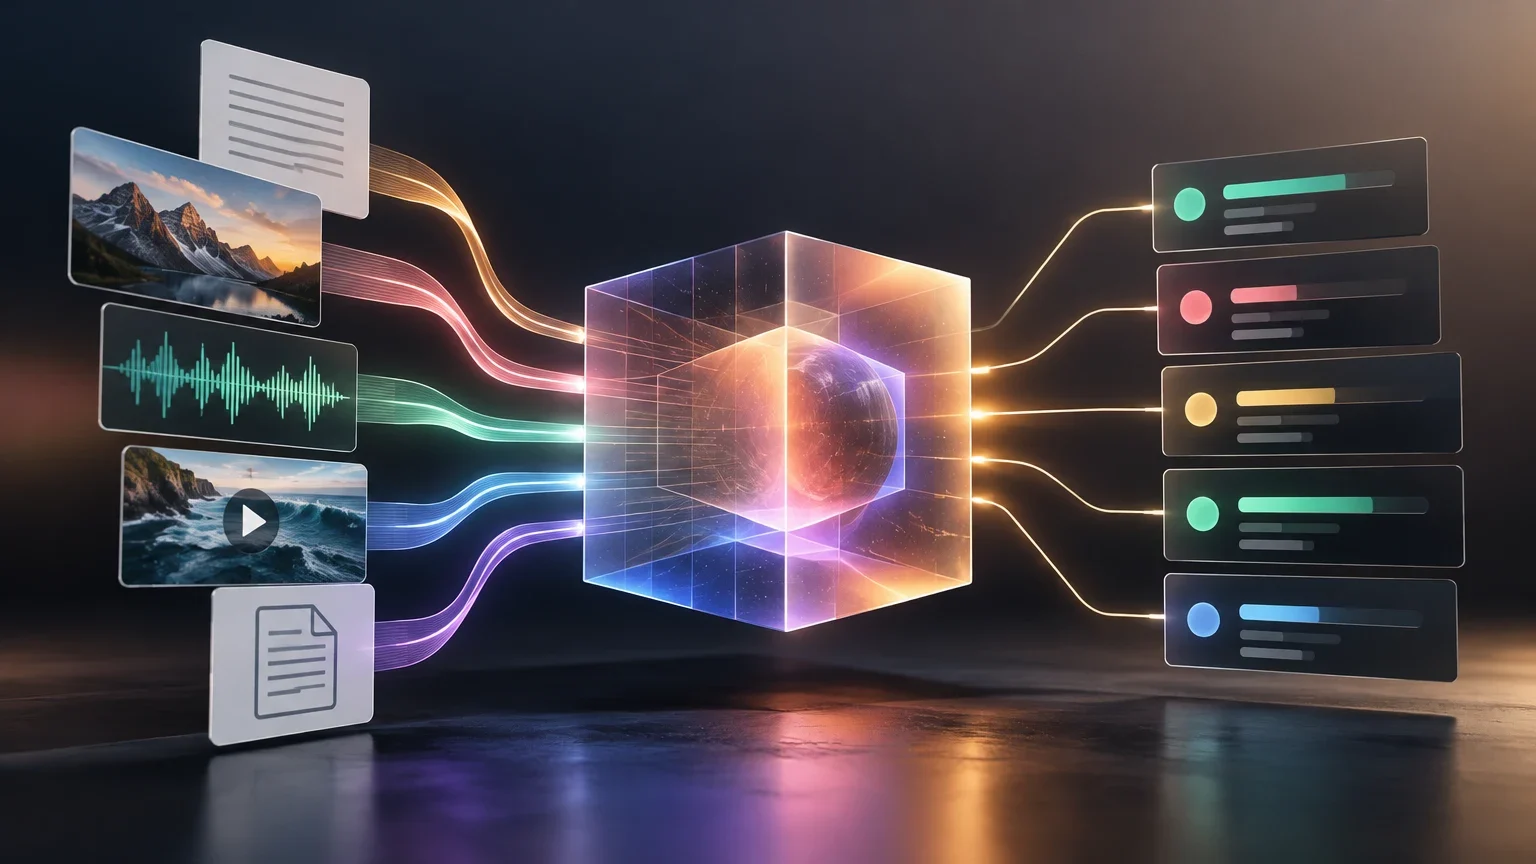
Das Ziel dieser Architektur besteht darin, spezifische Primitiven für begrenzte Auswahlmöglichkeiten bereitzustellen, wie etwa die Werkzeugauswahl, die Überprüfung von Richtlinien, das Routing von Modellen oder die Bewertung von Kontexten. Die API ermöglicht es, eine geteilte multimodale Eingabe zu übergeben, die Text, Bilder, Audio, Video und PDFs (bis zu 256K Tokens) enthalten kann, zusammen mit bis zu 1.000 unabhängigen Fragen in einer einzigen Anfrage.
Die Architektur der Gemini Decisions API ist darauf ausgelegt, die Rechenlast für wiederkehrende Klassifizierungsaufgaben zu minimieren, indem sie die Bewertung mehrerer Kriterien in einem einzigen Inferenzschritt bündelt. Dieses Vorgehen unterscheidet sich grundlegend von sequenziellen Ansätzen, bei denen jede einzelne Prüfung einen separaten Modellaufruf erfordert, was die Gesamtlatenz und die Kosten in hochfrequenten Systemen erheblich steigern würde.
Bewertungstypen und Antwortstruktur
Die API unterstützt drei Entscheidungstypen in einem einzigen Durchlauf: noul (Ja/Nein), choice (Multiple Choice) und score (geordnete Rubrik). Der Typ noul schätzt die Wahrscheinlichkeit, dass eine binäre Bedingung erfüllt ist. Der Typ choice wählt zwischen 2 und 255 Optionen und liefert die gewonnene Option sowie die normalisierten Wahrscheinlichkeiten für jeden Kandidaten. Der Typ score bewertet die Eingabe anhand einer geordneten Rubrik und liefert einen kontinuierlichen gewichteten Score sowie die Wahrscheinlichkeiten pro Stufe.
Jede Antwort enthält einen Konfidenzpunkt zwischen 0 und 1, was es dem Anwendungscode ermöglicht, mehrdeutige Fälle an einen Fallback-Mechanismus oder einen menschlichen Prüfer weiterzuleiten. Die Eingabe verwendet dasselbe Content-Block-Format wie die Interactions API, was die Integration in bestehende Entwicklungsworkflows erleichtert.
Von der API unterstützte Fragetypen
| Typ | Beschreibung | Hauptausgabe |
|---|---|---|
| noul | Bewertung einer binären Bedingung (Ja/Nein) | Wahrscheinlichkeit der Erfüllung |
| choice | Auswahl zwischen 2 und 255 Optionen | Gewonnene Option und normalisierte Wahrscheinlichkeiten |
| score | Bewertung anhand einer geordneten Rubrik | Kontinuierlicher Score und Wahrscheinlichkeiten pro Stufe |
Leistung, Latenz und Kosten
Google gibt an, dass Gemini Decision 1 eine Modellberechnungs-Latenz von 50 bis 100 Millisekunden aufrechterhält, mit einer End-to-End-Latenz von 150 bis 250 Millisekunden. Diese Latenz bleibt nahezu stabil, wenn die Anzahl der Fragen pro Anfrage von 1 auf 100 steigt. Das Modell unterstützt in den veröffentlichten Latenztests Kontexte von bis zu 16K Tokens, obwohl die allgemeine Eingabe bis zu 256K Tokens zulässt.
Was die Kosten betrifft, so beträgt der Preis 0,10 US-Dollar pro Million Eingabetokens, mit einer Gebühr von 0 US-Dollar für Ausgabetokens. Google weist darauf hin, dass die API aufgrund der Nichtabrechnung von Ausgabetokens im geteilten Benchmark-Suite fast 5-mal günstiger ist als Gemini 3.5 Flash-Lite mit der Interactions API. Die geteilte Eingabe wird unabhängig von der Anzahl der bewerteten Fragen nur einmal pro Anfrage abgerechnet.
Die Abrechnungsstruktur der API, bei der nur die geteilte multimodale Eingabe pro Anfrage berechnet wird, unabhängig von der Anzahl der gestellten Fragen, schafft einen direkten wirtschaftlichen Anreiz für die Konsolidierung von Logik. Entwickler können dadurch komplexe Entscheidungsbausteine zusammenfassen, ohne dass die Kosten linear mit der Komplexität der Prüfung steigen, was die Skalierung von Echtzeit-Systemen mit hohem Durchsatz begünstigt.
Interne Anwendungsfälle bei Google
Verschiedene Teams bei Google nutzen die Decisions API bereits als Low-Latency-Control-Plane. In Gemini Notebook fungiert die API als Echtzeit-Router, der eingehende Abfragen an die optimale Modellstufe und das optimale Denkniveau weiterleitet und die Latenz für alltägliche Abfragen um bis zu 40 % senkt.
In Stitch, dem Design-Tool, wird die API verwendet, um spielbare Wireframes eines Produktflusses in Sekunden zu generieren und per Sprache oder Berührung fast sofortige Bearbeitungen vorzunehmen. In CC (von Google Labs) wird sie eingesetzt, um die passende Emoji-Reaktion aus einer Palette von über 200 Optionen in einem Bruchteil einer Sekunde auszuwählen. Darüber hinaus nutzt Google Search sie als Sicherheitsschicht, um adversariales Verhalten in MCP-Tools zu erkennen.
Verfügbarkeit und Grenzen der Evidenz
Entwickler können heute mit dem Bauen beginnen, indem sie einen API-Schlüssel in Google AI Studio abrufen. Die API bietet eine kostenlose Schicht für Prototyping und ist über Leitfäden für Python, JavaScript und REST verfügbar. Ökosystem-Integrationen werden auf Plattformen wie OpenRouter, LangChain, Vercel und LiteLLM ausgerollt, mit baldiger Unterstützung für Gemini in Google Cloud.
Es ist wichtig zu beachten, dass die Leistungs-, Latenz- und Kosteneinsparungszahlen Angaben von Google auf der Grundlage seiner eigenen Benchmarks sind. Es wurden keine unabhängigen Verifizierungen dieser Metriken noch Details zum spezifischen Kalibrierungsmechanismus des Modells bereitgestellt. Bevor sie für kritische Produktionseinsätze empfohlen wird, wäre es notwendig, die Zuverlässigkeit ihrer Wahrscheinlichkeiten in realen Szenarien zu bewerten und ihre Leistung mit anderen auf dem Markt verfügbaren Lösungen zu vergleichen.
Die Implementierung der API in bestehenden Workflows erfordert eine sorgfältige Validierung der Wahrscheinlichkeitskalibrierung im spezifischen Anwendungskontext, da die bereitgestellten Metriken auf internen Benchmarks basieren. Da keine unabhängigen Verifizierungen der Konfidenzpunkte vorliegen, ist es ratsam, die Robustheit des Modells unter realen Betriebsbedingungen zu testen, bevor es als alleinige Entscheidungsinstanz in kritischen Produktionsumgebungen eingesetzt wird.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen