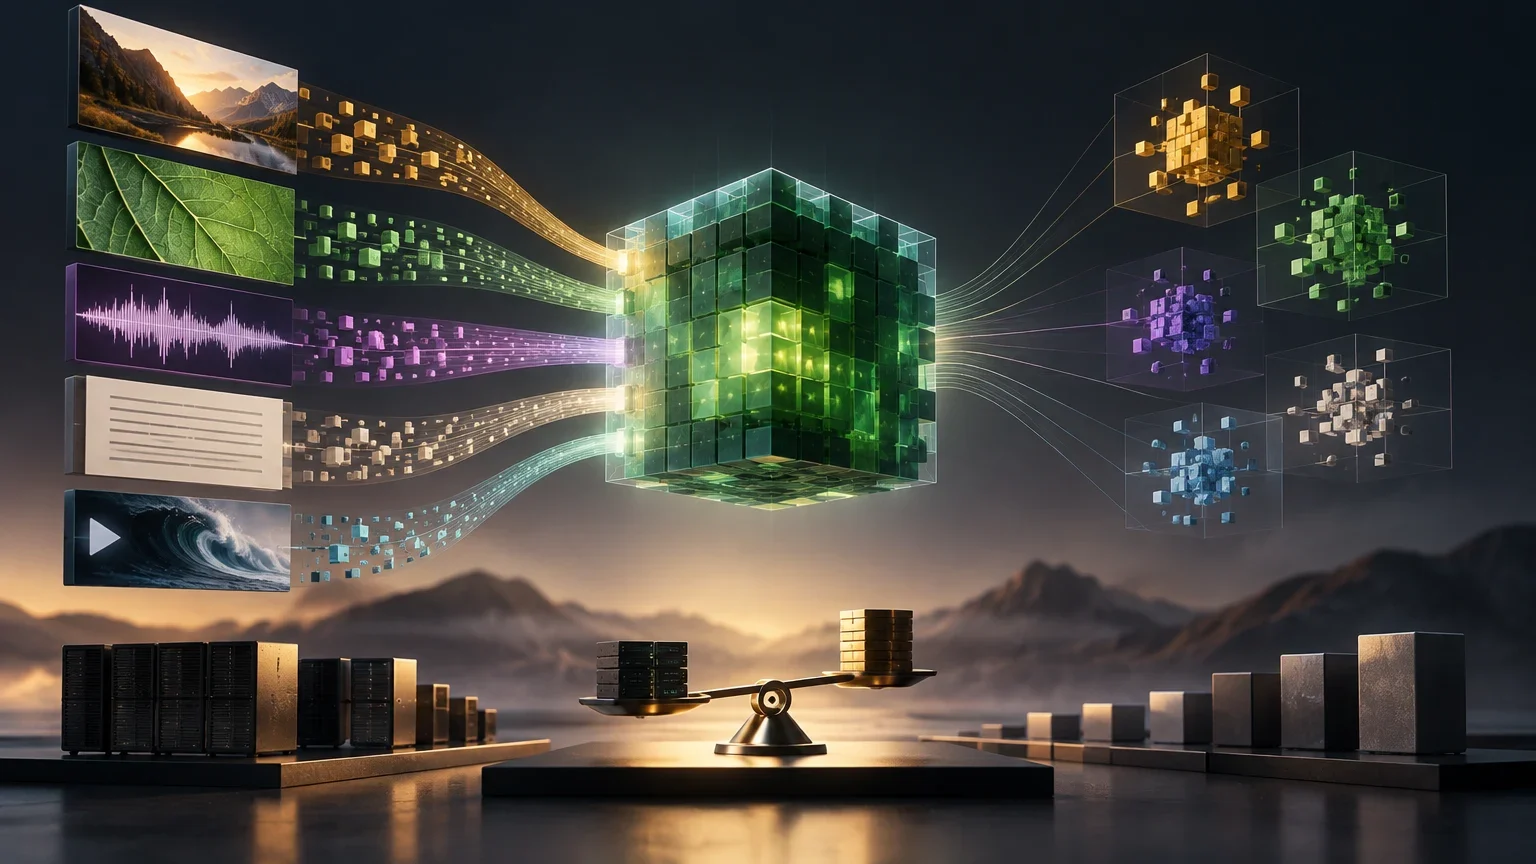
Was das genaue Modell leistet
Nemotron 3.5 Embed 1B BF16 ist ein Embedding-Modell mit 1,55 Milliarden Parametern, das von NVIDIA für die multimodale und mehrsprachige Dokumentenretrieval entwickelt wurde. Im Gegensatz zu seinen rein textbasierten Vorgängern akzeptiert dieses Modell Dokumente in Form von Bildern, Text oder einer Kombination aus beiden als Eingabe, während Suchanfragen ausschließlich textbasiert sind.
Die Architektur kombiniert einen Pixtral-Vision-Encoder, der aus Ministral-3-3B-Instruct-2512-BF16 initialisiert wurde, mit einem Sprachmodell, das aus Nemotron-3-Embed-1B-BF16 initialisiert wurde. Während des Destillationsprozesses vom Lehrmodell Nemotron-3.5-Embed-8B-BF16 wurde die Sprachkomponente eingefroren. Dies bedeutet, dass der textuelle Embedding-Raum identisch mit dem von Nemotron 3 Embed 1B ist, jedoch mit zusätzlichen Fähigkeiten zur visuellen Retrieval.
Die Rollen von Anfrage und Dokument sind asymmetrisch: Die Anfrage bleibt textuell, während ein indexiertes Dokument Text, ein Seitenbild oder beides enthalten kann. Die visuelle Komponente erweitert somit die Arten von Dokumenten, die für eine Suche dargestellt werden können. Sie macht aus dem Modell weder einen Chatbot noch ein System, das selbst eine ausformulierte Antwort erzeugt. Die Vektoren sind ein Baustein der Suche. Ob ein relevantes Dokument gefunden wird, hängt auch davon ab, welche Dokumente indexiert wurden und wie die Suche anschließend ausgewertet wird.
Der eingefrorene Sprachanteil und die zusätzliche visuelle Verarbeitung müssen getrennt interpretiert werden. Die beschriebene Kompatibilität des textuellen Raums betrifft Textrepräsentationen unter den entsprechenden Bedingungen. Sie belegt nicht automatisch eine bessere Qualität jedes bestehenden Suchsystems oder eine unveränderte Leistung bei jeder Kombination von Text und Bild. Für eine Integration ist zu prüfen, welche Dokumente mit welcher Vorbereitung verarbeitet werden sollen und ob die daraus entstehenden Repräsentationen für die vorgesehenen Anfragen geeignet sind.
Verifizierte technische Spezifikationen
Technische Merkmale und Eigenschaften des Embedding-Modells von NVIDIA.
| Parameter | Wert | Anmerkung |
|---|---|---|
| Gesamtparameter | 1,55 Mrd. | Enthält Embedding-Schichten |
| Inferenzparameter | 1,286 Mrd. | Ohne Embedding-Schichten |
| Ausgabedimension | 2048 | Unterstützt dynamische Dimensionen von 128 bis 2048 |
| Maximaler Kontext | 32.768 Tokens | Gemeinsam für Text und Bild |
| Evaluierte Textsprachen | 34 | Enthält Deutsch, Englisch, Chinesisch usw. |
| Evaluierte Bildsprachen | 18 | Enthält Deutsch, Englisch, Chinesisch usw. |
Fähigkeiten und Beispiele nach Aufgabe
Das Modell ist für RAG-Workflows (Retrieval-Augmented Generation) und semantische Suche konzipiert, in denen Dokumente nicht nur flacher Text sind, sondern PDF-Seiten, Infografiken oder gescannte Tabellen. Die Fähigkeit, direkt das Bild der Seite zu verarbeiten, ermöglicht es, strukturelle und visuelle Informationen zu erfassen, die bei einer traditionellen OCR-Extraktion verloren gehen würden.
Für Anfragen verwendet das Modell das Präfix 'query:' und für Dokumente das Präfix 'passage:'. Diese Unterscheidung ist für die Leistung entscheidend, da das Modell trainiert wurde, die Suchintention und den Dokumentinhalt asymmetrisch zu behandeln. Bilder werden standardmäßig mit einer längsten Kante von 1.120 Pixeln verarbeitet, die auf bis zu 1.540 Pixel erhöht werden kann, was den Token-Verbrauch im Kontext direkt beeinflusst.
Ein Seitenbild kann Informationen über Anordnung und visuelle Elemente enthalten, die in einem reinen OCR-Text anders oder unvollständig vorliegen. Diese zusätzliche Eingabemöglichkeit ist jedoch kein Nachweis, dass jedes Detail der Seite zuverlässig in der Suche berücksichtigt wird. Bei Tabellen oder Infografiken sollte die Prüfung deshalb konkrete Anfragen und relevante Seiten enthalten. Die im Modell vorgesehenen Präfixe für Anfragen und Dokumente gehören zur Eingabevorbereitung; sie ersetzen die Bewertung der gefundenen Ergebnisse nicht. Auch die gemeinsame Kontextgrenze für Text und Bild muss beim Vorbereiten der Seiten berücksichtigt werden.
Benchmarks und veröffentlichte Methodik
NVIDIA berichtet Ergebnisse in zwei Haupt-Benchmarks: ViDoRe V3 für die visuelle Dokumentenretrieval und MIRACL-VISION für die mehrsprachige visuelle Retrieval. Die verwendete Metrik ist NDCG@10, die die Qualität der Retrieval der 10 relevantesten Dokumente bewertet.
Es ist wichtig zu beachten, dass diese Ergebnisse vom Anbieter bereitgestellt werden und zum Zeitpunkt der Erstellung dieser Analyse nicht unabhängig von Dritten reproduziert wurden. Die Ergebnisse zeigen, dass das 1B-Modell in mehreren Kategorien 2B-Modelle anderer Familien übertrifft, während das 8B-Modell derselben NVIDIA-Familie leicht höhere Punktzahlen erzielt.
Benchmark-Ergebnisse zeigen die Leistung innerhalb des jeweiligen Datensatzes und Bewertungsverfahrens. Eine höhere Punktzahl gegenüber einem aufgeführten Vergleichsmodell erlaubt keine uneingeschränkte Aussage über andere Dokumente, Sprachen oder Aufgaben. Insbesondere sind die verschiedenen Modalitäten und Benchmarks getrennt zu lesen, statt eine einzelne Spalte zur allgemeinen Rangliste zu erklären. Die vom Anbieter berichteten Resultate können den Ausgangspunkt einer eigenen Auswahl bilden. Eine unabhängige Reproduktion oder eine Messung für den eigenen Dokumentbestand entsteht daraus erst durch eine tatsächlich durchgeführte Auswertung.
Benchmark-Ergebnisse (NDCG@10)
Benchmark-Ergebnisse von NVIDIA im Vergleich mit Referenzmodellen.
| Modell | ViDoRe V3 (Bild) | ViDoRe V3 (Text) | ViDoRe V3 (Bild+Text) | MIRACL-VISION (Bild) |
|---|---|---|---|---|
| Qwen3-VL-Embedding-2B | 52,89 | 48,31 | 51,97 | 58,42 |
| Nemotron-3.5-Embed-1B-BF16 | 58,02 | 57,80 | 58,82 | 68,93 |
| Qwen3-VL-Embedding-8B | 58,29 | 53,69 | 57,03 | 68,33 |
| Nemotron-3.5-Embed-8B-BF16 | 60,39 | 60,65 | 61,47 | 72,64 |
Preis und Deployment-Anforderungen
Das Modell ist öffentlich auf Hugging Face unter der Lizenz OpenMDW 1.1 verfügbar, was eine kommerzielle Nutzung unter den Bedingungen dieser Lizenz erlaubt. Es gibt keine offizielle NVIDIA-API für dieses spezifische Modell, daher sind die Hauptkosten die für den Betrieb erforderliche GPU-Infrastruktur.
Für das Deployment empfiehlt NVIDIA GPUs der Architekturen Ampere, Hopper oder Blackwell. Die optimierte Konfiguration für den BF16-Checkpoint verwendet FP16-Präzision bei der Inferenz, obwohl der Checkpoint in BF16 gespeichert ist. Das Modell erfordert mindestens 8 CPU-Kerne und unterstützt Multi-Instance GPU (MIG) in bestimmten Hardware-Konfigurationen.
Öffentlich verfügbare Gewichte und die Kosten ihres Betriebs sind verschiedene Fragen. Bei einem eigenen Deployment müssen die Rechenressourcen und die Integration berücksichtigt werden, auch wenn für den Download kein nutzungsabhängiger API-Tarif anfällt. Die unterstützte Hardware und die eingesetzte Präzision müssen zur konkreten Konfiguration passen. Eine Speicher- oder Hardwareangabe allein legt weder eine feste Antwortzeit noch den Durchsatz unter der vorgesehenen Last fest. Für den Vergleich mit einer anderen Bereitstellung werden deshalb Messungen unter vergleichbaren Bedingungen und die jeweils geltenden Nutzungsbedingungen benötigt.
Optimierte GPU-Konfigurationen
Unterstützte GPUs und Präzisionen für NVIDIA NeMo Retriever Embedding NIM.
| GPU | Unterstützte Präzision | Anmerkung |
|---|---|---|
| NVIDIA GB200 | NVFP4 und FP16 | Unterstützt MIG |
| NVIDIA H100 80GB | FP16 | Standardkonfiguration |
| NVIDIA A100 80GB | FP16 | Standardkonfiguration |
| NVIDIA L40S | FP16 | Standardkonfiguration |
| NVIDIA A10G | FP16 | Standardkonfiguration |
Einschränkungen, Sicherheit und Alternativen
Die Hauptbeschränkung ist der maximale Kontext von 32.768 Tokens, der zwischen Text und Bild-Tokens geteilt wird. Wenn ein hochauflösendes Bild den Großteil dieses Kontexts verbraucht, wird der für Text verfügbare Raum erheblich reduziert. Außerdem garantiert das Modell nicht, dass das richtige Dokument für eine gegebene Anfrage abgerufen wird, daher muss es in einem RAG-Pipeline mit Reranking-Stufen integriert werden.
Was die Sicherheit betrifft, warnt NVIDIA, dass Entwickler die Rechte an Eingabebildern überprüfen und Risiken hinsichtlich Bias und Privatsphäre berücksichtigen sollten. Das Modell enthält keine spezifischen Mechanismen zur Bias-Minderung, daher erfordert seine Verwendung in sensiblen Kontexten eine zusätzliche Bewertung.
Die gemeinsame Kontextgrenze bedeutet, dass Text und Bild nicht unabhängig voneinander beliebig erweitert werden können. Eine Integration muss bestimmen, welche Inhalte für die Suche erhalten bleiben sollen, wenn die verfügbare Kapazität nicht für alles ausreicht. Eine technische Verarbeitung ohne Fehlermeldung beweist dabei noch nicht, dass alle relevanten Informationen im Ergebnis berücksichtigt wurden. Dasselbe gilt für die Sicherheit: Rechte an Bildern, mögliche Verzerrungen und Datenschutz müssen getrennt geprüft werden. Ein guter Suchtreffer oder die Verfügbarkeit einer Lizenz beantwortet diese Fragen nicht automatisch.
Praktische Auswahlkriterien
Die Wahl von Nemotron 3.5 Embed 1B BF16 gegenüber anderen Optionen hängt von mehreren Faktoren ab. Wenn der Dokumentenkorpus einen erheblichen Anteil an Bildern, Tabellen oder Infografiken enthält, bietet dieses Modell einen klaren Vorteil gegenüber rein textbasierten Embedding-Modellen. Seine Größe von 1B Parametern macht es in Bezug auf Latenz und GPU-Kosten effizienter als das 8B-Modell, mit einem moderaten Leistungseinbuße.
Für Teams, die bereits Nemotron 3 Embed 1B für Text verwenden, ist die Migration zur Version 3.5 im textuellen Embedding-Raum direkt möglich, was die Integration erleichtert. Wenn die Nutzung jedoch ausschließlich textbasiert ist und das GPU-Budget begrenzt ist, könnte es sinnvoll sein, das vorherige Modell beizubehalten oder Alternativen von Drittanbietern mit niedrigeren API-Preisen zu erkunden.
Die kleinere Variante ist ein Kandidat, wenn der verfügbare GPU-Rahmen oder die Kosten eine größere Variante unpraktisch machen. Ob der Kompromiss für die gewünschte Aufgabe passt, muss aber anhand derselben Anfragen und Relevanzkriterien verglichen werden. Ein rein textueller Bestand stellt andere Anforderungen als Seiten mit wichtigen visuellen Informationen. Die Entscheidung sollte daher von den Dokumenten und dem benötigten Ergebnis ausgehen und anschließend Qualität, Laufzeit und Betriebskosten zusammen betrachten. Ein allgemeiner Größenvorteil ersetzt keinen Nachweis für die tatsächliche Einsatzkonfiguration.
Entscheidungsprozess für die Einführung
Empfohlene Schritte zur Bewertung der Implementierung des Modells.
- 01Anteil der Dokumente mit Bildern im Korpus bewerten
- 02Kompatibilität der verfügbaren GPU-Hardware überprüfen
- 03Leistungstests mit eigenen Daten durchführen
- 04Inferenz-Latenz und -Kosten mit Alternativen vergleichen
- 05In die RAG-Pipeline mit Reranking-Stufen integrieren
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen