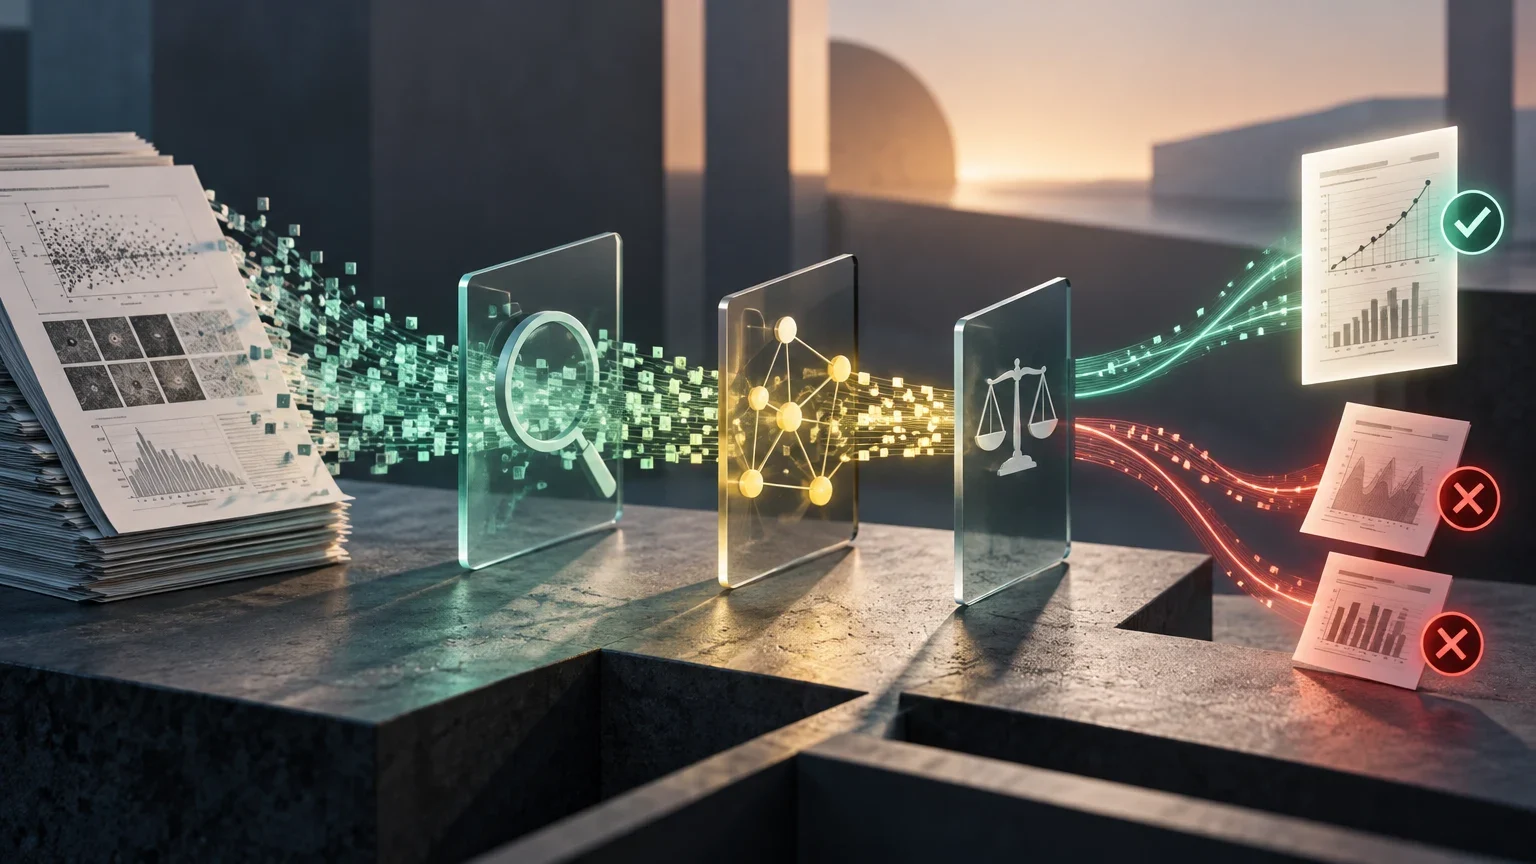
Le problème de la surinterprétation et la validité interne
Dans la littérature sur l'intelligence artificielle, il est fréquent que la conclusion finale d'un article excède la portée des données expérimentales présentées. Cette surinterprétation n'implique pas toujours de mauvaise foi ; elle découle souvent de la complexité des systèmes évalués et de la pression pour communiquer des résultats percutants. Pour le chercheur ou l'ingénieur devant prendre des décisions de conception, distinguer ce qui a été mesuré de ce qui a été inféré est une compétence critique.
La validité interne désigne la capacité d'une étude à établir une relation causale ou d'association fiable entre les variables manipulées et les résultats observés, en contrôlant les facteurs de confusion. Contrairement à la validité externe, qui aborde la généralisation à d'autres contextes, la validité interne se concentre sur la cohérence inférentielle au sein des conditions expérimentales spécifiques. Un papier peut avoir une exécution technique irréprochable mais manquer de validité interne si la métrique rapportée ne mesure pas directement le construit affirmé dans la conclusion.
Étape 1 : Identifier l'observation directe
La première étape de l'audit consiste à isoler quelles données brutes ou résultats expérimentaux sont présentés dans l'article. Cela implique de lire la section des résultats et les annexes techniques pour déterminer ce qui a été mesuré exactement. Dans de nombreux papiers IA, l'observation directe est un nombre : un score sur un benchmark, un taux d'erreur ou une métrique d'efficacité computationnelle.
Il est fondamental de vérifier comment cette observation a été mesurée. Un jeu de données standard ou propre a-t-il été utilisé ? La métrique est-elle automatique (comme la précision dans une tâche de classification) ou nécessite-t-elle un jugement humain (comme l'évaluation de la cohérence d'une réponse générative) ? Les guides de vérification de l'Université d'Extrémadura soulignent que la responsabilité de vérifier la source originale des données incombe au lecteur, car les outils automatiques ou les résumés peuvent omettre des détails cruciaux sur la provenance de l'information.
Étape 2 : Tracer l'inférence et les hypothèses implicites
Une fois l'observation identifiée, le lecteur doit tracer le chemin logique suivi par les auteurs pour atteindre leur interprétation. C'est là que résident souvent les hypothèses non déclarées. Par exemple, si un modèle s'améliore sur une métrique de raisonnement logique, les auteurs peuvent inférer que le modèle a développé une capacité de raisonnement abstrait. Cependant, il est possible que le modèle ait simplement appris des motifs superficiels des données d'entraînement qui coïncident avec la structure des questions du benchmark.
Lluís Codina, dans son analyse sur la synthèse des preuves, souligne l'importance de la validité de construit : la capacité d'un instrument à mesurer ce qu'il prétend mesurer. Si l'opérationnalisation (la façon de mesurer) n'est pas alignée avec le construit théorique (la capacité affirmée), l'inférence est invalide. Le lecteur doit chercher dans la section de discussion si les auteurs reconnaissent ces hypothèses ou s'ils présentent l'inférence comme un fait démontré.
Types d'inférence dans les papiers IA
Classification des sauts logiques courants et de leur niveau de risque.
| Type d'inférence | Description | Risque de surinterprétation |
|---|---|---|
| Corrélation à Causalité | Affirmer que A cause B parce que A et B varient ensemble. | Élevé |
| Benchmark à Capacité | Affirmer qu'un score élevé implique une compréhension profonde du domaine. | Moyen-Élevé |
| Efficacité à Robustesse | Affirmer qu'un modèle rapide est fiable en conditions de production. | Moyen |
Étape 3 : Détecter les explications alternatives
La validité interne est compromise s'il existe des explications alternatives plausibles pour le résultat observé qui n'ont pas été contrôlées. Dans les expériences IA, ces explications incluent souvent : le hasard (variabilité statistique), le surapprentissage aux données d'évaluation, ou l'influence d'hyperparamètres non optimisés dans le modèle de contrôle.
Pour auditer cette étape, le lecteur doit vérifier si le papier rapporte des intervalles de confiance ou effectue des tests de significativité statistique. Si les résultats sont présentés comme des points uniques sans mesures d'incertitude, il est impossible de déterminer si la différence observée est réelle ou un artefact du bruit. De plus, il faut vérifier si des variables de confusion, comme la température d'échantillonnage ou la longueur de l'entrée, qui pourraient influencer les performances du modèle, ont été contrôlées.
Checklist de contrôle des facteurs de confusion
Questions pour vérifier si les variables alternatives ont été contrôlées.
- 01Des intervalles de confiance ou des écarts-types sont-ils rapportés ?
- 02Une analyse de variance (ANOVA) ou des tests t ont-ils été réalisés ?
- 03L'aléatoire dans l'initialisation des poids a-t-il été contrôlé ?
- 04Les performances ont-elles été évaluées sur plusieurs graines aléatoires ?
Étape 4 : Vérifier la portée de l'affirmation
La quatrième étape consiste à comparer la conclusion finale du papier avec la portée des données présentées. Une affirmation est valide uniquement si elle se limite aux conditions expérimentales dans lesquelles l'étude a été réalisée. Si les auteurs généralisent leurs résultats à d'autres domaines, tailles de modèle ou types de données sans preuve supplémentaire, l'affirmation excède sa portée.
Le cadre RAISE, adopté par Cochrane, Campbell, JBI et CEE, établit que la responsabilité ultime de l'intégrité de la synthèse incombe à l'auteur. Cela implique que l'auteur doit justifier pourquoi ses méthodes sont appropriées pour le contexte spécifique et déclarer les limites. Lors de l'audit, le lecteur doit vérifier si la section des limites est honnête et si les conclusions sont nuancées adéquatement. Si la conclusion est absolue (« le modèle X est supérieur ») tandis que les données ne montrent qu'un avantage marginal dans un domaine spécifique, il y a une divergence entre la preuve et l'affirmation.
Étape 5 : Formuler des questions de vérification
Pour intégrer cet audit dans le flux de travail, le lecteur doit appliquer une série de questions de vérification systématiques. Ces questions permettent de distinguer les observations directes, les interprétations et les affirmations non étayées. Le guide de l'Université d'Oviedo sur la vérification des contenus IA souligne l'importance de vérifier les sources et de déclarer l'utilisation des outils, un principe qui se transpose à la lecture critique : ne pas valider une donnée sans vérifier son origine et son contexte.
L'application de ces questions ne nécessite pas de formation statistique avancée, mais exige rigueur et patience. L'objectif n'est pas d'invalider le travail des auteurs, mais de comprendre avec précision ce qui a été démontré et ce qui a été suggéré. Cette distinction est vitale pour prendre des décisions de conception éclairées et pour éviter la propagation d'affirmations erronées dans la littérature et l'industrie.
Checklist d'audit de la chaîne de preuve
Questions clés à appliquer lors de la lecture d'un papier IA.
| Question de vérification | Ce qu'il faut chercher dans le papier |
|---|---|
| La métrique mesure-t-elle ce qui est affirmé ? | Définition de la métrique et alignement avec le construit théorique. |
| Les variables de confusion ont-elles été contrôlées ? | Section des méthodes et analyse de sensibilité. |
| Des mesures d'incertitude sont-elles rapportées ? | Intervalles de confiance, écarts-types, p-valeurs. |
| La conclusion excède-t-elle la portée des données ? | Section des conclusions et des limites. |
| Des explications alternatives existent-elles ? | Discussion des résultats et analyse des erreurs. |
Exemples hypothétiques et application pratique
Considérons un papier évaluant un agent IA dans une tâche de planification. Le papier rapporte que l'agent atteint l'objectif dans 90 % des cas, contre 70 % pour un modèle antérieur. L'observation directe est le taux de succès. L'inférence des auteurs est que le nouvel agent « a une meilleure capacité de planification ». Cependant, lors de l'audit, on découvre que le jeu de données d'évaluation ne contient que des tâches de faible complexité, où le modèle antérieur échouait par des erreurs de syntaxe, et non par manque de planification. L'explication alternative est que le nouveau modèle est plus robuste aux erreurs de syntaxe, et non qu'il planifie mieux. L'affirmation de « meilleure planification » excède la portée des données.
Dans un autre cas, un papier sur les modèles de contexte long rapporte une amélioration de la cohérence narrative. La métrique utilisée est un score automatique de similarité sémantique. L'inférence est que le modèle « comprend mieux la narration ». L'audit révèle que la métrique de similarité sémantique ne capture ni la cohérence causale ni la structure argumentative, seulement la répétition de termes. Par conséquent, l'observation ne soutient pas l'affirmation de « compréhension narrative ». Ces exemples illustrent comment l'application du protocole en cinq étapes permet de détecter les surinterprétations courantes dans la littérature IA.
Questions ouvertes
- Les sources fournies ne proposent pas un cadre spécifique pour l'audit des expériences IA, mais des directives générales de vérification et de synthèse des preuves.
- L'application du protocole en cinq étapes nécessite un jugement expert et ne peut pas être entièrement automatisée, car l'identification des hypothèses implicites dépend du contexte du domaine.
- Il n'y a pas de données quantitatives sur la fréquence de la surinterprétation dans la littérature IA, la prévalence de ces erreurs restant une estimation qualitative.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction