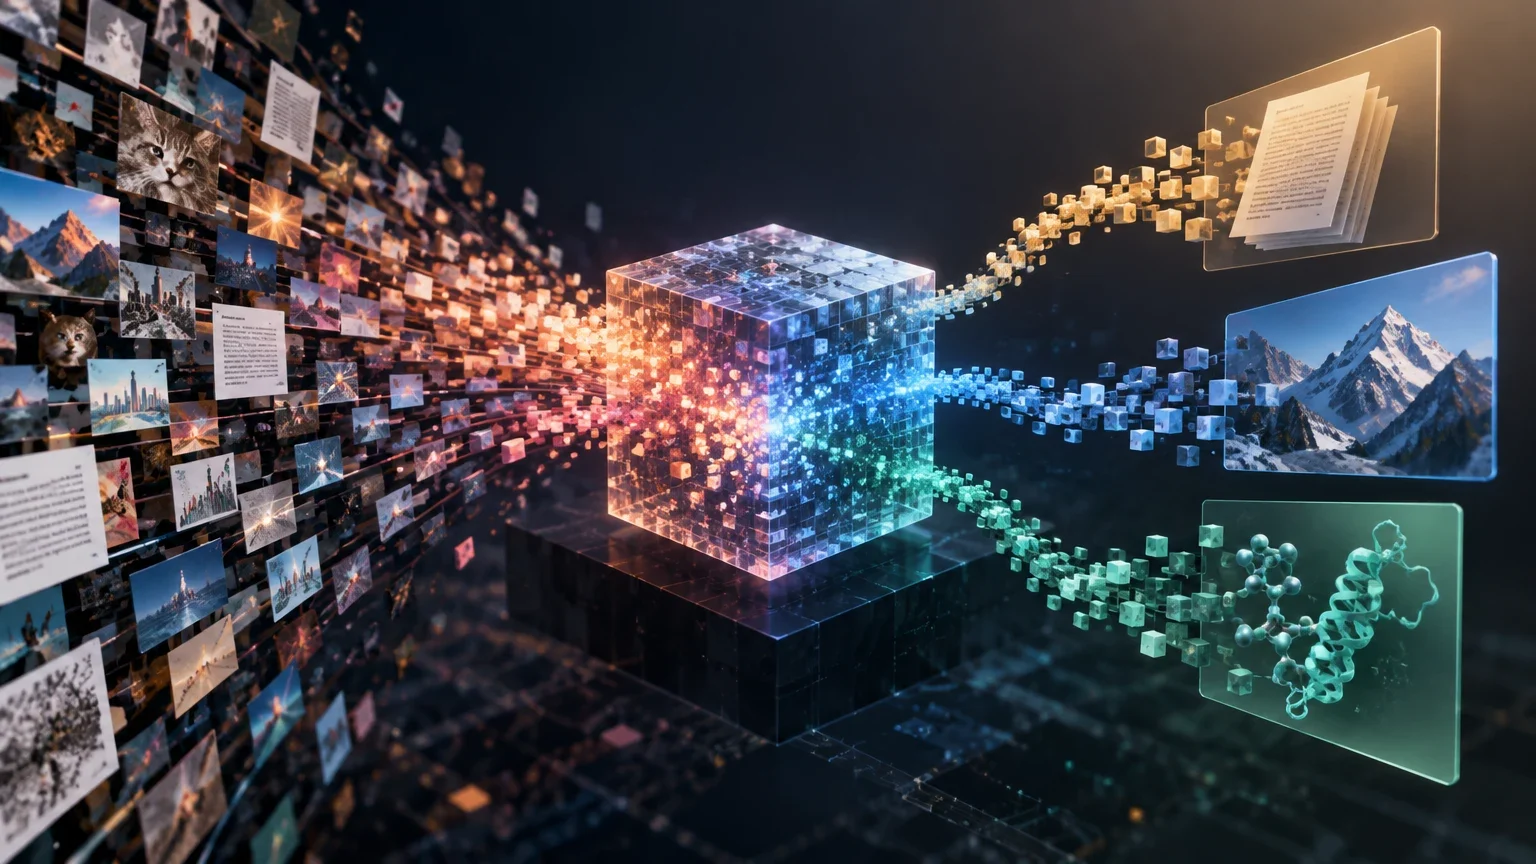
Introduction : le pré-entraînement comme phase préalable à la spécialisation
Le pré-entraînement est la phase au cours de laquelle un modèle d'apprentissage automatique est entraîné avant d'être adapté à une tâche concrète. Plutôt que de partir d'une initialisation aléatoire pour résoudre directement un problème spécifique, le modèle apprend des représentations générales à partir d'un vaste ensemble de données. Cette phase est particulièrement pertinente pour les modèles de grande échelle, où le coût computationnel de la construction d'un système depuis zéro peut être élevé et où les représentations apprises peuvent être réutilisées dans de multiples applications ultérieures.
L'importance du pré-entraînement ne réside pas uniquement dans la rapidité de développement, mais aussi dans la possibilité d'exploiter un savoir préalable. Un modèle qui a déjà observé des motifs généraux du langage, des images ou d'autres signaux peut partir d'une base plus solide lorsqu'il est confronté à un domaine plus restreint. Ainsi, l'équipe d'ingénierie peut consacrer plus d'efforts à la qualité des données de la tâche finale, à l'évaluation et à l'intégration du système, plutôt que de reproduire un entraînement initial coûteux.
Néanmoins, le pré-entraînement n'élimine pas le besoin de valider le modèle pour chaque cas d'usage. Les représentations apprises dépendent du corpus, de l'architecture, de l'objectif d'entraînement et des contraintes de données. Dans la pratique actuelle, le pré-entraînement est compris comme une phase explicite du cycle de vie du modèle, distincte de l'adaptation ultérieure. Par conséquent, une fiche technique sur ce concept doit distinguer ce qui est affirmé comme pratique courante de ce qui nécessite une preuve spécifique pour chaque configuration.
Définition technique et portée de la phase
Techniquement, le pré-entraînement peut être défini comme l'entraînement initial d'un modèle avec un objectif d'apprentissage qui n'est pas nécessairement lié à la tâche finale. Dans de nombreux cas, cet objectif est auto-supervisé : le modèle prédit des parties de la donnée elle-même, comme des mots masqués dans un texte ou des régions d'une image, sans nécessiter d'étiquettes humaines complètes. Le signal de supervision est dérivé de la structure de la donnée, ce qui permet de mettre à l'échelle l'entraînement à de grands volumes sans dépendre exclusivement de l'annotation manuelle.
La portée de la phase inclut la sélection de l'architecture, la préparation du corpus, la définition de la fonction de perte ou de la fonction de récompense, la configuration des hyperparamètres et l'optimisation des paramètres internes. Le résultat n'est pas un système terminé pour la production, mais un ensemble de poids qui encapsule des motifs généraux. Ces poids peuvent être utilisés comme point de départ pour un fine-tuning, pour une extraction de caractéristiques ou pour une évaluation ultérieure.
Il est utile de séparer le pré-entraînement de l'entraînement de la tâche finale. Le premier vise à construire une représentation large ; le second vise à la spécialiser. En pratique, les deux sont des processus d'entraînement, mais ils diffèrent par les données, l'objectif, l'échelle et les critères de succès. Les confondre peut conduire à s'attendre à ce qu'un modèle pré-entraîné résolve directement une tâche sans adaptation, ou à négliger la nécessité d'évaluer son comportement dans le domaine cible.
Processus typique : données, objectif et architecture
Un processus de pré-entraînement commence généralement par la définition du domaine de données. En langage naturel, le corpus peut inclure des textes d'Internet, des documents techniques ou des conversations ; en vision, il peut inclure des images étiquetées ou non ; dans d'autres domaines, il peut inclure des signaux, des séries temporelles ou des données structurées. La qualité, la diversité et la représentativité du corpus conditionnent les motifs que le modèle apprendra et les biais qu'il peut incorporer.
Ensuite, l'objectif d'apprentissage est choisi. Dans les modèles de langage, un objectif courant est de prédire des jetons manquants ou le mot suivant ; en vision, il peut s'agir de classifier des images, de reconstruire des régions ou d'apprendre des représentations contrastives. L'objectif détermine la fonction de perte et la manière dont le modèle reçoit un retour d'information. Si l'objectif est trop étroit, la représentation peut devenir moins réutilisable ; s'il est trop générique, il peut ne pas capturer les détails nécessaires pour les tâches ultérieures.
L'architecture définit la manière dont les entrées sont transformées en représentations internes. Les réseaux de neurones profonds, les transformeurs et d'autres structures permettent de capturer des relations de longue portée, des hiérarchies visuelles ou des motifs séquentiels. Lors du pré-entraînement, les paramètres sont ajustés itérativement au moyen d'optimiseurs, de contrôle des lots, de programmation du taux d'apprentissage et de techniques de stabilité. Le processus est répété jusqu'à ce que le modèle atteigne une performance acceptable sur l'objectif choisi, bien que cette performance n'équivaut pas au succès sur la tâche finale.
Flux opérationnel simplifié
Séquence minimale pour planifier un pré-entraînement ou évaluer un pré-entraînement existant.
- 01Définir le domaine et la qualité du corpus
- 02Choisir l'architecture et l'objectif d'apprentissage
- 03Configurer la fonction de perte, l'optimiseur et les hyperparamètres
- 04Entraîner avec validation et contrôle du surapprentissage
- 05Évaluer la réutilisation des poids sur des tâches connexes
Exemples appliqués en langage, vision et biomédical
En langage naturel, un exemple clair est l'adaptation d'un modèle de langage pré-entraîné pour classifier des avis. Le modèle part de poids entraînés sur un texte large, puis s'adapte à un ensemble d'avis étiquetés. Dans le cas documenté, un modèle de type BERT est utilisé, les avis sont tokenisés, une tête de classification initialisée aléatoirement est ajoutée et l'ensemble des paramètres ou une partie d'entre eux est entraîné pour distinguer les catégories d'opinion. Ce flux montre comment le pré-entraînement réduit le besoin de construire un classifieur depuis zéro.
En vision par ordinateur, le pré-entraînement apparaît lorsqu'un modèle a appris des caractéristiques visuelles de base sur un vaste ensemble d'images, puis est transféré à une tâche de détection, de segmentation ou de classification. Par exemple, des poids entraînés sur un corpus d'objets courants peuvent servir à initier l'entraînement dans un domaine industriel, médical ou de sécurité. La documentation technique décrit que ce transfert peut accélérer l'entraînement et améliorer les performances, car le modèle part d'une compréhension solide des bords, des textures et des formes.
Dans le domaine biomédical, la même logique s'applique lorsqu'on souhaite adapter un modèle de vision ou de langage à des images médicales, des rapports cliniques ou des données de recherche. Cependant, les sources fournies ne décrivent pas d'expérience biomédicale concrète avec des métriques vérifiables, de sorte que cet exemple doit être lu comme une application plausible du transfert d'apprentissage, et non comme un résultat démontré. Dans ce domaine, en outre, l'évaluation doit être particulièrement rigoureuse en raison des implications cliniques, réglementaires et de confidentialité.
Confusions fréquentes avec le fine-tuning et l'inférence
Une confusion courante consiste à traiter le pré-entraînement et le fine-tuning comme s'ils étaient la même chose. Les deux impliquent de mettre à jour des paramètres, mais ils ne poursuivent pas le même but. Le pré-entraînement construit une représentation générale ; le fine-tuning spécialise cette représentation pour une tâche ou un domaine. En pratique, le fine-tuning utilise souvent moins de données que le pré-entraînement, bien qu'il puisse nécessiter de la prudence pour ne pas dégrader le savoir préalable.
Une autre confusion consiste à supposer qu'un modèle pré-entraîné est prêt pour une inférence directe. L'inférence est l'étape où le modèle déjà entraîné produit des prédictions sur de nouvelles entrées. Un modèle pré-entraîné peut être utilisé pour l'inférence sur sa tâche d'origine, mais si la tâche finale est différente, il a normalement besoin d'une adaptation. De plus, l'inférence ne met pas à jour les poids ; elle les utilise uniquement.
Il est également fréquent de confondre le pré-entraînement avec le simple chargement de poids. Charger un modèle pré-entraîné ne garantit pas qu'il soit adapté au problème. Il faut vérifier la compatibilité de l'architecture, du vocabulaire, de la taille d'entrée, de la licence, de la qualité du corpus et du comportement dans le domaine cible. Il est également utile de situer le pré-entraînement par rapport à d'autres techniques de transfert, comme la distillation de modèles, qui vise à transférer le comportement entre modèles, et par rapport à l'inférence, qui ne met pas à jour les paramètres.
Différences opérationnelles
Tableau de décision pour distinguer les phases.
| Aspect | Pré-entraînement | Fine-tuning | Inférence |
|---|---|---|---|
| Objectif | Construire des représentations générales | Spécialiser le modèle pour une tâche | Produire des prédictions sans mettre à jour les poids |
| Données | Corpus large, souvent non étiqueté | Données spécifiques à la tâche | Nouvelles entrées au moment de l'utilisation |
| Mise à jour des paramètres | Oui, à grande échelle | Oui, souvent partielle ou complète | Non |
| Risque principal | Biais du corpus et coût | Surapprentissage ou dégradation du savoir préalable | Latence, précision et déploiement |
Limites inhérentes et considérations pratiques
Le pré-entraînement n'élimine pas le besoin de données de qualité pour la tâche finale. Si le domaine cible diffère considérablement du corpus initial, les représentations apprises peuvent être insuffisantes ou contre-productives. Dans ces cas, il peut être nécessaire d'élargir le corpus, de changer l'objectif de pré-entraînement, d'utiliser un modèle différent ou d'entraîner depuis zéro. La décision doit se baser sur des évaluations comparatives, et non sur la supposition qu'un modèle grand ou populaire est automatiquement le meilleur.
Il existe également des limites pratiques liées aux ressources computationnelles, à la mémoire, au temps d'entraînement et à la stabilité. Le pré-entraînement de grands modèles peut nécessiter plusieurs accélérateurs, des stratégies de précision mixte, un contrôle des lots et des techniques d'efficacité. Dans les projets aux ressources limitées, il peut être plus raisonnable d'utiliser un modèle pré-entraîné plus petit ou un sous-ensemble de données pour itérer rapidement, bien que cela ne remplace pas la validation finale.
L'évaluation doit prendre en compte les métriques de la tâche, la robustesse, les biais, la confidentialité et les exigences réglementaires. Un modèle peut s'améliorer sur un ensemble de validation et échouer sur des sous-populations sous-représentées, dans des conditions de bruit ou sur des entrées hors distribution. C'est pourquoi les critères pratiques incluent des tests sur des données représentatives, une analyse des erreurs, une comparaison avec des lignes de base et une documentation des limites connues.
Questions ouvertes
- Les sources ne permettent pas de vérifier un cas biomédical concret avec des métriques comparatives ; l'exemple biomédical est présenté comme une application plausible.
- Il ne peut pas être affirmé que le pré-entraînement réduit toujours les coûts ou améliore toujours les performances ; cela dépend de l'architecture, du corpus, de la tâche et des ressources.
- La documentation fournie n'établit pas de révision par les pairs ni de réplication indépendante des résultats décrits.
- Il n'existe pas de preuves suffisantes pour généraliser les recommandations d'un outil de vision à tous les modèles d'apprentissage automatique.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction