Ce préprint rassemble des événements résolus et des actualités datées afin d’évaluer des agents à différents moments du passé. Son résumé fait état d’améliorations grâce aux outils de recherche pour 12 modèles, même si tous restent derrière les prévisions historiques du marché.
Ce benchmark évalue des agents qui tentent de reconstruire des résultats d’articles d’apprentissage automatique à partir des ressources publiées et dans le respect d’un budget GPU fixé. Les taux de réussite signalent une difficulté croissante, mais ne permettent pas de déterminer si les conclusions scientifiques des articles sont valides.
Ce benchmark rassemble 799 cas de banque de détail indienne et examine la sécurité, l’usage des outils, les réponses et les conseils. Ses auteurs estiment qu’une réussite ponctuelle ne suffit pas à mesurer la fiabilité.
Un préprint décrit un système qui consulte, au moment de l’inférence, des définitions de l’information sensible propres à chaque domaine. Ses premiers résultats indiquent une meilleure détection que celle d’un classificateur de référence dans la plupart des combinaisons testées. Toutefois, les informations disponibles ne permettent pas d’évaluer toutes les erreurs ni de déterminer si le système est prêt pour un usage réel.
Akamai a confirmé un engagement pluriannuel visant à fournir à Anthropic des capacités de calcul, notamment pour des charges de travail reposant sur des processeurs CPU. Des informations antérieures évoquaient un accord de 1,8 milliard de dollars ; l’annonce ultérieure porte le montant de l’engagement élargi à 11,6 milliards. Ces termes ne prouvent pas que toutes les capacités soient déjà opérationnelles.
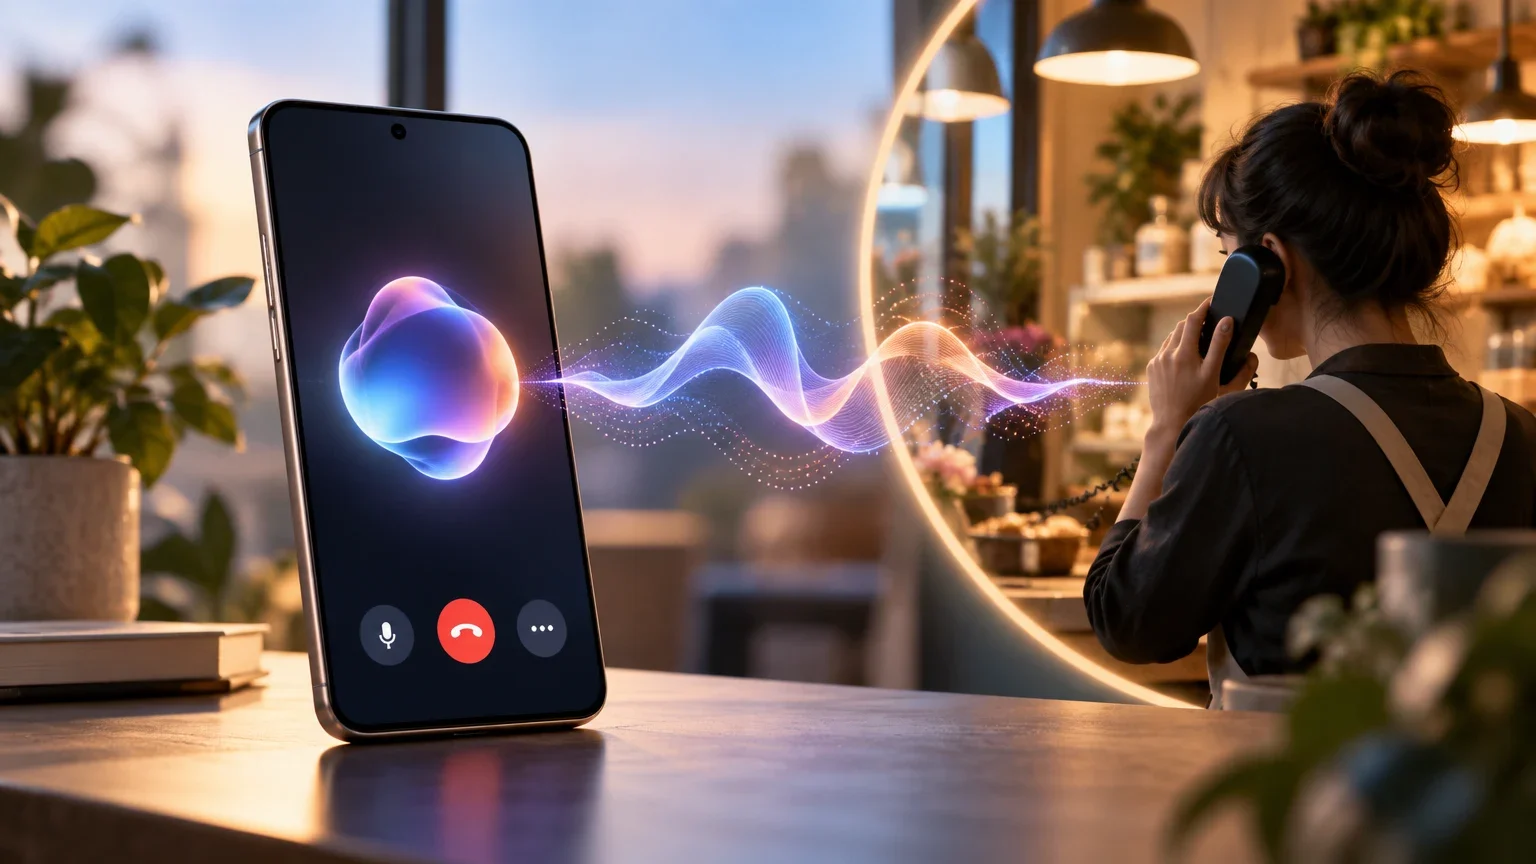
Le pilote de Google permet à Gemini de gérer certains appels simples au nom de l’utilisateur. Pour l’instant, il est réservé aux propriétaires d’un Pixel 11 aux États-Unis qui paient un abonnement Gemini. La personne peut suivre l’appel et reprendre la main.
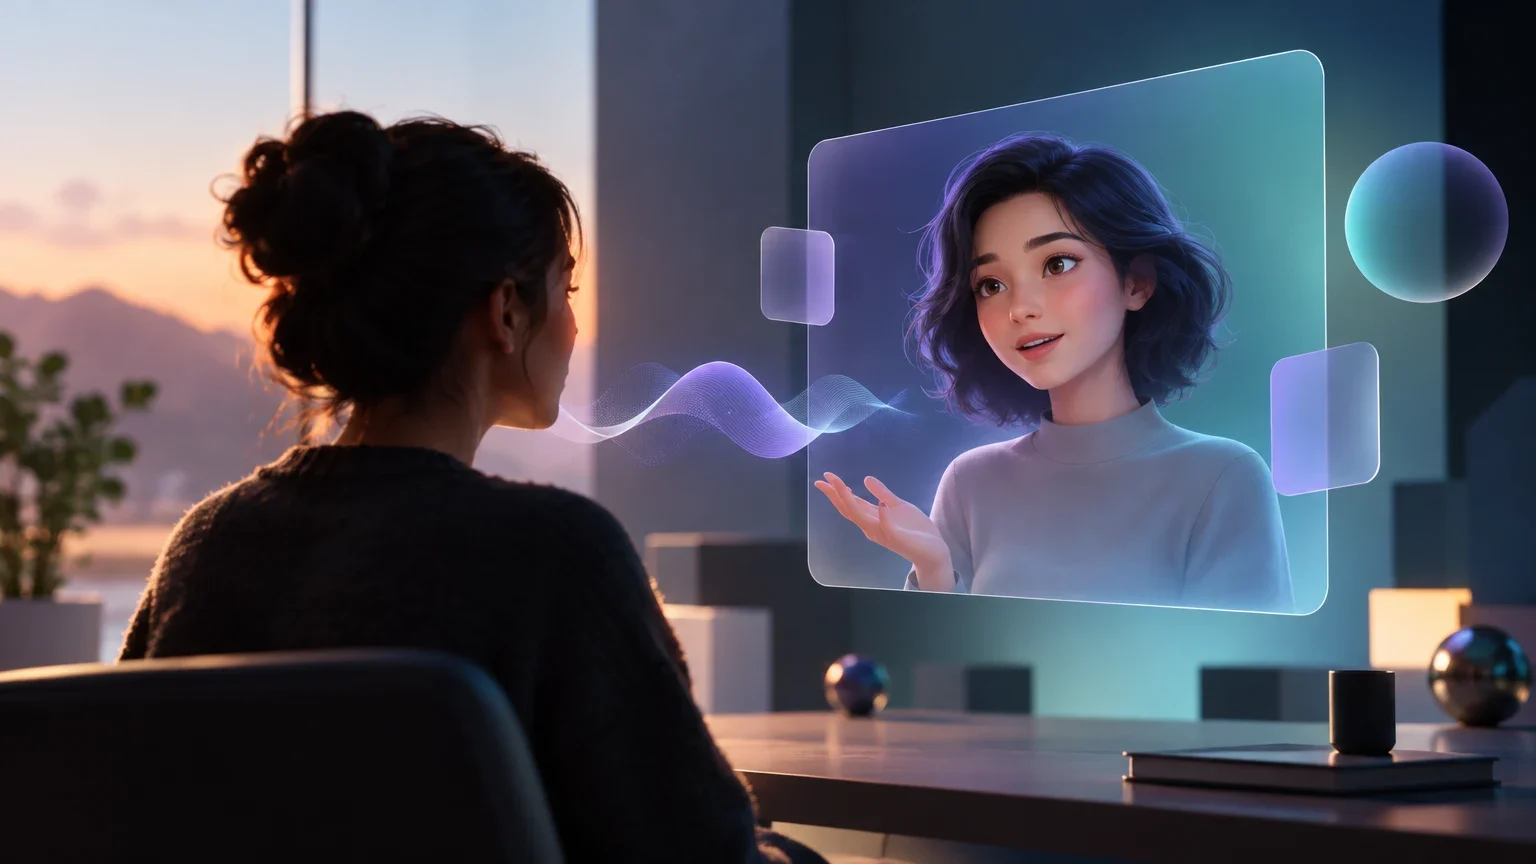
Google annonce Live Avatar pour Gemini Enterprise : une représentation visuelle qui accompagne la conversation et synchronise ses mouvements avec la voix. La disponibilité, les performances et les modalités prises en charge comportent des limites qu’il convient de distinguer.
Ce benchmark mesure si les agents prédisent comment les changements apportés aux composants d’un flux de travail influent sur les résultats. Ses résultats décrivent des performances sur des tâches précises, et non une capacité générale à faire de la science.
Lors de Made on YouTube, la plateforme a présenté des commentaires assistés par l’IA sur les brouillons et le montage conversationnel des Shorts. YouTube cite plusieurs opérations possibles, mais ne précise ni les régions concernées ni le calendrier de disponibilité.
La documentation d’OpenAI fixe une date de retrait pour Videos API et les modèles Sora 2 et Sora 2 Pro, sans indiquer de remplacement. Les équipes peuvent commencer par recenser leurs dépendances et sauvegarder les ressources déjà téléchargées ; le sort des travaux et des métadonnées après la fermeture n’est pas précisé dans les sources disponibles.
Le préprint décrit une méthode de red teaming adaptatif qui s’appuie sur les résultats de chaque test pour choisir quoi explorer ensuite. Ses auteurs indiquent qu’elle détecte davantage d’échecs que la répétition statique de tests initiaux dans trois familles d’évaluation. Le résumé ne permet toutefois ni de quantifier cet avantage ni de le transposer à la fréquence des incidents réels.
Le benchmark compare le comportement d’agents utilisant un ordinateur dans neuf environnements de marché, avec et sans mécanismes d’influence. Les résultats font état d’une forte baisse des choix du produit optimal pour l’utilisateur, mais ne prouvent pas que cet effet se produise dans de vrais magasins en ligne.