Definizione in una frase
Capacità di mantenere un comportamento utile di fronte a esempi o condizioni che non corrispondono esattamente ai dati di addestramento.
Definizione e concetti da non confondere
Nel contesto del machine learning, la generalizzazione è definita come la capacità di un modello di apprendere regole generali a partire da dati specifici e applicarle a nuovi dati non utilizzati durante l'addestramento. Senza questa capacità, un modello sarebbe semplicemente un database inefficiente che memorizza esempi, anziché una macchina di previsione utile.
È fondamentale distinguere la generalizzazione dalla memorizzazione. Un modello che memorizza i dati di addestramento può ottenere una precisione perfetta su quel set, ma fallirà davanti a qualsiasi minima variazione. La generalizzazione implica che l'errore del modello su nuovi dati (rischio atteso) sia basso e che la differenza tra l'errore di addestramento e l'errore di test (gap di generalizzazione) sia piccola.
Funzionamento passo dopo passo
Il processo per garantire la generalizzazione inizia con la definizione della distribuzione dei dati. Teoricamente, si assume che i dati provengano da una distribuzione statistica fissa. L'obiettivo è minimizzare il rischio atteso, che è l'errore medio che il modello commetterebbe se gli venissero presentati infiniti esempi di quella distribuzione.
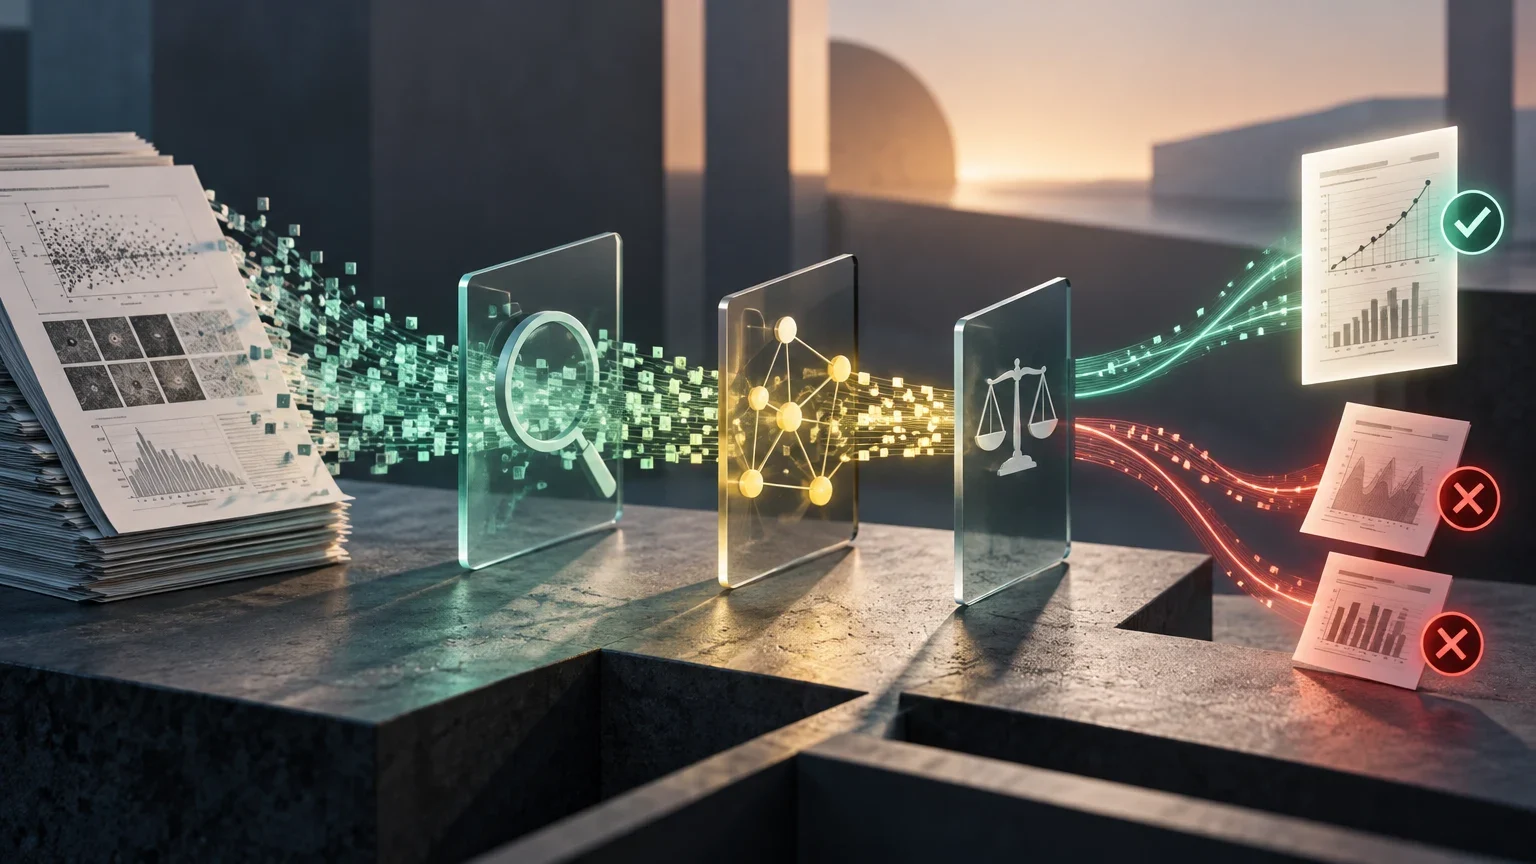
Dato che la distribuzione reale non è nota, si utilizza un insieme di dati finito. Per stimare l'errore di generalizzazione, si divide l'insieme di dati in tre parti: addestramento, validazione e test. Il modello viene addestrato con la prima, regolato con la seconda e valutato infine con la terza. Questa separazione è cruciale per ottenere una stima onesta delle prestazioni del modello su nuovi dati.
Flusso di valutazione della generalizzazione
Processo standard per valutare la capacità di generalizzazione di un modello.
- 01Dividere i dati in insiemi di addestramento, validazione e test, assicurandosi che non ci sia sovrapposizione di istanze indipendenti.
- 02Addestrare il modello utilizzando esclusivamente l'insieme di addestramento.
- 03Regolare gli iperparametri utilizzando l'insieme di validazione per evitare l'overfitting.
- 04Valutare il modello finale utilizzando l'insieme di test per stimare l'errore di generalizzazione.
- 05Analizzare il gap tra l'errore di addestramento e l'errore di test per diagnosticare problemi di capacità del modello.
Tre esempi sviluppati in ambiti rilevanti
Il primo esempio si trova in radiologia. In uno studio sulla rilevazione della polmonite tramite raggi X, è stato identificato un problema di data leakage. Se lo stesso paziente appare negli insiemi di addestramento e test, il modello può imparare a riconoscere caratteristiche uniche del paziente (come cicatrici) anziché segni della malattia. Questo viola l'ipotesi di indipendenza dei dati e produce una stima di generalizzazione ottimistica che non si traduce nella pratica clinica.
Un secondo esempio proviene dalla classificazione delle perturbazioni della qualità dell'energia. Uno studio recente ha confrontato modelli di machine learning e deep learning per classificare otto tipi di perturbazioni elettriche. Si è osservato che, sebbene i modelli deep raggiungessero un'accuratezza molto alta (Macro-F1 > 0.98) nel dominio di addestramento, le loro prestazioni calavano significativamente quando applicati a dati di altri domini o in presenza di rumore. Questo dimostra che un alto rendimento in-domain non garantisce la generalizzazione cross-domain né la robustezza alle variazioni delle condizioni operative.
Il terzo esempio illustra il problema dell'estrapolazione. Un preprint del 2024 ha analizzato la capacità dei modelli di deep learning rispetto a funzioni esponenziali. I modelli sono stati addestrati all'interno di un intervallo specifico e testati al di fuori di esso. I risultati suggeriscono che i modelli di deep learning possiedono capacità intrinseche per generalizzare oltre la portata dell'addestramento, sebbene questo risultato si limiti all'esperimento specifico condotto e non debba essere generalizzato a tutti i tipi di dati o architetture senza ulteriore evidenza.
Confronto dei limiti di generalizzazione in diversi ambiti
Riepilogo delle sfide di generalizzazione identificate nelle fonti primarie.
| Ambito | Sfida principale | Risultato osservato |
|---|---|---|
| Radiologia (Raggi X) | Violazione delle ipotesi IID (stesso paziente in train/test) | Sovrastima delle prestazioni reali; il modello impara tratti del paziente, non della malattia. |
| Qualità dell'Energia | Cambio di dominio e rumore (AWGN) | I modelli deep sono sensibili alla dimensione dei dati e al rumore; SVM ha mostrato una migliore generalizzazione cross-domain nello studio. |
| Funzioni Esponenziali | Estrapolazione fuori dal dominio di addestramento | I modelli DL hanno mostrato capacità di estrapolazione nell'esperimento specifico, ma non è una regola universale. |
Come valutare il risultato
La valutazione della generalizzazione richiede metriche che vadano oltre la semplice accuratezza. L'uso della validazione incrociata (cross-validation) consente di ottenere una stima più stabile dell'errore di test dividendo i dati in più parti e mediando i risultati. Tuttavia, la validazione incrociata standard assume che i dati siano indipendenti e identicamente distribuiti (IID).
Quando i dati non soddisfano l'ipotesi IID, come nelle serie temporali o nei dati di pazienti ripetuti, la validazione incrociata casuale può essere ingannevole. In questi casi, si devono utilizzare tecniche di validazione incrociata raggruppata (grouped cross-validation) che assicurino che le istanze correlate rimangano insieme nello stesso fold. Inoltre, è cruciale valutare la robustezza del modello a perturbazioni o cambiamenti di distribuzione, non solo le sue prestazioni su dati puliti e rappresentativi.
Errori comuni e limiti
Uno degli errori più comuni è assumere che un modello che funziona bene su un insieme di dati specifico generalizzerà automaticamente alla popolazione target. La rappresentatività dei dati è un concetto complesso; spesso, gli insiemi di dati di ricerca non riflettono la distribuzione reale dei dati nell'applicazione finale. Ad esempio, nella rilevazione del COVID-19, molti modelli sono falliti perché i dati di addestramento erano composti da immagini di fonti molto diverse e non rappresentative della pratica clinica reale.
Un altro limite importante è il fenomeno della doppia discesa (double descent). Tradizionalmente, si credeva che aumentare la complessità del modello portasse sempre all'overfitting. Tuttavia, nelle reti neurali profonde, si è osservato che l'errore di test può diminuire nuovamente aumentando la complessità oltre la soglia di interpolazione. Sebbene questo fenomeno spieghi perché alcuni modelli grandi generalizzano bene, non fornisce una garanzia universale e rimane un'area di ricerca attiva.
Infine, è importante distinguere tra generalizzazione per prevedere e generalizzazione per comprendere. In scienza, si cerca spesso che le intuizioni del modello si applichino a un fenomeno più ampio. Questo richiede che i dati siano rappresentativi della popolazione di interesse, qualcosa che non è sempre verificato nella letteratura sul machine learning.