Définition en une phrase
Capacité à maintenir un comportement utile face à des exemples ou des conditions qui ne correspondent pas exactement aux données d'entraînement.
Définition et concepts à ne pas confondre
Dans le contexte de l'apprentissage automatique, la généralisation est définie comme la capacité d'un modèle à apprendre des règles générales à partir de données spécifiques et à les appliquer à de nouvelles données qui n'ont pas été utilisées pendant l'entraînement. Sans cette capacité, un modèle ne serait qu'une base de données inefficace qui mémorise des exemples, plutôt qu'une machine de prédiction utile.
Il est fondamental de distinguer la généralisation de la mémorisation. Un modèle qui mémorise les données d'entraînement peut obtenir une précision parfaite sur cet ensemble, mais échouera face à la moindre variation. La généralisation implique que l'erreur du modèle sur de nouvelles données (risque attendu) soit faible et que la différence entre l'erreur d'entraînement et l'erreur de test (écart de généralisation) soit petite.
Fonctionnement étape par étape
Le processus d'assurance de la généralisation commence par la définition de la distribution des données. Théoriquement, on suppose que les données proviennent d'une distribution statistique fixe. L'objectif est de minimiser le risque attendu, qui est l'erreur moyenne que le modèle commettrait si on lui présentait une infinité d'exemples de cette distribution.
Étant donné que la distribution réelle est inconnue, on utilise un ensemble de données fini. Pour estimer l'erreur de généralisation, l'ensemble de données est divisé en trois parties : entraînement, validation et test. Le modèle est entraîné sur la première, ajusté sur la seconde et évalué finalement sur la troisième. Cette séparation est cruciale pour obtenir une estimation honnête de la performance du modèle face à de nouvelles données.
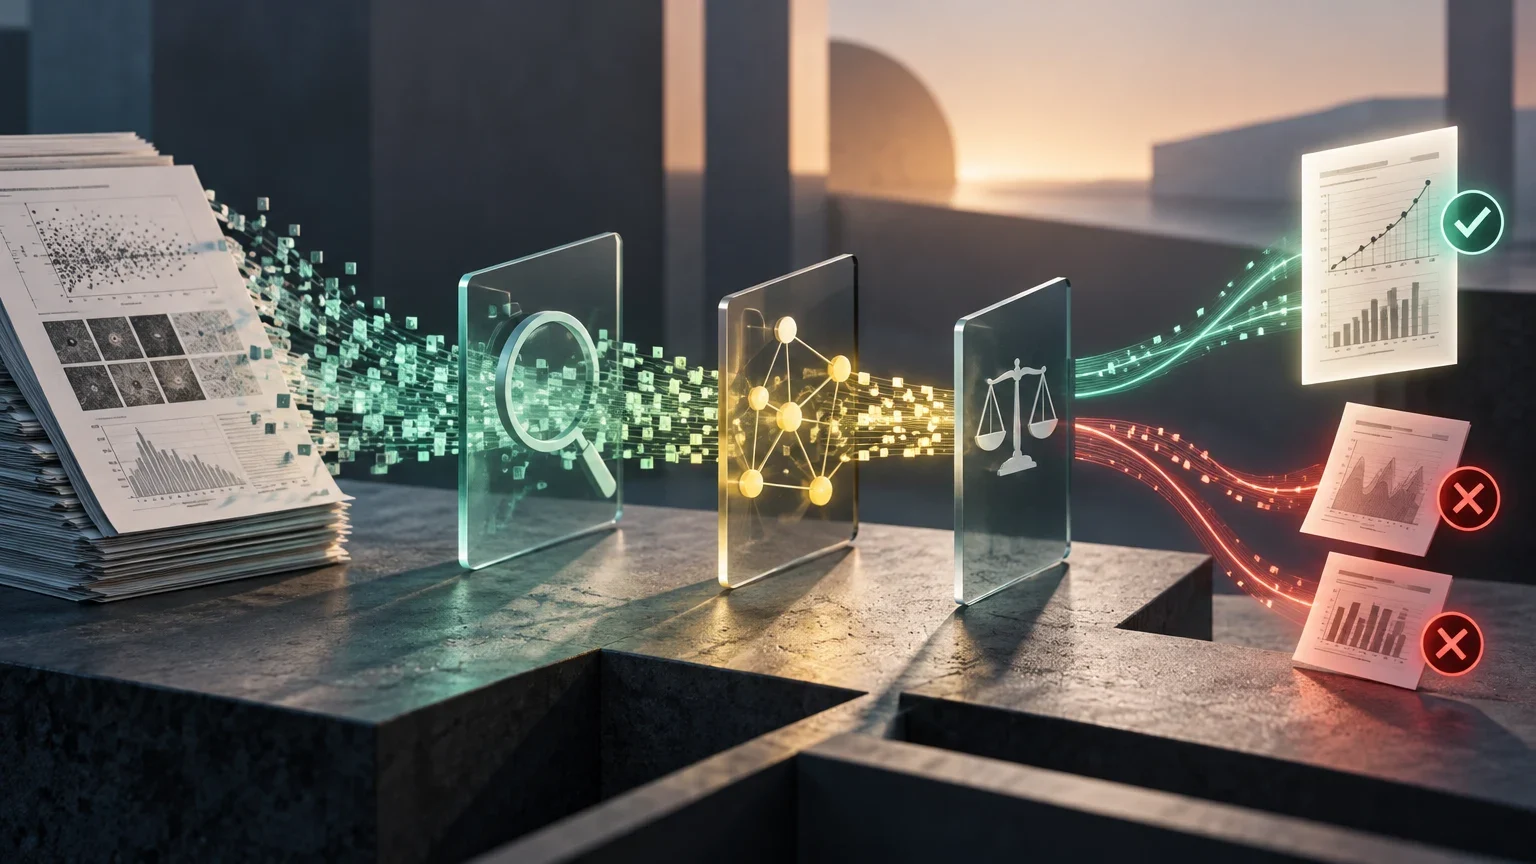
Flux d'évaluation de la généralisation
Processus standard pour évaluer la capacité de généralisation d'un modèle.
- 01Diviser les données en ensembles d'entraînement, de validation et de test, en veillant à ce qu'il n'y ait pas de chevauchement d'instances indépendantes.
- 02Entraîner le modèle en utilisant uniquement l'ensemble d'entraînement.
- 03Ajuster les hyperparamètres en utilisant l'ensemble de validation pour éviter le surapprentissage.
- 04Évaluer le modèle final en utilisant l'ensemble de test pour estimer l'erreur de généralisation.
- 05Analyser l'écart entre l'erreur d'entraînement et l'erreur de test pour diagnostiquer les problèmes de capacité du modèle.
Trois exemples développés dans des domaines pertinents
Le premier exemple se trouve en radiologie. Dans une étude sur la détection de la pneumonie par radiographie, un problème de fuite de données a été identifié. Si un même patient apparaît dans les ensembles d'entraînement et de test, le modèle peut apprendre à reconnaître des caractéristiques uniques du patient (comme des cicatrices) plutôt que des signes de la maladie. Cela viole l'hypothèse d'indépendance des données et produit une estimation de généralisation optimiste qui ne se traduit pas dans la pratique clinique.
Un deuxième exemple provient de la classification des perturbations de la qualité de l'énergie. Une étude récente a comparé des modèles d'apprentissage automatique et d'apprentissage profond pour classer huit types de perturbations électriques. Il a été observé que, bien que les modèles profonds atteignaient une précision très élevée (Macro-F1 > 0,98) dans le domaine d'entraînement, leurs performances chutaient significativement lorsqu'ils étaient appliqués à des données d'autres domaines ou lorsque du bruit était introduit. Cela démontre qu'une haute performance intra-domaine ne garantit pas la généralisation inter-domaines ni la robustesse face aux variations des conditions opérationnelles.
Le troisième exemple illustre le problème de l'extrapolation. Un préprint de 2024 a analysé la capacité des modèles d'apprentissage profond face à des fonctions exponentielles. Les modèles ont été entraînés dans une plage spécifique et testés en dehors de cette plage. Les résultats suggèrent que les modèles d'apprentissage profond possèdent des capacités inhérentes à généraliser au-delà de la portée de l'entraînement, bien que cette observation soit limitée à l'expérience spécifique réalisée et ne doive pas être généralisée à tous les types de données ou d'architectures sans plus de preuves.
Comparaison des limites de généralisation dans différents domaines
Résumé des défis de généralisation identifiés dans les sources primaires.
| Domaine | Défi principal | Résultat observé |
|---|---|---|
| Radiologie (Radiographies) | Violation des hypothèses IID (même patient dans train/test) | Sous-estimation de la performance réelle ; le modèle apprend les traits du patient, pas ceux de la maladie. |
| Qualité de l'énergie | Changement de domaine et bruit (AWGN) | Les modèles profonds sont sensibles à la taille des données et au bruit ; SVM a montré une meilleure généralisation inter-domaines dans l'étude. |
| Fonctions exponentielles | Extrapolation hors du domaine d'entraînement | Les modèles DL ont montré une capacité d'extrapolation dans l'expérience spécifique, mais ce n'est pas une règle universelle. |
Comment évaluer le résultat
L'évaluation de la généralisation nécessite des métriques qui vont au-delà de la simple exactitude. L'utilisation de la validation croisée permet d'obtenir une estimation plus stable de l'erreur de test en divisant les données en plusieurs parties et en moyennant les résultats. Cependant, la validation croisée standard suppose que les données sont indépendantes et identiquement distribuées (IID).
Lorsque les données ne remplissent pas l'hypothèse IID, comme dans les séries temporelles ou les données de patients répétés, la validation croisée aléatoire peut être trompeuse. Dans ces cas, des techniques de validation croisée groupée doivent être utilisées pour s'assurer que les instances liées restent ensemble dans le même pliage. De plus, il est crucial d'évaluer la robustesse du modèle face aux perturbations ou aux changements de distribution, et non seulement sa performance sur des données propres et représentatives.
Erreurs courantes et limites
L'une des erreurs les plus courantes est de supposer qu'un modèle qui fonctionne bien sur un ensemble de données spécifique généralisera automatiquement à la population cible. La représentativité des données est un concept complexe ; souvent, les ensembles de données de recherche ne reflètent pas la distribution réelle des données dans l'application finale. Par exemple, dans la détection de la COVID-19, de nombreux modèles ont échoué parce que les données d'entraînement étaient composées d'images de sources très diverses et non représentatives de la pratique clinique réelle.
Une autre limite importante est le phénomène de double descente. Traditionnellement, on croyait qu'augmenter la complexité du modèle menait toujours au surapprentissage. Cependant, dans les réseaux de neurones profonds, il a été observé que l'erreur de test peut diminuer à nouveau en augmentant la complexité au-delà du seuil d'interpolation. Bien que ce phénomène explique pourquoi certains grands modèles généralisent bien, il ne fournit pas une garantie universelle et reste un domaine de recherche actif.
Enfin, il est important de distinguer la généralisation pour prédire de la généralisation pour comprendre. En science, on cherche souvent à ce que les insights du modèle s'appliquent à un phénomène plus large. Cela nécessite que les données soient représentatives de la population d'intérêt, ce qui n'est pas toujours vérifié dans la littérature sur l'apprentissage automatique.