Définition en une phrase
Situation dans laquelle un modèle s'adapte trop aux données d'entraînement et perd en performance face à de nouveaux cas.
Définition précise : l'incapacité à généraliser
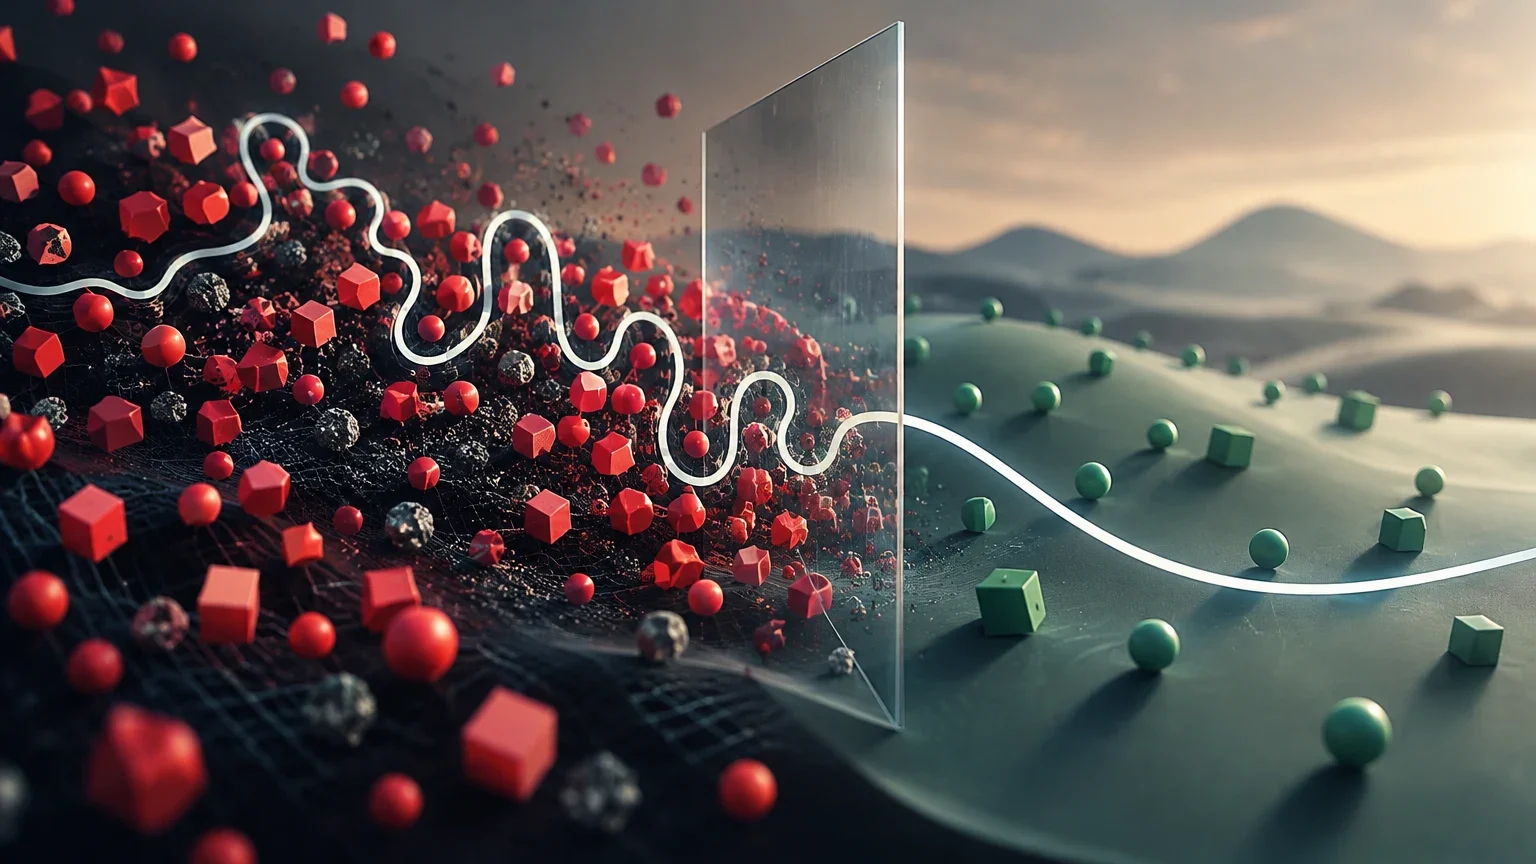
Le surapprentissage (overfitting) est un phénomène en apprentissage automatique où un modèle s'ajuste de manière excessive aux données d'entraînement, capturant non seulement le signal sous-jacent mais aussi le bruit, les anomalies et les motifs aléatoires spécifiques à cet ensemble. En conséquence, le modèle présente une performance excellente sur les données avec lesquelles il a été entraîné, mais sa capacité de prédiction se dégrade significativement lorsqu'il est confronté à de nouvelles données inédites. Cette incapacité à généraliser annule l'objectif fondamental d'un modèle prédictif, qui est d'extrapoler la connaissance à des situations réelles.
Techniquement, un modèle surapprenu présente une haute variance et un faible biais. La haute variance indique que les prédictions du modèle sont extrêmement sensibles aux variations de l'ensemble d'entraînement ; de petits changements dans les données d'entrée peuvent provoquer de grands changements dans la sortie. Le faible biais, quant à lui, reflète que le modèle est suffisamment flexible pour capturer la complexité des données, mais cette même flexibilité l'empêche de distinguer la tendance réelle du bruit statistique. La généralisation est donc l'objectif opposé au surapprentissage : un modèle généralise bien si ses prédictions sont précises et cohérentes aussi bien sur les données d'entraînement que sur celles de validation et de test.
Mécanisme technique : l'équilibre biais-variance
Pour comprendre le surapprentissage, il est nécessaire d'analyser le compromis biais-variance. L'erreur totale d'un modèle prédictif peut se décomposer en trois composantes : le biais au carré, la variance et le bruit irréductible. Le biais mesure l'erreur introduite en supposant que la forme de la fonction cible est simple (par exemple, linéaire) alors qu'elle est en réalité complexe. La variance mesure la sensibilité du modèle aux fluctuations de l'ensemble d'entraînement. Un modèle à haute variance apprendra des motifs différents s'il est entraîné sur un sous-ensemble légèrement différent des données.
En pratique, à mesure que la complexité du modèle augmente (par exemple, en ajoutant des couches à un réseau de neurones ou en augmentant la profondeur d'un arbre de décision), le biais diminue car le modèle peut capturer des relations plus complexes. Cependant, la variance augmente. Le surapprentissage survient lorsque la complexité du modèle dépasse le point optimal, connu sous le nom de 'point idéal' (sweet spot), où la somme du biais et de la variance est minimale. Dans cette zone, le modèle a appris à mémoriser le bruit plutôt que le signal, ce qui se manifeste opérationnellement par une divergence entre les métriques d'entraînement et celles de validation.
Comparaison des états d'ajustement du modèle
Tableau de décision pour identifier l'état du modèle selon ses métriques et caractéristiques statistiques.
| État du Modèle | Biais (Bias) | Variance | Performance à l'Entraînement | Performance en Validation/Test | Cause Principale |
|---|---|---|---|---|---|
| Sous-apprentissage (Underfitting) | Élevé | Faible | Faible | Faible | Modèle trop simple ou entraînement insuffisant |
| Ajustement Optimal | Faible | Faible | Élevée | Élevée | Complexité adaptée au signal des données |
| Surapprentissage (Overfitting) | Faible | Élevée | Très Élevée | Faible | Modèle trop complexe ou données insuffisantes/bruitées |
Détection opérationnelle : courbes d'apprentissage et validation
La détection précoce du surapprentissage est critique pour éviter le déploiement de modèles inefficaces. L'outil le plus courant est l'observation des courbes de perte (loss curves) pendant l'entraînement. Deux métriques principales sont tracées : la perte sur l'ensemble d'entraînement et la perte sur l'ensemble de validation, en fonction du nombre d'itérations ou d'époques. Dans un modèle bien ajusté, les deux courbes convergent et restent stables. Dans un modèle surapprenu, la courbe d'entraînement continue de descendre (ou reste à une valeur très basse), tandis que la courbe de validation atteint un minimum puis commence à monter. Ce point de divergence est le signal incontestable que le modèle a commencé à mémoriser le bruit.
En plus des courbes, la validation croisée (k-fold) est une méthode robuste pour évaluer la stabilité du modèle. Dans ce processus, les données sont divisées en k sous-ensembles. Le modèle est entraîné k fois, utilisant à chaque fois k-1 sous-ensembles pour l'entraînement et le restant pour la validation. Si la performance moyenne de la validation croisée est significativement inférieure à la performance rapportée sur l'ensemble d'entraînement complet, il y a une forte probabilité de surapprentissage. Cette méthode est particulièrement utile lorsque l'ensemble de données est petit, car elle maximise l'utilisation des données disponibles pour l'évaluation.
Protocole de détection par validation croisée
Étapes pour implémenter la validation croisée k-fold afin de diagnostiquer le surapprentissage.
- 01Diviser l'ensemble de données d'entraînement en k plis (folds) de taille égale, en s'assurant que la distribution des classes est stratifiée s'il s'agit d'un problème de classification.
- 02Pour chaque itération i (de 1 à k), réserver le pli i comme ensemble de validation et utiliser les k-1 plis restants pour entraîner le modèle.
- 03Évaluer le modèle sur le pli de validation et enregistrer la métrique d'erreur (par exemple, MSE, Accuracy, F1-score).
- 04Répéter le processus jusqu'à ce que chaque pli ait servi d'ensemble de validation.
- 05Calculer la moyenne et l'écart-type des métriques obtenues. Un écart-type élevé indique une instabilité du modèle (haute variance).
- 06Comparer la moyenne de la validation croisée avec la métrique d'entraînement. Si la différence est significative, le surapprentissage est confirmé.
Exemples appliqués dans des domaines spécifiques
Le surapprentissage n'est pas seulement un problème théorique ; il a des conséquences opérationnelles graves dans les industries critiques. En détection de fraude financière, un modèle entraîné sur des transactions d'un mois spécifique peut mémoriser des motifs temporels ou des idiosyncrasies des utilisateurs de cette période. Si le modèle est déployé et que les motifs de fraude évoluent ou que les conditions du marché changent, le modèle échouera à reconnaître de nouvelles modalités de fraude, car il a appris à classer sur la base du bruit temporel de l'ensemble d'entraînement plutôt que des signaux structurels de la fraude.
En diagnostic médical par imagerie, le surapprentissage peut être dangereux. Un modèle entraîné pour détecter des tumeurs sur des IRM peut apprendre à associer la présence d'une tumeur à des artefacts spécifiques du scanner, à la position du patient ou au protocole d'acquisition d'une institution précise. Si le modèle est appliqué dans un autre hôpital avec des équipements différents, il peut générer de faux positifs ou négatifs car il détecte le 'bruit' du scanner d'origine plutôt que la pathologie réelle. De manière similaire, en prévision de la demande logistique, un modèle qui surestime la capacité de livraison les jours fériés en raison de données historiques atypiques (comme une grève ponctuelle) prendra de mauvaises décisions d'inventaire les années suivantes, générant des surcoûts ou des ruptures de stock.
Confusions fréquentes : surapprentissage vs. sous-apprentissage et contamination des données
Il est courant de confondre le surapprentissage avec le sous-apprentissage (underfitting). Le sous-apprentissage survient lorsque le modèle est trop simple pour capturer la complexité des données. Contrairement au surapprentissage, où le modèle échoue sur les nouvelles données mais réussit sur celles d'entraînement, le sous-apprentissage échoue sur les deux ensembles. Un modèle sous-apprenu a un biais élevé et une variance faible ; il n'est pas capable d'apprendre la tendance dominante des données. La solution au sous-apprentissage implique généralement d'augmenter la complexité du modèle ou de fournir plus de données, tandis que la solution au surapprentissage implique de réduire la complexité ou de régulariser.
Une autre confusion critique est celle entre le surapprentissage et la contamination des données (data leakage). La contamination des données se produit lorsque des informations de l'ensemble de test ou de validation filtrent accidentellement dans l'ensemble d'entraînement. Cela gonfle artificiellement les métriques de performance, faisant croire que le modèle généralise bien alors qu'il a en réalité 'vu' les réponses. Contrairement au surapprentissage, qui est un problème de capacité du modèle, la contamination est une erreur d'ingénierie des données. Un modèle contaminé peut avoir une variance et un biais apparemment faibles, mais sa performance dans le monde réel sera catastrophique car il n'a pas appris à généraliser, mais à mémoriser les étiquettes des données de test.
Atténuation et limites inhérentes à l'évaluation
Plusieurs techniques existent pour atténuer le surapprentissage. La régularisation (L1/Lasso et L2/Ridge) ajoute une pénalité à la fonction de perte pour les coefficients élevés, forçant le modèle à être plus simple. Le dropout, dans les réseaux de neurones, désactive aléatoirement des neurones pendant l'entraînement, empêchant le modèle de dépendre de chemins spécifiques. L'arrêt précoce (early stopping) stoppe l'entraînement lorsque la perte de validation cesse de s'améliorer, évitant que le modèle ne mémorise le bruit. L'augmentation des données (data augmentation) génère des variations artificielles des données d'entraînement, augmentant la diversité et réduisant la variance.
Cependant, ces techniques ont des limites. L'évaluation sur des ensembles de test non représentatifs peut donner un faux sentiment de sécurité. Si l'ensemble de test n'est pas stationnaire ou ne reflète pas la distribution réelle des données de production, le modèle peut sembler bien généraliser en validation mais échouer en production. De plus, dans les problèmes avec des données non stationnaires (comme les séries temporelles financières ou les tendances de consommation), le surapprentissage est plus difficile à atténuer car la distribution des données change dans le temps. Dans ces cas, la validation temporelle (time-series cross-validation) est préférable à la validation croisée aléatoire, car elle respecte l'ordre temporel des données.
Techniques d'atténuation et leur impact
Résumé des principales techniques pour combattre le surapprentissage et leur mécanisme d'action.
| Technique | Mécanisme d'Action | Application Typique | Risque Associé |
|---|---|---|---|
| Régularisation L1/L2 | Pénalise les coefficients élevés, réduisant la complexité du modèle. | Régression linéaire, réseaux de neurones. | Peut sous-apprendre si la pénalité est excessive. |
| Dropout | Désactive aléatoirement des neurones, forçant la redondance. | Réseaux de neurones profonds. | Requiert un ajustement fin du taux de dropout. |
| Early Stopping | Arrête l'entraînement lorsque la validation se dégrade. | Modèles itératifs (réseaux, gradient boosting). | Peut s'arrêter trop tôt si le bruit est élevé. |
| Data Augmentation | Génère des données synthétiques pour augmenter la diversité. | Vision par ordinateur, NLP. | Les données synthétiques peuvent ne pas capturer la variabilité réelle. |