Definição numa frase
Situação em que um modelo se adapta demasiado aos dados de treino e perde desempenho face a casos novos.
Definição precisa: a incapacidade de generalizar
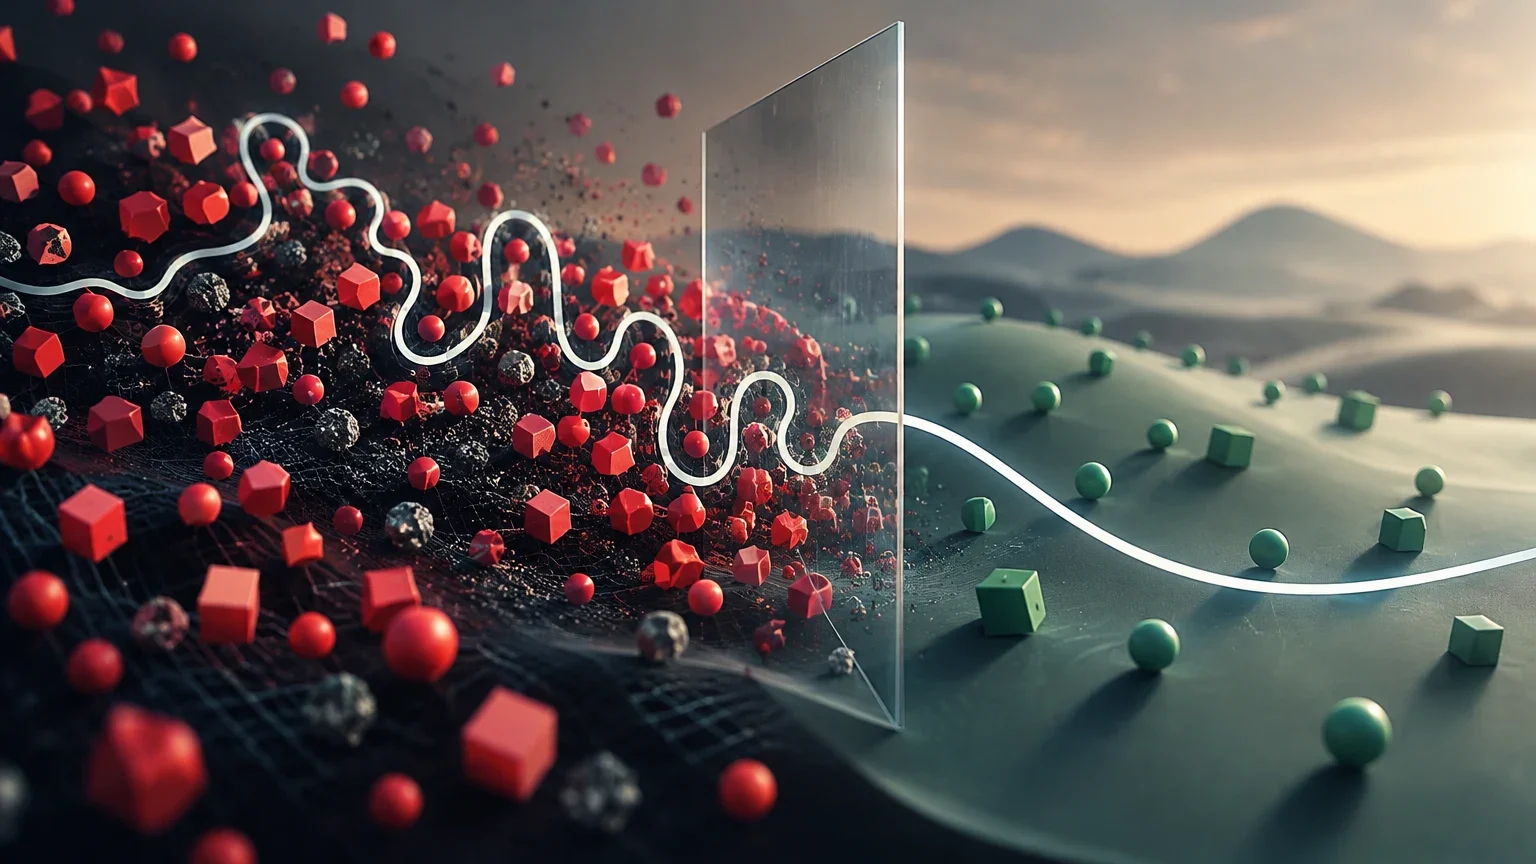
O sobreajuste, ou overfitting, é um fenômeno no aprendizado de máquina em que um modelo se ajusta excessivamente aos dados de treinamento, capturando não apenas o sinal subjacente, mas também o ruído, as anomalias e os padrões aleatórios específicos desse conjunto. Como resultado, o modelo exibe desempenho excelente nos dados com os quais foi treinado, mas sua capacidade preditiva se degrada significativamente ao se deparar com novos dados não vistos. Essa incapacidade de generalizar anula o propósito fundamental de um modelo preditivo, que é extrapolar conhecimento para situações reais.
Tecnicamente, um modelo sobreajustado apresenta alta variância e baixo viés. A alta variância indica que as previsões do modelo são extremamente sensíveis às variações no conjunto de treinamento; pequenas mudanças nos dados de entrada podem provocar grandes mudanças na saída. O baixo viés, por sua vez, reflete que o modelo é flexível o suficiente para capturar a complexidade dos dados, mas essa mesma flexibilidade impede que ele distinga entre a tendência real e o ruído estatístico. A generalização é, portanto, o objetivo oposto ao sobreajuste: um modelo generaliza bem se suas previsões forem precisas e consistentes tanto nos dados de treinamento quanto nos de validação e teste.
Mecanismo técnico: o equilíbrio viés-variancia
Para compreender o sobreajuste, é necessário analisar o tradeoff viés-variancia. O erro total de um modelo preditivo pode ser decomposto em três componentes: o viés ao quadrado, a variância e o ruído irredutível. O viés mede o erro introduzido ao assumir que a forma da função objetivo é simples (por exemplo, linear) quando, na realidade, é complexa. A variância mede a sensibilidade do modelo às flutuações no conjunto de treinamento. Um modelo com alta variância aprenderá padrões distintos se treinado com um subconjunto ligeiramente diferente dos dados.
Na prática, à medida que se aumenta a complexidade do modelo (por exemplo, adicionando mais camadas a uma rede neural ou aumentando a profundidade de uma árvore de decisão), o viés diminui porque o modelo pode capturar relações mais complexas. No entanto, a variância aumenta. O sobreajuste ocorre quando a complexidade do modelo ultrapassa o ponto ótimo, conhecido como 'ponto ideal' ou sweet spot, onde a soma do viés e da variância é mínima. Nessa zona, o modelo aprendeu a memorizar o ruído em vez do sinal, o que se manifesta operacionalmente como uma divergência entre as métricas de treinamento e as de validação.
Comparação de estados de ajuste do modelo
Tabela de decisão para identificar o estado do modelo com base em suas métricas e características estatísticas.
| Estado do Modelo | Viés (Bias) | Variance | Desempenho no Treinamento | Desempenho na Validação/Teste | Causa Principal |
|---|---|---|---|---|---|
| Subajuste (Underfitting) | Alto | Baixa | Baixo | Baixo | Modelo muito simples ou treinamento insuficiente |
| Ajuste Ótimo | Baixo | Baixa | Alto | Alto | Complexidade adequada ao sinal dos dados |
| Sobreajuste (Overfitting) | Baixo | Alta | Muito Alto | Baixo | Modelo muito complexo ou dados insuficientes/ruidosos |
Detecção operacional: curvas de aprendizado e validação
A detecção precoce do sobreajuste é crítica para evitar o despliegue de modelos ineficazes. A ferramenta mais comum é a observação das curvas de perda (loss curves) durante o treinamento. Graficam-se duas métricas principais: a perda no conjunto de treinamento e a perda no conjunto de validação, em função do número de iterações ou épocas. Em um modelo bem ajustado, ambas as curvas convergem e se mantêm estáveis. Em um modelo sobreajustado, a curva de treinamento continua descendo (ou se mantém em um valor muito baixo), enquanto a curva de validação atinge um mínimo e começa a subir. Esse ponto de divergência é o sinal inequívoco de que o modelo começou a memorizar o ruído.
Além das curvas, a validação cruzada (k-fold) é um método robusto para avaliar a estabilidade do modelo. Nesse processo, os dados são divididos em k subconjuntos. O modelo é treinado k vezes, cada vez utilizando k-1 subconjuntos para treinamento e o restante para validação. Se o desempenho médio da validação cruzada for significativamente inferior ao desempenho reportado no conjunto de treinamento completo, há uma alta probabilidade de sobreajuste. Este método é especialmente útil quando o conjunto de dados é pequeno, pois maximiza o uso dos dados disponíveis para a avaliação.
Protocolo de detecção mediante validação cruzada
Passos para implementar a validação cruzada k-fold para diagnosticar sobreajuste.
- 01Dividir o conjunto de dados de treinamento em k dobras (folds) de tamanho igual, garantindo que a distribuição de classes seja estratificada se for um problema de classificação.
- 02Para cada iteração i (de 1 a k), reservar a dobra i como conjunto de validação e utilizar as k-1 dobras restantes para treinar o modelo.
- 03Avaliar o modelo na dobra de validação e registrar a métrica de erro (por exemplo, MSE, Accuracy, F1-score).
- 04Repetir o processo até que cada dobra tenha servido como conjunto de validação.
- 05Calcular a média e o desvio padrão das métricas obtidas. Um desvio padrão alto indica instabilidade do modelo (alta variância).
- 06Comparar a média da validação cruzada com a métrica de treinamento. Se a diferença for significativa, confirma-se o sobreajuste.
Exemplos aplicados em domínios específicos
O sobreajuste não é apenas um problema teórico; tem consequências operacionais graves em indústrias críticas. Na detecção de fraude financeira, um modelo treinado com transações de um mês específico pode memorizar padrões temporais ou idiossincrasias dos usuários desse período. Se o modelo for implantado e os padrões de fraude evoluírem ou as condições de mercado mudarem, o modelo falhará ao não reconhecer novas modalidades de fraude, pois aprendeu a classificar com base no ruído temporal do conjunto de treinamento em vez dos sinais estruturais da fraude.
No diagnóstico médico por imagem, o sobreajuste pode ser perigoso. Um modelo treinado para detectar tumores em ressonâncias magnéticas pode aprender a associar a presença de um tumor a artefatos específicos do scanner, à posição do paciente ou ao protocolo de aquisição de uma instituição específica. Se o modelo for aplicado em outro hospital com equipamentos diferentes, pode gerar falsos positivos ou negativos porque está detectando o 'ruído' do scanner original em vez da patologia real. De maneira similar, na previsão de demanda logística, um modelo que superestima a capacidade de entrega em feriados devido a dados históricos atípicos (como uma greve pontual) tomará decisões de inventário erradas em anos futuros, gerando sobrecustos ou falta de estoque.
Confusões frequentes: sobreajuste vs. subajuste e contaminação de dados
É comum confundir o sobreajuste com o subajuste (underfitting). O subajuste ocorre quando o modelo é simples demais para capturar a complexidade dos dados. Diferentemente do sobreajuste, onde o modelo falha nos novos dados, mas acerta nos de treinamento, o subajuste falha em ambos os conjuntos. Um modelo subajustado tem alto viés e baixa variância; não é capaz de aprender a tendência dominante dos dados. A solução para o subajuste geralmente envolve aumentar a complexidade do modelo ou fornecer mais dados, enquanto a solução para o sobreajuste envolve reduzir a complexidade ou regularizar.
Outra confusão crítica é entre o sobreajuste e a contaminação de dados (data leakage). A contaminação de dados ocorre quando informações do conjunto de teste ou de validação vazam acidentalmente para o conjunto de treinamento. Isso infla artificialmente as métricas de desempenho, fazendo o modelo parecer generalizar bem quando, na verdade, ele 'viu' as respostas. Diferentemente do sobreajuste, que é um problema de capacidade do modelo, a contaminação é um erro de engenharia de dados. Um modelo contaminado pode ter variância baixa e viés baixo aparente, mas seu desempenho no mundo real será catastrófico porque não aprendeu a generalizar, mas sim a memorizar os rótulos dos dados de teste.
Mitigação e limites inerentes à avaliação
Existem várias técnicas para mitigar o sobreajuste. A regularização (L1/Lasso e L2/Ridge) adiciona uma penalização à função de perda para coeficientes grandes, forçando o modelo a ser mais simples. O dropout, em redes neurais, desativa aleatoriamente neurônios durante o treinamento, impedindo que o modelo dependa de rotas específicas. O early stopping interrompe o treinamento quando a perda de validação deixa de melhorar, evitando que o modelo memorize o ruído. O aumento de dados (data augmentation) gera variações artificiais dos dados de treinamento, aumentando a diversidade e reduzindo a variância.
No entanto, essas técnicas têm limites. A avaliação em conjuntos de teste não representativos pode dar uma falsa sensação de segurança. Se o conjunto de teste não for estacionário ou não refletir a distribuição real dos dados de produção, o modelo pode parecer generalizar bem na validação, mas falhar na produção. Além disso, em problemas com dados não estacionários (como séries temporais financeiras ou tendências de consumo), o sobreajuste é mais difícil de mitigar porque a distribuição dos dados muda com o tempo. Nesses casos, a validação temporal (time-series cross-validation) é preferível à validação cruzada aleatória, pois respeita a ordem temporal dos dados.
Técnicas de mitigação e seu impacto
Resumo das principais técnicas para combater o sobreajuste e seu mecanismo de ação.
| Técnica | Mecanismo de Ação | Aplicação Típica | Risco Associado |
|---|---|---|---|
| Regularização L1/L2 | Penaliza coeficientes grandes, reduzindo a complexidade do modelo. | Regressão linear, redes neurais. | Pode subajustar se a penalização for excessiva. |
| Dropout | Desativa neurônios aleatoriamente, forçando a redundância. | Redes neurais profundas. | Requer ajuste fino da taxa de dropout. |
| Early Stopping | Interrompe o treinamento quando a validação piora. | Modelos iterativos (redes, gradient boosting). | Pode interromper cedo demais se o ruído for alto. |
| Data Augmentation | Gera dados sintéticos para aumentar a diversidade. | Visão computacional, NLP. | Os dados sintéticos podem não capturar a variabilidade real. |