Definition in einem Satz
Situation, in der ein Modell sich zu stark an die Trainingsdaten anpasst und bei neuen Fällen an Leistung verliert.
Präzise Definition: Die Unfähigkeit zu generalisieren
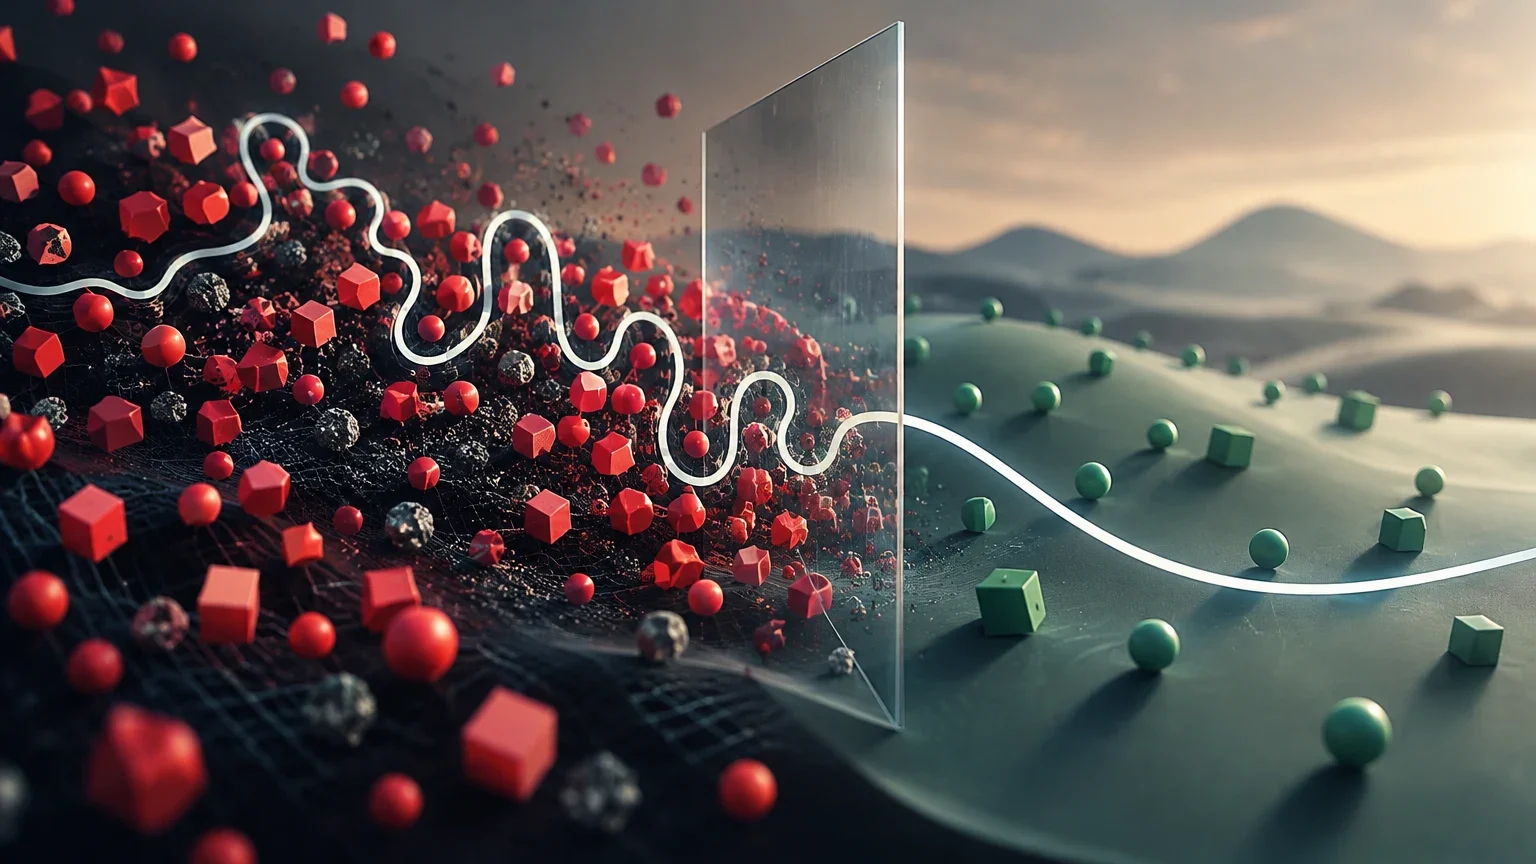
Overfitting ist ein Phänomen im maschinellen Lernen, bei dem ein Modell sich übermäßig an die Trainingsdaten anpasst. Dabei erfasst es nicht nur das zugrunde liegende Signal, sondern auch Rauschen, Anomalien und zufällige Muster, die spezifisch für diesen Datensatz sind. Infolgedessen zeigt das Modell eine exzellente Leistung auf den Daten, mit denen es trainiert wurde, seine Vorhersagefähigkeit degradiert jedoch erheblich, wenn es auf neue, unbekannte Daten trifft. Diese Unfähigkeit zu generalisieren zunichte macht den grundlegenden Zweck eines prädiktiven Modells, nämlich Wissen auf reale Situationen zu extrapolieren.
Technisch gesehen weist ein überangepasstes Modell eine hohe Varianz und einen niedrigen Bias auf. Die hohe Varianz bedeutet, dass die Vorhersagen des Modells extrem empfindlich auf Variationen im Trainingsdatensatz reagieren; kleine Änderungen in den Eingabedaten können große Änderungen in der Ausgabe verursachen. Der niedrige Bias spiegelt wider, dass das Modell flexibel genug ist, um die Komplexität der Daten zu erfassen, aber genau diese Flexibilität verhindert, dass es zwischen dem echten Trend und statistischem Rauschen unterscheidet. Generalisierung ist daher das Gegenteil von Overfitting: Ein Modell generalisiert gut, wenn seine Vorhersagen sowohl auf den Trainingsdaten als auch auf den Validierungs- und Testdaten präzise und konsistent sind.
Technischer Mechanismus: Der Bias-Varianz-Trade-off
Um Overfitting zu verstehen, muss der Bias-Varianz-Trade-off analysiert werden. Der Gesamtfehler eines prädiktiven Modells kann in drei Komponenten zerlegt werden: das quadrierte Bias, die Varianz und das irreduzible Rauschen. Das Bias misst den Fehler, der durch die Annahme eingeführt wird, dass die Form der Zielfunktion einfach (z. B. linear) ist, obwohl sie in Wirklichkeit komplex ist. Die Varianz misst die Empfindlichkeit des Modells gegenüber Fluktuationen im Trainingsdatensatz. Ein Modell mit hoher Varianz wird unterschiedliche Muster lernen, wenn es mit einem leicht anderen Teilmenge der Daten trainiert wird.
In der Praxis nimmt das Bias ab, wenn die Komplexität des Modells erhöht wird (z. B. durch Hinzufügen weiterer Schichten zu einem neuronalen Netz oder Erhöhung der Tiefe eines Entscheidungsbaums), da das Modell komplexere Beziehungen erfassen kann. Allerdings nimmt die Varianz zu. Overfitting tritt auf, wenn die Komplexität des Modells den optimalen Punkt überschreitet, der als 'Sweet Spot' bekannt ist, an dem die Summe aus Bias und Varianz minimal ist. In dieser Zone hat das Modell gelernt, das Rauschen statt des Signals zu memorisieren, was sich operativ als Divergenz zwischen den Trainings- und Validierungsmetriken manifestiert.
Vergleich der Modell-Anpassungszustände
Entscheidungstabelle zur Identifizierung des Modellzustands anhand seiner Metriken und statistischen Merkmale.
| Modellzustand | Bias | Varianz | Leistung im Training | Leistung in Validierung/Test | Hauptursache |
|---|---|---|---|---|---|
| Underfitting | Hoch | Niedrig | Niedrig | Niedrig | Modell zu einfach oder unzureichendes Training |
| Optimale Anpassung | Niedrig | Niedrig | Hoch | Hoch | Angemessene Komplexität für das Datensignal |
| Overfitting | Niedrig | Hoch | Sehr hoch | Niedrig | Modell zu komplex oder unzureichende/rauschende Daten |
Operative Erkennung: Lernkurven und Validierung
Die frühzeitige Erkennung von Overfitting ist entscheidend, um die Bereitstellung ineffektiver Modelle zu vermeiden. Das gängigste Werkzeug ist die Beobachtung der Verlustkurven (Loss Curves) während des Trainings. Zwei Hauptmetriken werden grafisch dargestellt: der Verlust im Trainingsdatensatz und der Verlust im Validierungsdatensatz in Abhängigkeit von der Anzahl der Iterationen oder Epochen. Bei einem gut angepassten Modell konvergieren beide Kurven und bleiben stabil. Bei einem überangepassten Modell sinkt die Trainingskurve weiterhin (oder bleibt auf einem sehr niedrigen Wert), während die Validierungskurve ein Minimum erreicht und beginnt, anzusteigen. Dieser Punkt der Divergenz ist das eindeutige Signal, dass das Modell begonnen hat, das Rauschen zu memorisieren.
Neben den Kurven ist die Kreuzvalidierung (k-Fold) eine robuste Methode zur Bewertung der Stabilität des Modells. In diesem Prozess werden die Daten in k Teilmengen aufgeteilt. Das Modell wird k-mal trainiert, wobei jedes Mal k-1 Teilmengen für das Training und die verbleibende für die Validierung verwendet wird. Wenn die durchschnittliche Leistung der Kreuzvalidierung erheblich niedriger ist als die im vollständigen Trainingsdatensatz berichtete Leistung, besteht eine hohe Wahrscheinlichkeit für Overfitting. Diese Methode ist besonders nützlich, wenn der Datensatz klein ist, da sie die Nutzung der verfügbaren Daten für die Bewertung maximiert.
Erkennungsprotokoll mittels Kreuzvalidierung
Schritte zur Implementierung der k-Fold-Kreuzvalidierung zur Diagnose von Overfitting.
- 01Teilen Sie den Trainingsdatensatz in k gleich große Folds auf und stellen Sie sicher, dass die Klassendistribution stratifiziert ist, wenn es sich um ein Klassifikationsproblem handelt.
- 02Reservieren Sie für jede Iteration i (von 1 bis k) den Fold i als Validierungsdatensatz und verwenden Sie die verbleibenden k-1 Folds zum Training des Modells.
- 03Bewerten Sie das Modell im Validierungsfold und protokollieren Sie die Fehlermetrik (z. B. MSE, Accuracy, F1-Score).
- 04Wiederholen Sie den Prozess, bis jeder Fold als Validierungsdatensatz gedient hat.
- 05Berechnen Sie den Mittelwert und die Standardabweichung der erhaltenen Metriken. Eine hohe Standardabweichung deutet auf Instabilität des Modells (hohe Varianz) hin.
- 06Vergleichen Sie den Mittelwert der Kreuzvalidierung mit der Trainingsmetrik. Wenn der Unterschied signifikant ist, wird Overfitting bestätigt.
Angewandte Beispiele in spezifischen Domänen
Overfitting ist nicht nur ein theoretisches Problem; es hat schwerwiegende operative Konsequenzen in kritischen Branchen. In der finanziellen Betrugserkennung kann ein Modell, das mit Transaktionen eines bestimmten Monats trainiert wurde, zeitliche Muster oder Idiosynkrasien der Benutzer dieses Zeitraums memorisieren. Wenn das Modell bereitgestellt wird und sich die Betrugsmuster entwickeln oder die Marktbedingungen ändern, wird das Modell fehlschlagen, neue Betrugsmethoden nicht zu erkennen, da es gelernt hat, basierend auf dem zeitlichen Rauschen des Trainingsdatensatzes zu klassifizieren, anstatt die strukturellen Signale des Betrugs zu erfassen.
In der medizinischen Bildgebung kann Overfitting gefährlich sein. Ein Modell, das trainiert wurde, um Tumore in MRT-Scans zu erkennen, kann lernen, die Anwesenheit eines Tumors mit spezifischen Artefakten des Scanners, der Position des Patienten oder dem Akquisitionsprotokoll einer bestimmten Institution zu assoziieren. Wenn das Modell in einem anderen Krankenhaus mit unterschiedlicher Ausrüstung angewendet wird, kann es aufgrund der Erkennung des 'Rauschens' des ursprünglichen Scanners anstatt der tatsächlichen Pathologie falsche Positive oder Negative erzeugen. Ähnlich kann ein Modell zur Nachfrageprognose in der Logistik, das die Lieferfähigkeit an Feiertagen aufgrund atypischer historischer Daten (wie eines einmaligen Streiks) überschätzt, in zukünftigen Jahren fehlerhafte Inventarentscheidungen treffen, was zu Mehrkosten oder Lieferengpässen führt.
Häufige Verwechslungen: Overfitting vs. Underfitting und Datenlecks
Es ist üblich, Overfitting mit Underfitting zu verwechseln. Underfitting tritt auf, wenn das Modell zu einfach ist, um die Komplexität der Daten zu erfassen. Im Gegensatz zu Overfitting, bei dem das Modell auf neuen Daten fehlschlägt, aber auf den Trainingsdaten korrekt ist, schlägt Underfitting in beiden Datensätzen fehl. Ein unterangepasstes Modell hat einen hohen Bias und eine niedrige Varianz; es ist nicht in der Lage, den dominanten Trend der Daten zu lernen. Die Lösung für Underfitting besteht oft darin, die Komplexität des Modells zu erhöhen oder mehr Daten bereitzustellen, während die Lösung für Overfitting darin besteht, die Komplexität zu reduzieren oder zu regularisieren.
Eine weitere kritische Verwechslung besteht zwischen Overfitting und Datenlecks (Data Leakage). Ein Datenleck tritt auf, wenn Informationen aus dem Test- oder Validierungsdatensatz versehentlich in den Trainingsdatensatz gelangen. Dies bläht die Leistungsmetriken künstlich auf und lässt das Modell so erscheinen, als würde es gut generalisieren, obwohl es die Antworten eigentlich 'gesehen' hat. Im Gegensatz zu Overfitting, das ein Kapazitätsproblem des Modells ist, ist ein Datenleck ein Fehler in der Datenengineering. Ein kontaminiertes Modell kann einen scheinbar niedrigen Bias und eine niedrige Varianz aufweisen, aber seine Leistung in der realen Welt wird katastrophal sein, da es nicht gelernt hat zu generalisieren, sondern die Labels der Testdaten zu memorisieren.
Minderung und inhärente Grenzen der Bewertung
Es gibt mehrere Techniken zur Minderung von Overfitting. Regularisierung (L1/Lasso und L2/Ridge) fügt der Verlustfunktion eine Strafe für große Koeffizienten hinzu und zwingt das Modell, einfacher zu sein. Dropout deaktiviert in neuronalen Netzen zufällig Neuronen während des Trainings und verhindert, dass das Modell von spezifischen Pfaden abhängt. Early Stopping stoppt das Training, wenn der Validierungsverlust nicht mehr verbessert wird, und verhindert, dass das Modell das Rauschen memorisiert. Data Augmentation erzeugt künstliche Variationen der Trainingsdaten, erhöht die Vielfalt und reduziert die Varianz.
Diese Techniken haben jedoch Grenzen. Die Bewertung auf nicht repräsentativen Testdatensätzen kann ein falsches Sicherheitsgefühl erzeugen. Wenn der Testdatensatz nicht stationär ist oder die reale Verteilung der Produktionsdaten nicht widerspiegelt, kann das Modell in der Validierung gut generalisieren, aber in der Produktion fehlschlagen. Darüber hinaus ist Overfitting bei Problemen mit nicht stationären Daten (wie Finanzzeitreihen oder Konsumtrends) schwieriger zu mindern, da sich die Datenverteilung mit der Zeit ändert. In solchen Fällen ist die zeitliche Validierung (Time-Series-Cross-Validation) der zufälligen Kreuzvalidierung vorzuziehen, da sie die zeitliche Reihenfolge der Daten respektiert.
Minderungstechniken und ihre Wirkung
Zusammenfassung der wichtigsten Techniken zur Bekämpfung von Overfitting und ihrem Wirkmechanismus.
| Technik | Wirkmechanismus | Typische Anwendung | Assoziiertes Risiko |
|---|---|---|---|
| Regularisierung L1/L2 | Straft große Koeffizienten und reduziert die Modellkomplexität. | Lineare Regression, neuronale Netze. | Kann zu Underfitting führen, wenn die Strafe zu hoch ist. |
| Dropout | Deaktiviert zufällig Neuronen und erzwingt Redundanz. | Tiefe neuronale Netze. | Erfordert Feinabstimmung der Dropout-Rate. |
| Early Stopping | Stoppt das Training, wenn die Validierung schlechter wird. | Iterative Modelle (Netze, Gradient Boosting). | Kann zu früh stoppen, wenn das Rauschen hoch ist. |
| Data Augmentation | Erzeugt synthetische Daten, um die Vielfalt zu erhöhen. | Computer Vision, NLP. | Synthetische Daten können die reale Variabilität nicht erfassen. |