Un’alternativa quando l’insegnante non espone i propri punteggi
Distillare una politica visione-linguaggio-azione significa addestrare un modello studente affinché sfrutti il comportamento di un altro modello, l’insegnante. Alcuni metodi richiedono che lo studente interroghi l’insegnante durante l’apprendimento e riceva punteggi per le proprie azioni. Queste informazioni potrebbero non essere disponibili quando l’insegnante è accessibile tramite un’interfaccia di inferenza che restituisce soltanto i risultati, senza esporre i punteggi interni.
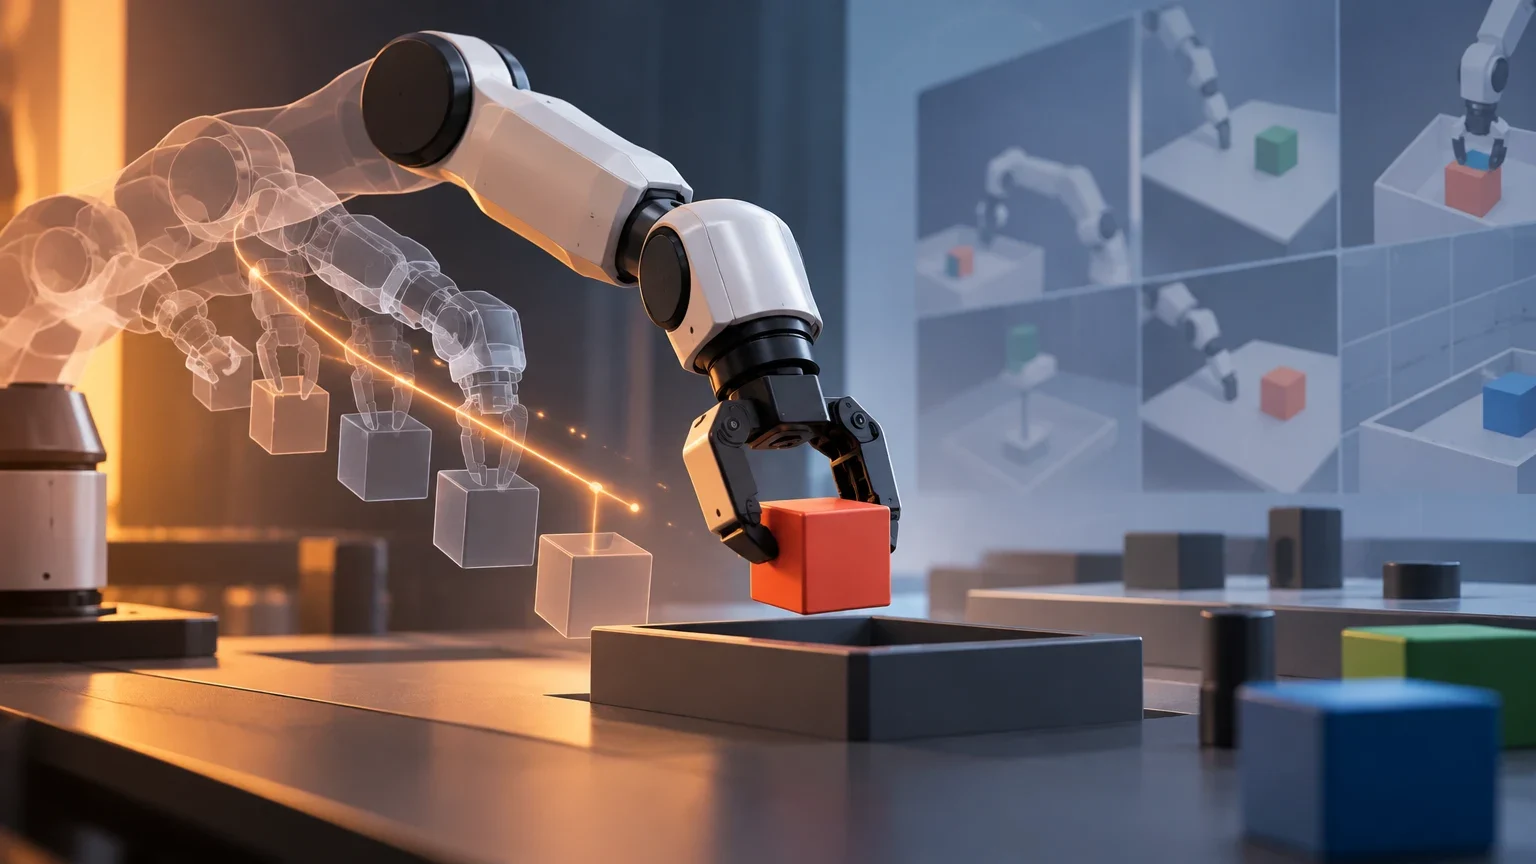
Il lavoro di Yun Zhu e Da Wang propone Trajectory-only Adversarial Distillation, abbreviato in TAD. Invece di chiedere all’insegnante di valutare ogni azione mentre lo studente apprende, il metodo utilizza una banca fissa di caratteristiche delle posizioni articolari, ricavate dalle traiettorie dell’insegnante. Un discriminatore confronta le caratteristiche delle traiettorie dell’insegnante e dello studente e genera un segnale di ricompensa per l’apprendimento dello studente mentre interagisce con l’ambiente.
L’abstract descrive uno studente che apprende senza interrogare online l’insegnante e senza ricevere dall’ambiente ricompense legate al compito. Questo non significa che TAD elimini ogni segnale di apprendimento: il discriminatore fornisce una ricompensa derivata dal confronto tra le traiettorie. La differenza riguarda l’origine del segnale, non l’assenza di feedback.
Come viene generato il segnale di apprendimento
Il meccanismo si basa sul confronto tra distribuzioni di caratteristiche. Il discriminatore riceve caratteristiche delle posizioni articolari provenienti dalle traiettorie dell’insegnante e dello studente e impara a distinguerle. Questa distinzione viene trasformata in una ricompensa che orienta l’apprendimento online dello studente mentre interagisce con l’ambiente.
La proposta cerca di sfruttare informazioni sul comportamento dell’insegnante senza richiedere l’accesso ai suoi punteggi delle azioni. In pratica, l’oggetto del confronto non è un punteggio per ogni singolo movimento, ma l’insieme delle caratteristiche dei percorsi. Il segnale risultante dipende dal discriminatore e dai dati sulle traiettorie disponibili; non è una misura diretta della correttezza di ogni azione rispetto al compito.
Questa distinzione è importante per interpretare i risultati. Il fatto che lo studente si avvicini alle caratteristiche osservate nelle traiettorie dell’insegnante non dimostra, da solo, che funzioni in modo affidabile in qualsiasi scenario. L’esperimento riporta il successo in un compito specifico e in una configurazione specifica; non stabilisce una garanzia generale di prestazioni.
Schema dell’apprendimento descritto
- 01Si raccoglie una banca fissa di caratteristiche delle posizioni articolari ricavate dalle traiettorie dell’insegnante.
- 02Lo studente interagisce con l’ambiente e produce le proprie traiettorie, senza interrogare online l’insegnante.
- 03Un discriminatore confronta le caratteristiche delle traiettorie delle due politiche.
- 04Il segnale generato dal discriminatore funge da ricompensa per l’apprendimento online dello studente.
Il risultato principale: un miglioramento in un compito di ManiSkill
Gli autori valutano TAD con OpenVLA-OFT, un modello visione-linguaggio-azione da 7 miliardi di parametri, nel compito PutOnPlateInScene25Main di ManiSkill. Riportano che il tasso di successo sale dal 26,2% al 76,6% secondo una metrica chiamata «successo al primo tentativo». Con un’altra misura, il successo al termine del processo passa dal 20,3% al 58,6%.
L’aumento della prima metrica è di 50,4 punti percentuali: è la differenza tra 76,6% e 26,2%, non un incremento del 50,4% rispetto al valore iniziale. Questa precisazione aiuta a valutare la portata del cambiamento senza confondere i punti percentuali con la crescita relativa. Il risultato è significativo nell’esperimento, ma riguarda un solo compito simulato e non basta per dedurre come il metodo si comporti in altri compiti o su un robot fisico.
L’abstract indica che ogni checkpoint viene valutato con 256 traiettorie. Questo numero descrive le traiettorie di valutazione riportate; da solo non consente di stabilire quante seed indipendenti siano state utilizzate, quanto varino i risultati tra diverse esecuzioni di addestramento o se una replica indipendente otterrebbe valori simili. Il record consultato corrisponde alla versione iniziale del preprint, inviata ad arXiv il 24 ottobre 2026; le informazioni disponibili non attestano una revisione paritaria.
Valori riportati per il compito simulato
Risultati descritti dagli autori per OpenVLA-OFT in PutOnPlateInScene25Main, ManiSkill. Sono valori riportati in un preprint, non una valutazione indipendente.
| Metrica | Prima di TAD | Con TAD | Variazione |
|---|---|---|---|
| Successo al primo tentativo | 26,2% | 76,6% | +50,4 punti percentuali |
| Successo al termine del processo | 20,3% | 58,6% | +38,3 punti percentuali |
Il confronto con OPD non avviene a parità di budget
L’abstract confronta TAD con una modalità di distillazione online chiamata OPD, che ha accesso white-box ai punteggi dell’insegnante. OPD raggiunge l’81,6% e il 59,4% nelle due metriche citate. TAD resta quindi indietro di 5,0 punti percentuali nel successo al primo tentativo e di 0,8 punti nel successo al termine del processo.
I valori, però, non corrispondono a budget equivalenti. La migliore esecuzione di TAD utilizza cinque volte il budget di interazioni dello studente di OPD e 12,5 volte i suoi passaggi di batch di rollout completi. Il confronto mostra quindi che TAD migliora rispetto alla politica iniziale e permette di mettere a confronto i risultati con OPD, ma non consente di concludere che un metodo sia più efficiente a parità di spesa in interazioni e ottimizzazione.
Gli autori riferiscono inoltre che una continuazione di quattro epoche ottiene il miglior risultato di TAD senza aggiungere dati dell’insegnante. È un risultato relativo alle configurazioni testate nel lavoro; non dimostra che quattro epoche siano la scelta ottimale per altri compiti, modelli o budget.
TAD e OPD: risultati e risorse riportati
Il confronto nell’abstract utilizza budget diversi; i tassi non vanno interpretati come una prova a parità di risorse.
| Metodo | Successo al primo tentativo | Successo al termine | Budget indicato |
|---|---|---|---|
| TAD | 76,6% | 58,6% | La migliore esecuzione usa 5 volte le interazioni dello studente e 12,5 volte i passaggi di batch di rollout completi di OPD |
| OPD | 81,6% | 59,4% | Riferimento di confronto; budget inferiore rispetto alla migliore esecuzione di TAD |
Che cosa si può concludere e che cosa resta fuori dall’esperimento
I risultati sostengono una conclusione circoscritta: nell’esperimento descritto, TAD ha permesso di migliorare OpenVLA-OFT in un compito simulato di ManiSkill senza interrogare online l’insegnante né usare ricompense del compito fornite dall’ambiente. Mostrano inoltre che, in quella configurazione, una banca di caratteristiche delle traiettorie può alimentare un discriminatore che fornisce un segnale di apprendimento.
Non dimostrano, tuttavia, che il metodo si trasferisca a nuovi compiti, ad ambienti diversi o a hardware fisico. Non attestano neppure che il comportamento osservato sia robusto a variazioni della scena, degli oggetti o delle condizioni di esecuzione. Il record consultato non conferma test su un robot reale né valutazioni su altri compiti: questi risultati non vanno quindi dati per acquisiti.
Le prove disponibili provengono dall’abstract di un preprint di ricerca originale. È una fonte primaria per sapere quale metodo e quali risultati dichiarano gli autori, ma non equivale a una convalida indipendente. L’abstract non permette inoltre di stabilire se codice, configurazioni e tutti i dettagli necessari per riprodurre pienamente i risultati siano disponibili. Questo limite non smentisce i risultati riportati: circoscrive ciò che si può sostenere sulla base delle informazioni accessibili.
Come interpretare i progressi di TAD
Per valutare una tecnica di distillazione robotica conviene separare tre domande: migliora rispetto al punto di partenza? È competitiva a parità di risorse? Mantiene il risultato al di fuori del compito valutato? L’abstract di TAD riporta un dato favorevole per la prima domanda; il confronto con OPD va letto tenendo conto dei budget diversi, mentre le prove non bastano per rispondere alla terza.
Il lavoro propone una strada interessante per i casi in cui l’insegnante non espone i punteggi delle azioni: utilizzare traiettorie già raccolte e apprendere una ricompensa tramite un confronto avversario. La sua utilità pratica dipenderà dal costo di raccolta delle traiettorie, dalla stabilità dell’addestramento e dal comportamento in condizioni diverse. Il risultato citato non misura da solo questi fattori in un’ampia varietà di scenari.
La lettura più precisa, per ora, è che TAD offre una dimostrazione iniziale in un compito simulato, non una prova generale di distillazione robotica né una convalida per l’impiego nel mondo fisico. Per estendere la conclusione servirebbero valutazioni confrontabili su più compiti e ambienti, budget allineati nel confronto tra metodi e test indipendenti in grado di esaminare variabilità e riproducibilità.
Questioni aperte
- L’abstract consultato riporta 256 traiettorie di valutazione per checkpoint, ma non consente di determinare quante seed indipendenti siano state utilizzate né la variabilità tra le esecuzioni.
- Le informazioni disponibili non confermano se siano disponibili codice, configurazioni e tutti i dettagli necessari per riprodurre pienamente il risultato.
- Il preprint non attesta valutazioni di TAD su altri compiti o ambienti né test su hardware robotico fisico.
- Il record consultato corrisponde a un preprint inviato ad arXiv; non risulta che il lavoro sia stato sottoposto a revisione paritaria.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione