Una alternativa cuando el profesor no expone sus puntuaciones
Destilar una política de visión, lenguaje y acción consiste en entrenar un modelo estudiante para que aproveche el comportamiento de otro modelo, el profesor. En algunos métodos, el estudiante necesita consultar al profesor durante el aprendizaje y recibir puntuaciones para sus acciones. Esa información puede no estar disponible si el profesor se ofrece mediante una interfaz de inferencia que solo devuelve resultados y no expone sus puntuaciones internas.
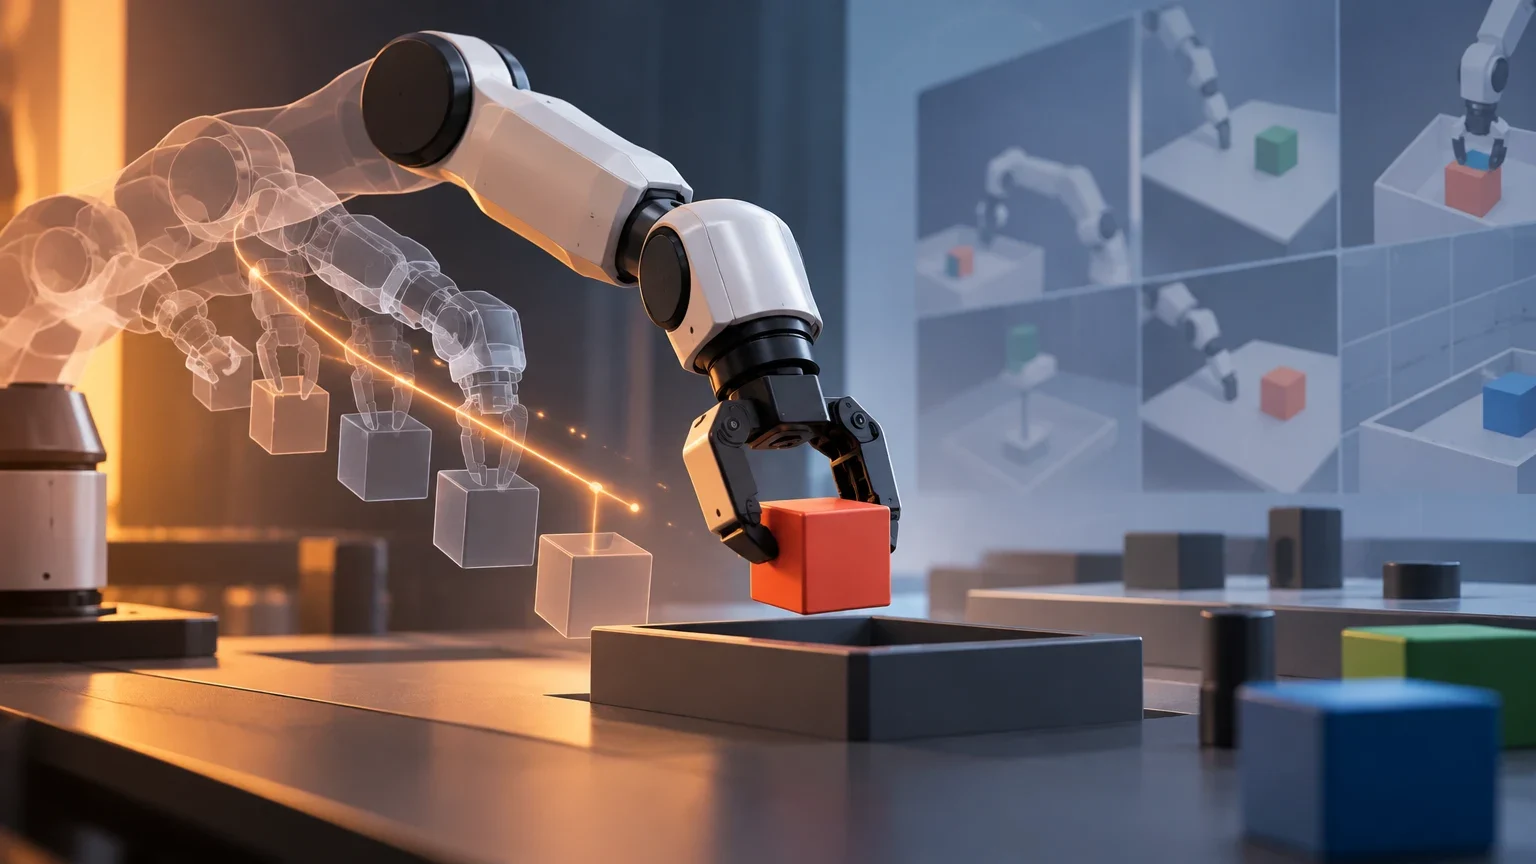
El trabajo de Yun Zhu y Da Wang propone Trajectory-only Adversarial Distillation, abreviado TAD. En lugar de pedir al profesor que valore cada acción mientras el estudiante aprende, el método utiliza un banco fijo de características de posiciones articulares obtenido de trayectorias del profesor. Un discriminador compara características de las trayectorias del profesor y del estudiante, y genera una señal de recompensa para el aprendizaje del estudiante en interacción con el entorno.
El resumen del trabajo describe un estudiante que aprende sin consultas en línea al profesor y sin recompensas de la tarea suministradas por el entorno. Eso no significa que TAD prescinda de toda señal de aprendizaje: el discriminador proporciona una recompensa derivada de la comparación entre trayectorias. La diferencia es el origen de esa señal, no la ausencia de retroalimentación.
Cómo se genera la señal de aprendizaje
El mecanismo se basa en comparar distribuciones de características. El discriminador recibe características de posiciones articulares procedentes de las trayectorias del profesor y del estudiante, y aprende a distinguirlas. Esa distinción se transforma en una recompensa que orienta el aprendizaje en línea del estudiante mientras interactúa con el entorno.
La propuesta intenta aprovechar información sobre el comportamiento del profesor sin requerir acceso a sus puntuaciones de acción. En términos prácticos, el objeto de comparación no es una puntuación para cada movimiento individual, sino las características agregadas de los recorridos. La señal resultante depende del discriminador y de los datos de trayectoria disponibles; no es una medida directa de que cada acción sea correcta para la tarea.
Esta distinción importa al interpretar el resultado. Que el estudiante se acerque a las características observadas en las trayectorias del profesor no equivale por sí solo a demostrar que funciona de forma fiable en cualquier escenario. El experimento informa sobre éxito en una tarea concreta y bajo una configuración concreta; no establece una garantía general de rendimiento.
Esquema del aprendizaje descrito
- 01Se reúne un banco fijo de características de posiciones articulares procedentes de trayectorias del profesor.
- 02El estudiante interactúa con el entorno y produce sus propias trayectorias, sin consultas en línea al profesor.
- 03Un discriminador compara las características de las trayectorias de ambas políticas.
- 04La señal generada por el discriminador sirve como recompensa para el aprendizaje en línea del estudiante.
El resultado principal: una mejora en una tarea de ManiSkill
Los autores evalúan TAD con OpenVLA-OFT, un modelo de visión, lenguaje y acción de 7.000 millones de parámetros, en PutOnPlateInScene25Main, una tarea de ManiSkill. Informan que la tasa de éxito aumenta del 26,2 % al 76,6 % en una métrica denominada éxito de una sola vez. En otra medida, el éxito al final del proceso pasa del 20,3 % al 58,6 %.
La subida en la primera métrica es de 50,4 puntos porcentuales: es la diferencia entre 76,6 % y 26,2 %, no un aumento del 50,4 % respecto al valor inicial. Esa precisión permite dimensionar el cambio sin confundir puntos porcentuales con crecimiento relativo. El resultado es llamativo dentro del experimento, pero se refiere a una única tarea simulada y no basta para inferir el comportamiento del método en otras tareas o en un robot físico.
El resumen indica que cada checkpoint se evalúa con 256 trayectorias. Ese número describe las trayectorias de evaluación reportadas; por sí solo no determina cuántas semillas independientes se emplearon, cómo varía el resultado entre ejecuciones de entrenamiento ni si una réplica independiente obtendría cifras similares. El registro consultado corresponde a la versión inicial del preprint, enviada a arXiv el 24 de octubre de 2026; la información disponible no acredita revisión por pares.
Cifras reportadas para la tarea simulada
Resultados descritos por los autores para OpenVLA-OFT en PutOnPlateInScene25Main, ManiSkill. Son cifras de un preprint, no una evaluación independiente.
| Medida | Antes de TAD | Con TAD | Cambio |
|---|---|---|---|
| Éxito de una sola vez | 26,2 % | 76,6 % | +50,4 puntos porcentuales |
| Éxito al final del proceso | 20,3 % | 58,6 % | +38,3 puntos porcentuales |
La comparación con OPD no iguala los presupuestos
El resumen compara TAD con una modalidad de destilación en línea denominada OPD, que tiene acceso de caja blanca a las puntuaciones del profesor. OPD alcanza el 81,6 % y el 59,4 % en las dos métricas mencionadas. Así, TAD queda 5,0 puntos porcentuales por debajo en éxito de una sola vez y 0,8 puntos por debajo en éxito al final del proceso.
Pero las cifras no corresponden a presupuestos equivalentes. La mejor ejecución de TAD utiliza cinco veces el presupuesto de interacciones del estudiante de OPD y 12,5 veces sus pases de lote de trayectorias completas. Por eso, la comparación muestra que TAD mejora respecto a la política inicial y permite contrastar resultados con OPD, pero no permite concluir que un método sea más eficiente bajo el mismo gasto de interacción y optimización.
Los autores también informan que una continuación de cuatro épocas obtiene el mejor resultado de TAD sin añadir datos del profesor. Es un resultado referido a las configuraciones probadas en el trabajo; no demuestra que cuatro épocas sean una elección óptima en otras tareas, modelos o presupuestos.
TAD y OPD: resultados y recursos reportados
La comparación del resumen incluye presupuestos distintos; las tasas no deben interpretarse como una prueba a igualdad de recursos.
| Método | Éxito de una sola vez | Éxito al final | Presupuesto señalado |
|---|---|---|---|
| TAD | 76,6 % | 58,6 % | La mejor ejecución usa 5 veces las interacciones de estudiante de OPD y 12,5 veces sus pases de lote de trayectorias completas |
| OPD | 81,6 % | 59,4 % | Referencia de comparación; presupuesto menor que el de la mejor ejecución de TAD |
Qué se puede concluir y qué queda fuera del experimento
El resultado respalda una conclusión delimitada: en el experimento descrito, TAD permitió mejorar OpenVLA-OFT en una tarea simulada de ManiSkill sin consultar al profesor en línea ni usar recompensas de tarea del entorno. También muestra que un banco de características de trayectorias puede alimentar un discriminador que proporcione una señal de aprendizaje para esa configuración.
No demuestra, sin embargo, que el método se transfiera a nuevas tareas, entornos distintos o hardware físico. Tampoco acredita que el comportamiento observado sea robusto ante cambios de escena, objetos o condiciones de ejecución. La información del registro consultado no confirma pruebas en un robot real ni evaluaciones en otras tareas, por lo que esos alcances no deben darse por establecidos.
La evidencia disponible es el resumen de un preprint de investigación original. Es una fuente primaria para conocer qué método y resultados declaran sus autores, pero no equivale a una validación independiente. El resumen tampoco permite establecer si el código, las configuraciones y todos los detalles necesarios para reproducir plenamente los resultados están disponibles. Esa limitación no invalida lo reportado; acota qué puede sostenerse con la información accesible.
Cómo leer el avance de TAD
Para valorar una técnica de destilación robótica conviene separar tres preguntas: si mejora frente al punto de partida, si compite bajo recursos comparables y si conserva el resultado fuera de la tarea evaluada. El resumen de TAD aporta una cifra favorable para la primera pregunta, una comparación con OPD que debe leerse teniendo en cuenta el presupuesto desigual y evidencia insuficiente para responder la tercera.
El trabajo plantea una vía interesante para situaciones en que el profesor no expone puntuaciones de acción: utilizar trayectorias ya obtenidas y aprender una recompensa mediante comparación adversarial. Su utilidad práctica dependerá de cuánto cuesten reunir esas trayectorias, de la estabilidad del entrenamiento y de cómo se comporte en condiciones distintas. El resultado citado no mide por sí solo esos factores en una variedad amplia de escenarios.
Por ahora, la lectura más precisa es que TAD ofrece una demostración inicial en una tarea simulada, no una prueba general de destilación robótica ni una validación de despliegue en el mundo físico. Para ampliar la conclusión harían falta evaluaciones comparables en más tareas y entornos, presupuestos equiparados cuando se comparen métodos, y pruebas independientes que permitan estudiar variabilidad y reproducibilidad.
Qué sigue abierto
- El resumen consultado informa de 256 trayectorias de evaluación por checkpoint, pero no permite determinar cuántas semillas independientes se usaron ni la variabilidad entre ejecuciones.
- La información disponible no confirma si el código, las configuraciones y todos los detalles necesarios para reproducir plenamente el resultado están disponibles.
- El preprint no acredita evaluaciones de TAD en otras tareas o entornos ni pruebas en hardware robótico físico.
- El registro consultado corresponde a un preprint enviado a arXiv; no consta allí que el trabajo haya sido revisado por pares.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección