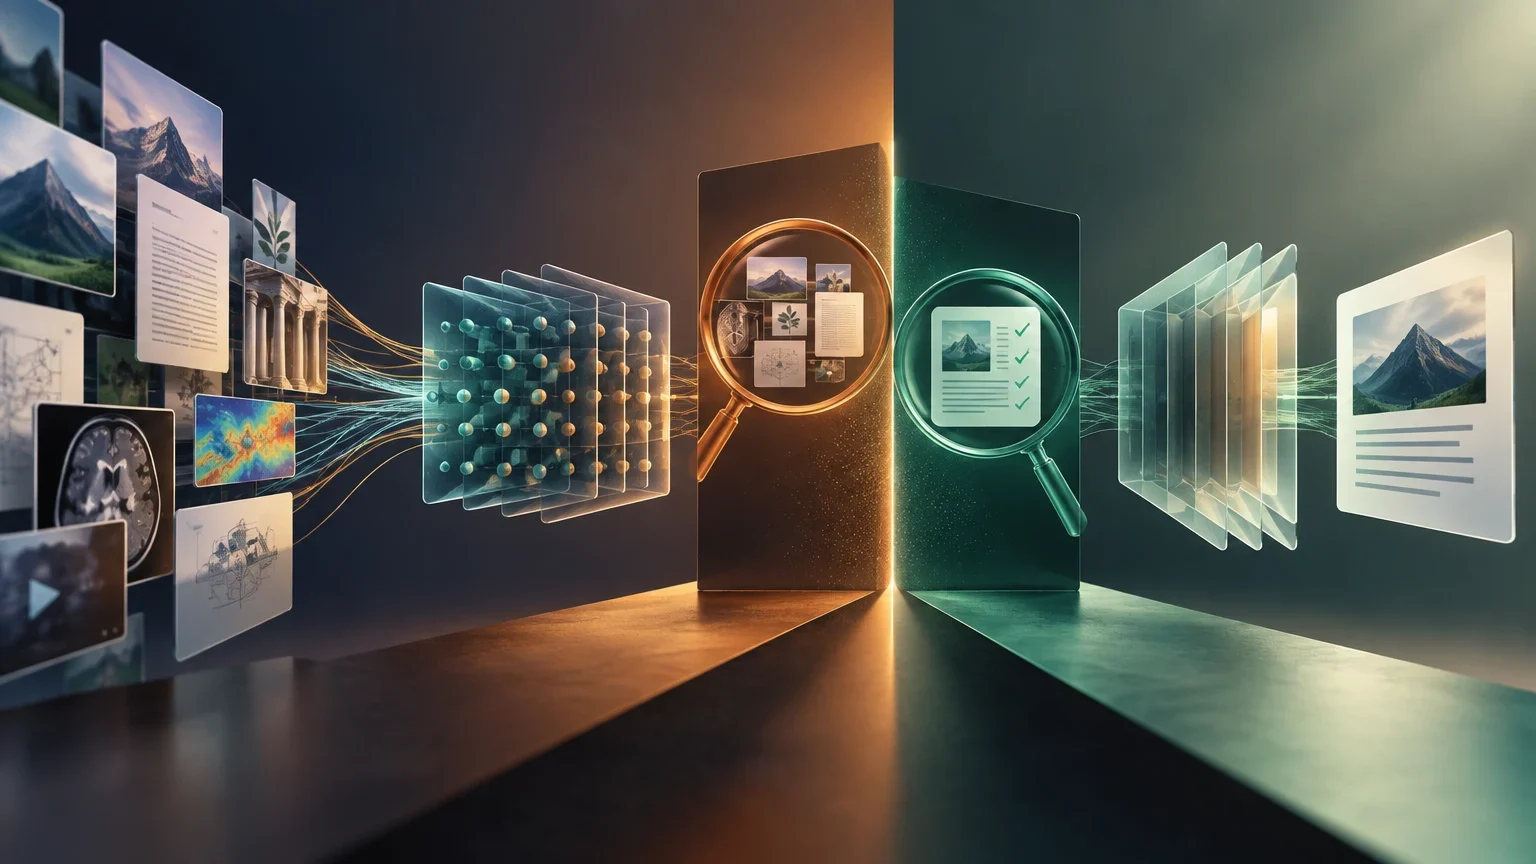
Es handelt sich nicht um einen direkten Vergleich zweier Modelle
Claude Sonnet 5 und Cohere Embed 4 lösen innerhalb einer Retrieval-Augmented-Generation-Architektur, kurz RAG, nicht dieselbe Aufgabe. Ersteres kann die Generierungsschicht besetzen: Es erhält eine Anweisung und abgerufene Evidenz und erzeugt eine Antwort. Letzteres kann die Repräsentations- und Retrievalschicht besetzen: Es transformiert Eingaben in Vektoren, um verwandte Inhalte zu finden, bevor das generierende Modell antwortet. Sie so darzustellen, als sei eines eine Alternative zum anderen, verschleiert die Ursachen der Ergebnisse und führt zu falsch zugeschriebenen Architekturänderungen.
Die operative Frage lautet nicht, welches der beiden Systeme „besser“ ist, sondern welche Kombination aus Retriever und Generator für einen konkreten Korpus, bestimmte Abfragen und vorgegebene Einschränkungen lokalisierte Evidenz und fundierte Antworten liefert. Eine flüssig formulierte Antwort beweist nicht, dass der Index die richtige Quelle gefunden hat. Umgekehrt beweist das Auftauchen der richtigen Passage unter den Ergebnissen nicht, dass das generative Modell sie korrekt interpretiert, zitiert und begrenzt hat.
Die Dokumentation von Anthropic identifiziert das API-Modell als `claude-sonnet-5`. Die Dokumentation von Cohere beschreibt dagegen `embed-v4.0` und verlangt die Angabe eines Eingabetyps, einschließlich der Werte für Suchdokumente, Suchabfragen und Bilder. Diese Fakten erlauben es, die Variablen des Experiments festzulegen; sie erlauben jedoch nicht, allein daraus einen Vorteil für einen bestimmten Unternehmenskor-pus abzuleiten.
Die Bewertung muss das System als Kette beobachtbarer Entscheidungen behandeln: Dokumentkonvertierung, Segmentierung, Indexierung, Retrieval, Zusammenstellung des Kontexts, Generierung, Validierung und Darstellung. Wird nur die finale Antwort gemessen, kann ein Team nicht feststellen, ob ein Fehler von einer fehlenden Seite, einem zu kleinen Chunk, einer falsch vektorisierten Abfrage, einem abgeschnittenen Kontext oder einer unbelegten generierten Behauptung herrührt.
Was jede Schicht beitragen kann – und was technische Datenblätter nicht belegen
Cohere stellt Embed Multimodal v4 als Familie einheitlicher multimodaler Embeddings vor. Die Dokumentation nennt Retrieval zwischen Text und Bild sowie zwischen Text und gemischten Modalitäten, außerdem einen angekündigten Kontext von bis zu 128k und Matryoshka-Dimensionen von 256, 512, 1024 und 1536. In einem RAG für PDFs mit Text, Tabellen und Bildern rechtfertigen diese Eigenschaften, kohärente Repräsentationen unterschiedlicher Evidenztypen zu testen. Sie beweisen nicht, dass eine bestimmte Dimension oder auch nur ein multimodales Embedding jede Dokumentensammlung verbessert.
Die gewählte Dimension ist eine Experimentvariable und kein bloßes Implementierungsdetail. Sie beeinflusst Speicherbedarf, Suchlatenz und möglicherweise das Nachbarschaftsverhalten des Index. Dasselbe gilt für die Repräsentation einer Seite: als extrahierter Text, als Seitenbild, als Tabellenregion, als Kombination dieser Objekte oder als mehrere über Metadaten verknüpfte Einheiten. Ein reproduzierbarer Test muss diese Entscheidung in allen Zweigen beibehalten, die nicht ausdrücklich die Indexierung untersuchen.
Claude Sonnet 5 sollte als Nutzer von Evidenz bewertet werden, nicht als stillschweigender Ersatz für Retrieval. Eine korrekte Antwort, obwohl die Evidenz nicht im Kontext erschien, kann aus dem Vorwissen des Modells, aus einem Zufallstreffer oder aus einem Fehler im Pipeline-Protokoll stammen. In einer Anwendung, die Antworten ausschließlich auf den Korpus stützen muss, belegt dieser Fall kein erfolgreiches Retrieval: Er muss als nicht dem Dokumentbestand zurechenbare Antwort gekennzeichnet oder aus der Metrik fundierter Antworten ausgeschlossen werden.
Auch generative Modelle können scheitern, obwohl sie die richtigen Passagen erhalten. Sie können eine Bedingung aus einer Tabelle auslassen, zwei unvereinbare Quellen zusammenführen, eine Zahl außerhalb ihres Geltungsbereichs interpretieren oder eine Quelle zitieren, die zwar verwandt ist, die Behauptung aber nicht stützt. Zitate sind daher bewertbare Objekte und kein Oberflächenschmuck.
Schichten, beobachtbare Ausgaben und Fehler, die nicht verwechselt werden dürfen
| Schicht | Aufzubewahrende Ausgabe | Beobachtbarer Fehler | Übliche Entscheidung |
|---|---|---|---|
| Konvertierung und Chunking | Seite, Region, extrahierter Text und Metadaten | Evidenz verschwindet oder verliert ihre Struktur | Parser, OCR und Segmentierung prüfen |
| Embedding und Index | Vektor, Modalität, Dimension und Indexversion | Evidenz existiert, erscheint aber nicht in den Ergebnissen | Repräsentation, Filter, Embedding oder Retrieval prüfen |
| Generierung | Exakter Kontext, Anweisung und Antwort | Evidenz wurde abgerufen, aber ignoriert oder verzerrt | Modell, Prompt und Ausgabelimit prüfen |
| Validierung | Behauptung, Zitat und Stützungsurteil | Das Zitat stützt die Aussage nicht | Prüfung und menschliche Begutachtung ergänzen |
Einen Korpus aufbauen, der Diagnose statt bloßer Bewertung ermöglicht
Der Evaluierungskorpus muss vor dem Vergleich der Konfigurationen eingefroren werden. Nehmen Sie native und gescannte PDFs auf, überwiegend textbasierte Seiten, Tabellen mit Überschriften und Fußnoten, Bilder mit relevanten Informationen sowie Dokumente, die diese Elemente kombinieren. Das Ziel besteht nicht darin, alle Varianten von Unternehmensdokumentation nachzubilden, sondern präzise zu deklarieren, welche Varianten enthalten sind, und zu verhindern, dass ein scheinbarer Fortschritt von während des Tests hinzugefügten oder korrigierten Dokumenten abhängt.
Jede Abfrage benötigt eine Referenzantwort und vor allem eine Definition ausreichender Evidenz. Diese Evidenz kann aus einer Seite, einer Tabellenregion, mehreren verteilten Passagen oder einer Kombination aus Text und Bild bestehen. Erfassen Sie stabile Kennungen für Dokument, Version, Seite, Region und Chunk. Wenn die Evidenz verteilt ist, muss das Retrieval-Urteil das notwendige Set verlangen und darf nicht nur einen seiner Bestandteile akzeptieren.
Es empfiehlt sich, Abfragen nach ihrem Evidenzmuster zu schichten. Abfragen mit Einzelbeleg zeigen, ob der Retriever eine lokalisierte Tatsache findet. Mehrquellenabfragen zeigen, ob er die erforderlichen Bestandteile liefert, ohne ihren Zusammenhang zu verlieren. Widersprüchliche Abfragen testen, ob das System Herkunft und Widerspruch bewahrt, statt eine Quelle willkürlich auszuwählen. Abfragen ohne Evidenz prüfen, ob der Assistent sich enthält, statt die Antwort mit externem Wissen oder einer ungerechtfertigten Schlussfolgerung zu vervollständigen.
Reservieren Sie einen finalen Split, der nicht zur Anpassung von Chunk-Größe, Überlappung, Dimensionen, Anzahl der Ergebnisse, Anweisungen oder Validierungsregeln verwendet wird. Wird nach Sichtung des Test-Splits eine Entscheidung getroffen, ist dieser Split keine unabhängige Messung mehr. Stichprobengröße, Verteilung nach Schichten und das Annotationsprotokoll müssen zusammen mit den Ergebnissen veröffentlicht werden.
Bedingungen vor der Ausführung der faktoriellen Matrix festschreiben
Der Vergleich verlangt eine explizite Basispipeline. Halten Sie Parser oder OCR, Richtlinie zur Seitenauflösung, Chunking, Überlappung, Metadaten, Vektordatenbank, Filter, Suchmethode, Zahl abgerufener Ergebnisse, gegebenenfalls Reranking, Kontextzusammenstellung, Prompt, Zitierrichtlinie, maximales Ausgabevolumen und Wiederholungsversuche konstant. Ändert sich eines dieser Elemente zwischen den Zweigen, lässt sich der Effekt weder Cohere Embed 4 noch Claude Sonnet 5 eindeutig zuschreiben.
Dokumentieren Sie außerdem Zugangskanal, Datum und Uhrzeit der Abfrage, gegebenenfalls Region, Version von SDK oder API, effektive Modellkennung und die gesendeten Parameter. Für Cohere Embed 4 erfassen Sie mindestens `embed-v4.0`, Dimension, Modalität jedes Objekts und `input_type`. Die Endpoint-Dokumentation unterscheidet die Verwendungen `search_document`, `search_query` und `image`; unterschiedliche Typen ohne Kennzeichnung einzusetzen, würde den Test verändern. Bewahren Sie für Claude Sonnet 5 die effektive Anfrage, die unbearbeitete Antwort und den beigefügten Kontext auf.
Definieren Sie eine nützliche und reproduzierbare Baseline. Sie kann aus einem bereits vom Team verwendeten Embedding und einem bestehenden Generator bestehen, muss jedoch während des Experiments unverändert bleiben. Stellen Sie die Baseline nicht als universelle Referenz dar: Sie ist nur der Vergleichspunkt für dieses System. Wird Reranking eingesetzt, muss es in allen vier Zweigen gleich bleiben oder als zusätzlicher Faktor bewertet werden, weil es Retrieval-Unterschiede verschleiern oder verstärken könnte.
Die Analyseeinheit sollte die Abfrage sein, aber die Ergebnisse müssen auch nach Dokumenttyp und Evidenzmuster gruppiert werden. Ein globaler Durchschnitt kann verdecken, dass eine Änderung das Auffinden visueller Seiten verbessert und kurze Textfragen verschlechtert oder dass sie den Recall steigert, zugleich aber dem Generator mehr irrelevanten Kontext zuführt.
Verfahren zum Einfrieren
- 01Versionieren Sie Korpus, Annotationen und Abfrageliste; vergeben Sie unveränderliche Kennungen.
- 02Führen Sie Konvertierung, OCR und Segmentierung einmal je Repräsentationskonfiguration aus und speichern Sie deren Artefakte.
- 03Deklarieren Sie Index-, Such-, Kontext-, Prompt- und Validierungsparameter vor der Bewertung.
- 04Protokollieren Sie jedes Retrieval und jeden exakten Kontext, der mit einer Antwort verbunden ist.
- 05Sperren Sie Anpassungen am finalen Split und analysieren Sie diesen Split genau einmal.
Die faktorielle Matrix: vier Konfigurationen, eine Frage der Zuschreibung
Führen Sie vier Zweige mit denselben Abfragen aus. Der erste verwendet den Referenz-Retriever und den Referenz-Generator. Der zweite ersetzt nur die Embedding-Schicht durch Cohere Embed 4 und behält den Basisgenerator bei. Der dritte behält das Basis-Retrieval bei und verwendet nur Claude Sonnet 5 zur Generierung. Der vierte kombiniert Cohere Embed 4 und Claude Sonnet 5. Falls das System eines davon bereits als Referenz nutzt, definieren Sie die Zweige so neu, dass jeder Faktor weiterhin eine eindeutig identifizierte Kontrollbedingung hat.
Diese Matrix erlaubt die Schätzung bedingter Änderungen, nicht die Aufstellung einer absoluten Rangfolge zwischen Anbietern. Der Unterschied zwischen dem ersten und zweiten Zweig wird als Änderung interpretiert, die unter dem Basisgenerator mit dem Retrieval zusammenhängt. Der Unterschied zwischen dem ersten und dritten Zweig bildet die Änderung der Generierung bei durch die Baseline abgerufener Evidenz ab. Der vierte Zweig zeigt das Verhalten der Kombination einschließlich einer möglichen Interaktion: Der Generator kann andere Evidenz besser verwerten, oder eine Retrieval-Änderung kann sich nicht in besseren Antworten niederschlagen.
Führen Sie mehrere Wiederholungen aus, falls die Generierung nicht deterministisch ist, und bewahren Sie Seeds oder Sampling-Parameter auf, sofern sie verfügbar sind. Für Aufgaben zu Genauigkeit und Enthaltung verringert eine konservative Generierungskonfiguration die Varianz und erleichtert die Prüfung. Der Kostenvergleich muss amortisierte Indexierung, Query-Embedding, Retrieval, Generierung, Validierung und Wiederholungsversuche umfassen; nur Generierungskosten auszuweisen, würde Ausgaben von einer Schicht in eine andere verschieben, ohne den realen Betrieb abzubilden.
Lesart der faktoriellen Matrix
| Retrieval | Generierung | Analytischer Nutzen |
|---|---|---|
| Baseline | Baseline | Referenzpunkt des aktuellen Systems |
| Cohere Embed 4 | Baseline | Effekt einer Änderung von Repräsentation und Retrieval |
| Baseline | Claude Sonnet 5 | Effekt einer Änderung der Generierung bei derselben Evidenz |
| Cohere Embed 4 | Claude Sonnet 5 | Ergebnis der Kombination und Interaktion zwischen den Schichten |
Evidenz und Antwort als unterschiedliche Ergebnisse messen
Messen Sie für das Retrieval den Evidenz-Recall: den Anteil der Abfragen, bei denen ausreichende Evidenz unter den an den Generator übergebenen Ergebnissen erscheint. Ergänzen Sie ihn durch Retrieval-Präzision beziehungsweise den Anteil relevanter Ergebnisse, denn eine ungezielte Erhöhung der Chunk-Anzahl kann den Recall steigern und den Kontext verschlechtern. Messen Sie bei Fragen mit verteilter Evidenz den vollständigen Abruf des annotierten Sets und nicht nur das Vorhandensein einer Teilquelle.
Bewerten Sie für die Antwort die faktische Treue gegenüber den Dokumenten, die Abdeckung der von der Abfrage verlangten Punkte, die Genauigkeit der Enthaltung bei fehlender Evidenz und die Formatgültigkeit, wenn die Anwendung eine Struktur wie JSON verlangt. Abdeckung ist nicht gleich Treue: Eine Antwort kann alle Themen erwähnen und dennoch eine falsche Zahl enthalten. Treue ist auch nicht gleich Nutzen: Eine streng belegte Antwort kann eine notwendige Bedingung auslassen.
Fügen Sie eine Metrik für gestützte Zitate auf Ebene jeder überprüfbaren Behauptung hinzu. Eine begutachtende Person, idealerweise blind gegenüber der Konfiguration, muss entscheiden, ob das Zitat oder die Herkunftsreferenz genau die zugehörige Behauptung stützt. Ein automatisierter Grader mit geprüfter Rubrik kann eingesetzt werden, muss jedoch anhand einer menschlich überprüften Stichprobe abgeglichen werden; auch seine Meinungsverschiedenheiten sind aufzubewahren. RAGBench schlägt einen erklärbaren Bewertungsansatz vor, der dafür geeignet ist, Ergebnisse aufzuschlüsseln, statt sie auf eine Endpunktzahl zu reduzieren.
Berichten Sie p50- und p95-Latenz je Antwort, nicht nur Durchschnittswerte. Trennen Sie Indexierungszeit von Abfragezeit, auch wenn Sie Erstere als amortisierten Kostenbestandteil in eine wirtschaftliche Metrik einbeziehen. Für Produktentscheidungen ist meist Kosten- und Latenzaufwand pro korrekter fundierter Antwort am nützlichsten, sofern die Definition von „korrekt“ veröffentlicht wird und der Nenner angemessene Enthaltungen einschließt.
Fehlermuster diagnostizieren
Wenn die annotierte Evidenz nicht unter den Ergebnissen erscheint, gehört der Vorfall zunächst zum Retrieval oder zu einer vorgelagerten Konvertierungs- und Indexierungsstufe. Prüfen Sie, ob Text oder Bild nach dem Parser verfügbar waren, ob die indexierte Einheit den Tabellenkontext bewahrt hat, ob Metadaten das Dokument herausgefiltert haben und ob die Abfrage die deklarierte Modalität und den passenden Eingabetyp verwendet hat. Ein Wechsel des Generators behebt nicht das Fehlen von Evidenz im Kontext.
Wenn ausreichende Evidenz erscheint, die Antwort aber falsch ist, betrifft der Vorfall die Evidenznutzung – außer die Kontextzusammenstellung hat die relevante Passage abgeschnitten, bevor sie gesendet wurde. Vergleichen Sie den übergebenen Text mit der finalen Behauptung: Das offenbart Auslassungen, Quellenvermischungen, überzogene Schlussfolgerungen und ignorierte Widersprüche. Hier kann es sinnvoll sein, Anweisung, Kontextstruktur, Ausgabelimit oder generatives Modell zu untersuchen.
Ein dekoratives Zitat ist ein separates Muster: Die Antwort enthält eine echte Referenz, aber sie stützt nicht die konkrete Aussage. Dies kommt besonders häufig vor, wenn das Dokument verwandte Begriffe enthält oder wenn eine Tabelle auf Seitenebene zitiert wird, die Zahl jedoch aus einer anderen Zeile stammt. Es bloß als falsche Antwort zu kennzeichnen, verhindert die Feststellung, ob das Problem bei der Zitaterzeugung, der Granularität der Herkunft oder der nachgelagerten Validierung liegt.
Eine ungerechtfertigte Enthaltung verlangt die umgekehrte Diagnose. Wenn ausreichende Evidenz abgerufen wurde und das System dennoch antwortete, es könne nicht antworten, können die Anweisung zur Kontextnutzung, die Reihenfolge der Ergebnisse oder die Lesbarkeit des extrahierten Inhalts versagt haben. Gab es keine Evidenz, ist die Enthaltung korrekt, auch wenn sie für Nutzende weniger zufriedenstellend ist. Ein zuverlässiges System muss beide Fälle unterscheiden und seine Grenzen erklären, ohne eine Antwort zu erfinden.
Diagnosebaum pro Abfrage
- 01Existiert ausreichende Evidenz im eingefrorenen Korpus? Falls nicht, bewerten Sie die Enthaltung und nicht das Retrieval.
- 02Hat die Evidenz die abgerufenen Ergebnisse erreicht? Falls nicht, untersuchen Sie Konvertierung, Segmentierung, Embedding, Index und Filter.
- 03Hat die Evidenz den effektiven Kontext des Generators erreicht? Falls nicht, untersuchen Sie top-k, Reranking und Kürzung.
- 04Stimmt die Antwort mit der Evidenz überein und stützt jedes Zitat sie? Falls nicht, untersuchen Sie Generierung, Kontextzusammenstellung und Validierung.
- 05War die Antwort ohne Evidenz im Kontext korrekt? Kennzeichnen Sie sie als nicht einem fundierten RAG zurechenbar.
Entscheidungen treffen, ohne über das Experiment hinaus zu extrapolieren
Ändern Sie die Retrievalschicht, wenn der wichtigste Mangel im Fehlen relevanter Evidenz liegt, insbesondere in Teilmengen, in denen Text, Bilder oder gemischte Seiten wechselseitig auffindbar sein müssen. Bevor Sie das Embedding als Ursache einstufen, schließen Sie OCR-, Chunking- und Metadatenfehler aus. Eine von ihren Überschriften getrennte Tabelle kann beispielsweise mit jedem Embedding scheitern, weil die indexierte Einheit die notwendige Semantik verloren hat.
Ändern oder justieren Sie die Generierungsschicht, wenn Evidenz ausreichend und stabil ankommt, die Antwort sie jedoch falsch verwendet. Selbst dann sollten Sie nicht annehmen, dass der Modellname jede Änderung erklärt: Testen Sie Zitat-Anweisungen, Kontextformate und Enthaltungsregeln im Entwicklungs-Split und bestätigen Sie sie im finalen Split. Claude Sonnet 5 muss über gleichwertige Anfragen und vollständige Protokolle verglichen werden, nicht über ausgewählte Beispiele.
Ziehen Sie Reranking in Betracht, wenn der anfängliche Recall angemessen ist, die ersten Ergebnisse aber zu viel Rauschen enthalten oder entscheidende Evidenz zurückstufen. Ziehen Sie menschliche Überprüfung für Antworten mit hoher Tragweite, dokumentarische Widersprüche, komplexe Tabellen oder Fälle in Betracht, in denen die automatische Validierung keine ausreichende Übereinstimmung mit den Gutachtenden erzielt. Keine dieser Maßnahmen ersetzt die Messung jeder Schicht: Sie fügt eine weitere Variable hinzu, die ebenfalls prüfbar sein muss.
Veröffentlichen Sie zusammen mit den Ergebnissen eine Experimentkarte: Definition und Version des Korpus, Annotationsschema, Abfrageverteilung, effektive Konfigurationen, Retrieval-Artefakte, Grader-Kriterien, Übereinstimmung zwischen Bewertenden, Intervalle oder statistische Unsicherheit, Latenz, Kosten und repräsentative Fehler. Veröffentlichen Sie nicht nur eine aggregierte Rate oder Demonstrationsbeispiele. Der Rahmen zur Bewertung der Retrievalqualität und Arbeiten zu multimodalem RAG unterstreichen, dass Evidenzzugang und Antwort getrennt beobachtet werden müssen.
Die Ergebnisse lassen sich nicht automatisch auf alle Unternehmensrepositorien verallgemeinern. Der Anteil gescannter PDFs, Sprachen, OCR-Qualität, Tabellendichte, Berechtigungen, Dokumentaktualisierung und Kostentoleranz können die Entscheidung verändern. Die vertretbare Schlussfolgerung ist lokal: Unter dokumentierten Bedingungen hat eine Konfiguration bestimmte Evidenz besser abgerufen oder treuere Antworten erzeugt. Diese Präzision ist nützlicher, als Modellen, die unterschiedliche Funktionen erfüllen, allgemeine Fähigkeiten zuzuschreiben.
Offene Fragen
- Anbieterdokumentationen beschreiben Fähigkeiten und Kennungen, garantieren jedoch keine relativen Ergebnisse in einem spezifischen Unternehmenskor-pus.
- Das Verhalten kann mit OCR, Parser, Sprache, Chunking-Strategie, Filtern, Dimensionen, top-k, Reranking und Kontextzusammenstellung variieren.
- Die Bewertung von Treue und Zitatstützung enthält menschliches Urteil; Rubrik, Übereinstimmung zwischen Gutachtenden und Meinungsverschiedenheiten müssen veröffentlicht werden.
- Es werden keine experimentellen Ergebnisse für die vier Konfigurationen vorgelegt; der Artikel definiert ein Bewertungsprotokoll und keine Leistungsrangfolge.
- Verfügbarkeit, Preise, Zugangskanäle und effektive Parameter müssen zum Zeitpunkt jeder Ausführung überprüft und protokolliert werden.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen