Il ne s’agit pas d’une comparaison directe entre deux modèles
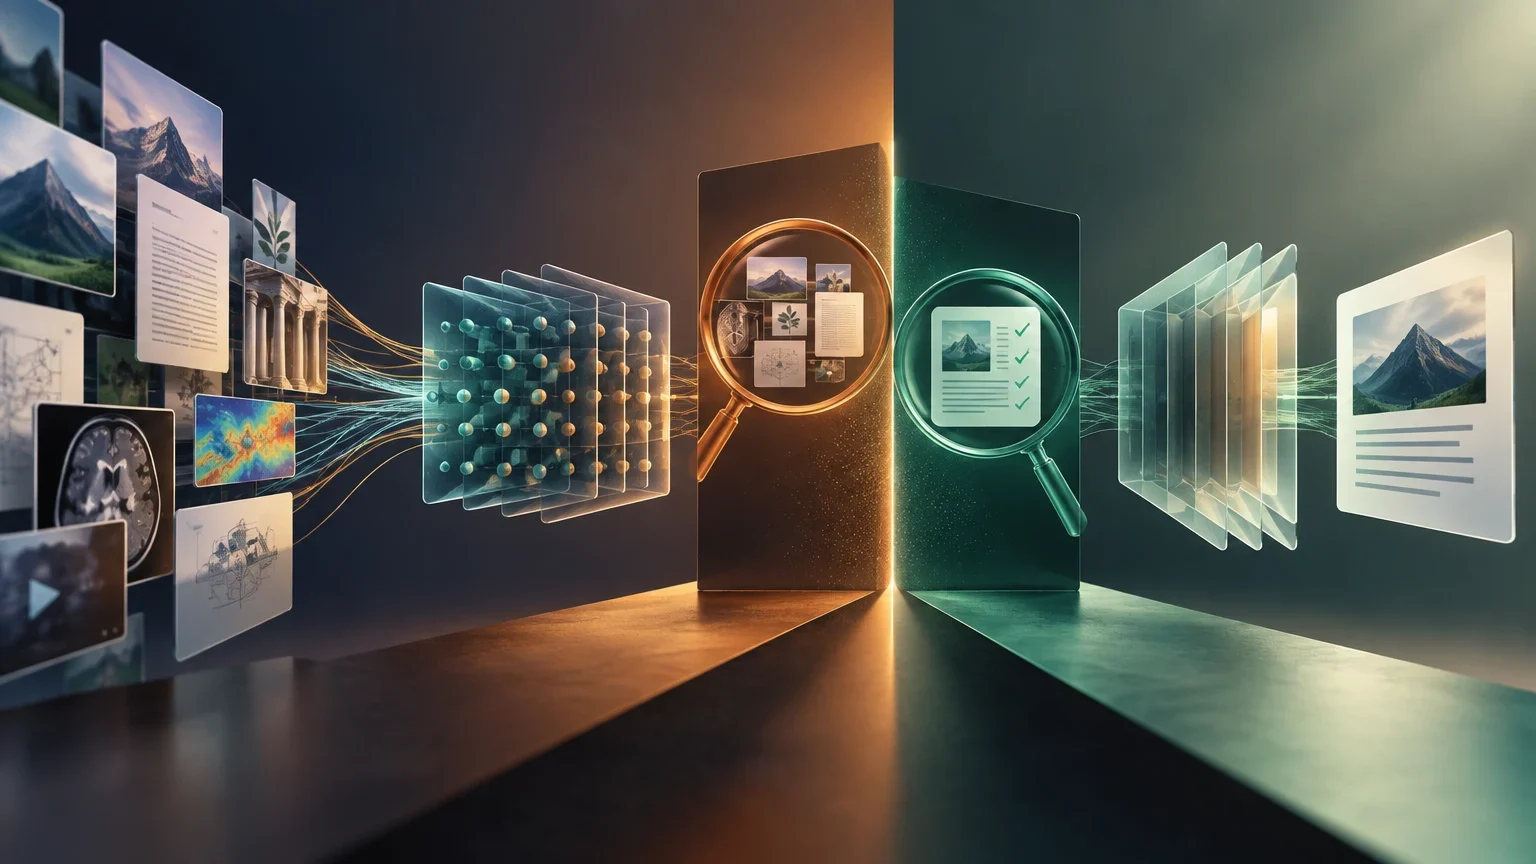
Claude Sonnet 5 et Cohere Embed 4 ne réalisent pas la même tâche dans une architecture de génération augmentée par récupération, ou RAG. Le premier peut occuper la couche de génération : il reçoit une instruction et des preuves récupérées, puis produit une réponse. Le second peut occuper la couche de représentation et de récupération : il transforme les entrées en vecteurs afin de localiser des contenus associés avant que le générateur ne réponde. Les présenter comme si l’un était une alternative à l’autre masque l’origine des résultats et peut conduire à des modifications d’architecture mal attribuées.
La question opérationnelle n’est pas de savoir lequel est « meilleur », mais quelle combinaison de récupérateur et de générateur fournit des preuves localisées et des réponses étayées pour un corpus, des requêtes et des contraintes précis. Une réponse fluide ne démontre pas que l’index a trouvé la bonne source. De même, la présence du passage adéquat parmi les résultats ne démontre pas que le modèle génératif l’a correctement interprété, cité et limité.
La documentation d’Anthropic identifie le modèle d’API sous le nom `claude-sonnet-5`. De son côté, la documentation de Cohere décrit `embed-v4.0` et exige la déclaration d’un type d’entrée, notamment des valeurs destinées aux documents de recherche, aux requêtes de recherche et aux images. Ces éléments permettent de fixer les variables de l’expérience, mais ne permettent pas, à eux seuls, de déduire un avantage sur un corpus d’entreprise donné.
L’évaluation doit traiter le système comme une chaîne de décisions observables : conversion du document, segmentation, indexation, récupération, composition du contexte, génération, validation et présentation. Si seule la réponse finale est mesurée, une équipe ne peut pas déterminer si une erreur provient d’une page absente, d’un fragment trop petit, d’une requête mal vectorisée, d’un contexte tronqué ou d’une affirmation générée sans fondement.
Ce que chaque couche peut apporter, et ce que leurs fiches techniques ne démontrent pas
Cohere présente Embed Multimodal v4 comme une famille d’embeddings multimodaux unifiés. Sa documentation indique une récupération entre texte et image, ainsi qu’entre texte et modalités mixtes, un contexte annoncé allant jusqu’à 128k et des dimensions Matryoshka de 256, 512, 1024 et 1536. Dans un RAG appliqué à des PDF contenant du texte, des tableaux et des images, ces propriétés justifient de tester des représentations cohérentes de différents types de preuves. Elles ne démontrent pas qu’une dimension précise, ni même un embedding multimodal, améliore l’ensemble d’une collection documentaire.
La dimension retenue est une variable expérimentale, et non un simple détail d’implémentation. Elle affecte le stockage, la latence de recherche et potentiellement le comportement de voisinage de l’index. La manière de représenter une page a également un effet : texte extrait, image de page, région de tableau, combinaison de ces objets ou plusieurs unités liées par des métadonnées. Un test reproductible doit conserver ce choix dans toutes les branches qui n’évaluent pas explicitement l’indexation.
Claude Sonnet 5 doit être évalué comme un consommateur de preuves, et non comme un substitut silencieux à la récupération. Une réponse correcte alors que la preuve n’apparaît pas dans le contexte peut provenir de la connaissance préalable du modèle, d’une coïncidence favorable ou d’un défaut dans le journal du pipeline. Dans une application imposant des réponses fondées uniquement sur le corpus, ce cas ne valide pas la récupération : il doit être étiqueté comme réponse non attribuable au jeu documentaire ou exclu de la métrique de réponse étayée.
Les modèles génératifs peuvent aussi échouer lorsqu’ils reçoivent les bons passages. Ils peuvent omettre une condition présente dans un tableau, fusionner deux sources incompatibles, interpréter une valeur en dehors de son périmètre ou inclure une citation qui pointe vers une source connexe sans étayer l’affirmation. Les citations sont donc des objets évaluables, et non des ornements d’interface.
Couches, observables et erreurs à ne pas confondre
| Couche | Sortie à conserver | Défaillance observable | Décision habituelle |
|---|---|---|---|
| Conversion et segmentation | Page, région, texte extrait et métadonnées | La preuve disparaît ou perd sa structure | Revoir le parseur, l’OCR et la segmentation |
| Embedding et index | Vecteur, modalité, dimension et version de l’index | La preuve existe mais n’apparaît pas dans les résultats | Revoir la représentation, le filtre, l’embedding ou la récupération |
| Génération | Contexte exact, instruction et réponse | La preuve a été récupérée mais est ignorée ou déformée | Revoir le modèle, le prompt et la limite de sortie |
| Validation | Affirmation, citation et verdict d’étayage | La citation ne soutient pas ce qui est affirmé | Ajouter un contrôle et une revue humaine |
Construire un corpus qui permet de diagnostiquer, et pas seulement de noter
Le corpus d’évaluation doit être figé avant de comparer les configurations. Incluez des PDF natifs et numérisés, des pages principalement textuelles, des tableaux avec en-têtes et notes de bas de page, des images portant une information pertinente, ainsi que des documents combinant ces éléments. L’objectif n’est pas de reproduire toutes les variantes de la documentation d’entreprise, mais de déclarer avec précision celles qui sont incluses et d’éviter qu’une amélioration apparente ne dépende de documents ajoutés ou corrigés pendant le test.
Chaque requête nécessite une réponse de référence et, surtout, une définition de la preuve suffisante. Cette preuve peut être une page, une région de tableau, plusieurs passages répartis ou une combinaison de texte et d’image. Enregistrez des identifiants stables pour le document, sa version, sa page, sa région et son fragment. Lorsque la preuve est répartie, le jugement de récupération doit exiger l’ensemble nécessaire, et non seulement l’un de ses composants.
Il est utile de stratifier les requêtes selon leur schéma probatoire. Celles à preuve unique révèlent si le récupérateur trouve un fait localisé. Les requêtes multi-sources révèlent s’il fournit toutes les pièces nécessaires sans en perdre la relation. Les requêtes contradictoires vérifient si le système préserve la provenance et la contradiction plutôt que de sélectionner arbitrairement une source. Les requêtes sans preuve vérifient que l’assistant s’abstient au lieu de compléter sa réponse avec une connaissance externe ou une inférence injustifiée.
Réservez une partition finale qui ne soit pas utilisée pour ajuster la taille des fragments, le chevauchement, les dimensions, le nombre de résultats, les instructions ou les règles de validation. Lorsqu’une décision est prise après observation de la partition de test, cette partition cesse d’être une mesure indépendante. La taille de l’échantillon, sa distribution par strate et le protocole d’annotation doivent être publiés avec les résultats.
Figer les conditions avant d’exécuter la matrice factorielle
La comparaison exige un pipeline de référence explicite. Conservez le parseur ou l’OCR, la politique de résolution des pages, la segmentation, le chevauchement, les métadonnées, la base vectorielle, les filtres, la méthode de recherche, le nombre de résultats récupérés, le reranking — s’il existe —, la composition du contexte, le prompt, la politique de citation, le maximum de sortie et les nouvelles tentatives. Si l’un de ces éléments varie entre les branches, l’effet ne peut pas être attribué proprement à Cohere Embed 4 ou à Claude Sonnet 5.
Documentez également le canal d’accès, la date et l’heure de consultation, la région lorsque cela s’applique, la version du SDK ou de l’API, l’identifiant effectif du modèle et les paramètres envoyés. Pour Cohere Embed 4, enregistrez au minimum `embed-v4.0`, la dimension, la modalité de chaque objet et `input_type`. La documentation de l’endpoint distingue les usages `search_document`, `search_query` et `image` ; utiliser des types différents sans le consigner modifierait l’expérience. Pour Claude Sonnet 5, conservez la requête effective, la réponse non post-traitée et le contexte qui l’accompagnait.
Définissez un baseline utile et reproductible. Il peut s’agir d’un embedding déjà adopté par l’équipe et d’un générateur existant, mais il doit rester inchangé pendant l’expérience. Ne présentez pas ce baseline comme une référence universelle : il n’est que le point de comparaison de ce système. Si vous ajoutez un reranking, il doit rester identique dans les quatre branches ou être évalué comme un facteur supplémentaire, car il peut masquer ou amplifier des différences de récupération.
L’unité d’analyse doit être la requête, mais les résultats doivent aussi être regroupés par type de document et par schéma de preuve. Une moyenne générale peut dissimuler qu’un changement aide à localiser des pages visuelles tout en dégradant des questions textuelles courtes, ou qu’il améliore le rappel tout en augmentant la quantité de contexte non pertinent transmise au générateur.
Procédure de gel
- 01Versionnez le corpus, les annotations et la liste des requêtes ; attribuez des identifiants immuables.
- 02Exécutez la conversion, l’OCR et la segmentation une fois par configuration de représentation, puis conservez leurs artefacts.
- 03Déclarez les paramètres d’index, de recherche, de contexte, de prompt et de validation avant l’évaluation.
- 04Enregistrez chaque récupération et chaque contexte exact associé à une réponse.
- 05Interdisez les ajustements sur la partition finale et analysez cette partition une seule fois.
La matrice factorielle : quatre configurations, une seule question d’attribution
Exécutez quatre branches sur les mêmes requêtes. La première utilise le récupérateur et le générateur de référence. La deuxième ne remplace que la couche d’embeddings par Cohere Embed 4, en conservant le générateur de base. La troisième conserve la récupération de base et utilise uniquement Claude Sonnet 5 pour générer. La quatrième combine Cohere Embed 4 et Claude Sonnet 5. Si le système utilise déjà l’un d’eux comme référence, redéfinissez les branches afin que chaque facteur conserve une condition de contrôle clairement identifiable.
Cette matrice permet d’estimer des changements conditionnels, et non d’établir une hiérarchie absolue entre fournisseurs. La différence entre la première et la deuxième branche s’interprète comme un changement associé à la récupération sous le générateur de base. La différence entre la première et la troisième reflète le changement de génération avec des preuves récupérées par le baseline. La quatrième montre le comportement de la combinaison, y compris une interaction possible : le générateur peut mieux exploiter des preuves différentes, ou une modification de récupération peut ne pas se traduire par de meilleures réponses.
Réalisez plusieurs répétitions si la génération n’est pas déterministe et conservez les graines ou les paramètres d’échantillonnage lorsqu’ils sont disponibles. Pour les tâches d’exactitude et d’abstention, une configuration de génération prudente réduit la variance et facilite l’audit. La comparaison des coûts doit inclure l’indexation amortie, l’embedding des requêtes, la récupération, la génération, la validation et les nouvelles tentatives ; ne communiquer que le coût de génération déplacerait la dépense d’une couche vers une autre sans refléter l’exploitation réelle.
Lecture de la matrice factorielle
| Récupération | Génération | Usage analytique |
|---|---|---|
| Baseline | Baseline | Point de référence du système actuel |
| Cohere Embed 4 | Baseline | Effet du changement de représentation et de récupération |
| Baseline | Claude Sonnet 5 | Effet du changement de génération sur les mêmes preuves |
| Cohere Embed 4 | Claude Sonnet 5 | Résultat de la combinaison et interaction entre les couches |
Mesurer la preuve et la réponse comme des résultats distincts
Pour la récupération, mesurez le rappel de preuves : la proportion de requêtes pour lesquelles des preuves suffisantes apparaissent parmi les résultats fournis au générateur. Complétez-le par la précision de récupération, ou proportion de résultats pertinents, car augmenter sans discernement le nombre de fragments peut accroître le rappel tout en dégradant le contexte. Pour les questions à preuves réparties, mesurez la récupération complète de l’ensemble annoté, et non seulement la présence d’une source partielle.
Pour la réponse, évaluez la fidélité factuelle vis-à-vis des documents, la couverture des éléments exigés par la requête, l’exactitude de l’abstention lorsqu’aucune preuve n’est présente et la validité du format lorsque l’application impose une structure, telle que JSON. La couverture n’équivaut pas à la fidélité : une réponse peut évoquer tous les thèmes et contenir une valeur erronée. La fidélité n’équivaut pas non plus à l’utilité : une réponse strictement étayée peut omettre une condition nécessaire.
Ajoutez une métrique de citation étayée au niveau de chaque affirmation vérifiable. Un évaluateur, idéalement aveugle à la configuration, doit déterminer si la citation ou la référence de provenance soutient exactement l’affirmation associée. Un grader automatisé assorti d’une grille d’évaluation auditée peut être utilisé, mais il doit être confronté à une revue humaine sur un échantillon, et ses désaccords doivent être conservés. RAGBench propose une approche d’évaluation explicable qui est pertinente pour décomposer les résultats plutôt que de les réduire à un score final.
Rapportez les latences p50 et p95 par réponse, et non seulement des moyennes. Distinguez le temps d’indexation du temps de requête, même si le premier est intégré comme coût amorti dans une métrique économique. Pour les décisions produit, la mesure la plus utile est souvent le coût et la latence par réponse correcte et étayée, à condition de publier la définition de « correcte » et d’inclure les abstentions appropriées dans le dénominateur.
Diagnostiquer les schémas d’erreur
Lorsque la preuve annotée n’apparaît pas parmi les résultats, l’incident relève d’abord de la récupération ou d’une étape antérieure de conversion et d’indexation. Vérifiez si le texte ou l’image était disponible après le parseur, si l’unité indexée conservait le contexte du tableau, si les métadonnées ont filtré le document et si la requête a utilisé la modalité et le type d’entrée déclarés. Changer de générateur ne corrige pas l’absence de preuve dans le contexte.
Lorsque des preuves suffisantes apparaissent bien, mais que la réponse est erronée, l’incident concerne l’utilisation de la preuve, sauf si la composition du contexte a tronqué le passage pertinent avant son envoi. Comparez le texte fourni avec l’affirmation finale : cela révèle des omissions, des mélanges de sources, des inférences excessives et des contradictions ignorées. Dans ce cas, il peut être raisonnable d’examiner l’instruction, la structure du contexte, la limite de sortie ou le modèle génératif.
La citation décorative constitue un schéma distinct : la réponse intègre une référence réelle, mais celle-ci ne soutient pas la proposition précise. Ce problème est particulièrement fréquent lorsque le document contient des termes apparentés ou lorsqu’un tableau est cité au niveau de la page alors que la valeur provient d’une autre ligne. L’étiqueter comme une simple réponse incorrecte empêche de savoir si le problème vient de la génération des citations, de la granularité de provenance ou de la validation ultérieure.
L’abstention injustifiée appelle le diagnostic inverse. S’il existait des preuves suffisantes récupérées et que le système a répondu qu’il ne pouvait pas répondre, l’instruction relative à l’usage du contexte, l’ordre des résultats ou la lisibilité du contenu extrait peuvent avoir échoué. S’il n’y avait pas de preuve, l’abstention est correcte, même si elle satisfait moins l’utilisateur. Un système fiable doit distinguer ces deux cas et expliquer ses limites sans inventer de réponse.
Arbre de diagnostic par requête
- 01La preuve suffisante existe-t-elle dans le corpus figé ? Sinon, évaluez l’abstention, et non la récupération.
- 02La preuve a-t-elle atteint les résultats récupérés ? Sinon, examinez la conversion, la segmentation, l’embedding, l’index et les filtres.
- 03La preuve a-t-elle atteint le contexte effectif du générateur ? Sinon, examinez le top-k, le reranking et la troncature.
- 04La réponse correspond-elle à la preuve et chaque citation l’étaye-t-elle ? Sinon, examinez la génération, la composition du contexte et la validation.
- 05La réponse était-elle correcte sans preuve dans le contexte ? Étiquetez-la comme non attribuable à un RAG étayé.
Prendre des décisions sans extrapoler au-delà de l’expérience
Modifiez la couche de récupération lorsque le déficit principal est l’absence de preuves pertinentes, en particulier dans les sous-ensembles où texte, images ou pages mixtes doivent être retrouvés les uns par rapport aux autres. Avant de conclure que l’embedding est en cause, écartez les erreurs d’OCR, de segmentation et de métadonnées. Un tableau séparé de ses en-têtes, par exemple, peut échouer avec n’importe quel embedding parce que l’unité indexée a perdu la sémantique nécessaire.
Modifiez ou ajustez la couche générative lorsque les preuves arrivent de manière suffisante et stable, mais que la réponse les exploite mal. Même dans ce cas, ne supposez pas que le nom du modèle explique à lui seul le changement : testez les instructions de citation, les formats de contexte et les règles d’abstention sur la partition de développement, puis confirmez-les sur la partition finale. Claude Sonnet 5 doit être comparé au moyen de requêtes équivalentes et de journaux complets, et non à partir d’exemples sélectionnés.
Envisagez un reranking si le rappel initial est acceptable, mais que les premiers résultats contiennent trop de bruit ou relèguent des preuves décisives. Envisagez une revue humaine pour les réponses à fort impact, les contradictions documentaires, les tableaux complexes ou les cas où la validation automatisée n’atteint pas un accord suffisant avec les évaluateurs. Aucune de ces mesures ne supprime la nécessité de mesurer chaque couche : elle ajoute une variable qui doit elle aussi être auditée.
Publiez la fiche de l’expérience avec les résultats : définition et version du corpus, schéma d’annotation, distribution des requêtes, configurations effectives, artefacts de récupération, critères du grader, accord entre évaluateurs, intervalles ou incertitude statistique, latence, coût et erreurs représentatives. Ne publiez pas seulement un taux agrégé ni des exemples de démonstration. Le cadre d’évaluation de la qualité de récupération et les travaux sur le RAG multimodal renforcent la nécessité d’observer séparément l’accès aux preuves et la réponse.
Les résultats ne se généralisent pas automatiquement à tous les référentiels d’entreprise. La prévalence des PDF numérisés, les langues, la qualité de l’OCR, la densité des tableaux, les permissions, l’actualisation documentaire et la tolérance au coût peuvent modifier la décision. La conclusion défendable est locale : dans des conditions documentées, une configuration a mieux récupéré certains éléments de preuve ou a produit des réponses plus fidèles. Cette précision est plus utile que d’attribuer des capacités générales à des modèles qui remplissent des fonctions différentes.
Questions ouvertes
- La documentation des fournisseurs décrit des capacités et des identifiants, mais ne garantit pas de résultats relatifs sur un corpus d’entreprise spécifique.
- Le comportement peut varier selon l’OCR, le parseur, la langue, la stratégie de segmentation, les filtres, les dimensions, le top-k, le reranking et la composition du contexte.
- L’évaluation de la fidélité et de l’étayage des citations comporte une part de jugement humain ; la grille d’évaluation, l’accord entre évaluateurs et les désaccords doivent être publiés.
- Aucun résultat expérimental des quatre configurations n’est fourni ; cet article définit un protocole d’évaluation, et non un classement des performances.
- La disponibilité, les prix, les canaux d’accès et les paramètres effectifs doivent être vérifiés et enregistrés au moment de chaque exécution.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction