Das Latenzproblem in Sprachagenten
Voll-Duplex-Sprachagenten müssen während des Sprechens des Nutzers zahlreiche kleine, geschlossene Entscheidungen treffen: Sie bestimmen, ob ein Sprecherwechsel abgeschlossen ist, erkennen Unterbrechungen (Barge-ins) oder wählen passende Füllwörter (Filler) aus. Aktuelle Systeme beantworten diese Anfragen typischerweise durch autogressive Textgenerierung, einen langsamen Prozess, der die Antwort des Agenten blockiert, bis die Dekodierung vollständig abgeschlossen ist.
In einem im Studie analysierten In-Car-Sprachassistenten verbrauchen diese Entscheidungen 30 % aller LLM-Eingabetokens. Diese Last erhöht nicht nur die vom Nutzer wahrgenommene Latenz, sondern erfordert auch zusätzliche Rechenkapazität, um die Flüssigkeit während der Spitzenzeiten aufrechtzuerhalten, was die Betriebskosten steigert.
Die Notwendigkeit, diese Mikro-Entscheidungen in Echtzeit zu treffen, entsteht durch die inhärente Asynchronität zwischen der kontinuierlichen Audioeinführung und der diskreten Natur der textbasierten Sprachverarbeitung. Während der Nutzer spricht, muss das System permanent den aktuellen Zustand des Dialogs bewerten, ohne auf eine vollständige Transkription warten zu können. Diese ständige Überwachung erzeugt einen erheblichen Rechendruck, da jede kleine Verzögerung in der Entscheidungsfindung als Unterbrechung oder Unnatürlichkeit im Gespräch wahrgenommen werden kann. Die autogressive Natur der herkömmlichen Ansätze bedeutet, dass selbst kurze Antworten eine sequentielle Verarbeitung erfordern, die bei hoher Frequenz dieser Mikro-Entscheidungen zu einem kumulativen Engpass wird, der die Reaktionsfähigkeit des gesamten Systems beeinträchtigt.
Architektur: Verbindung zwischen Encoder und eingefrorenem LLM
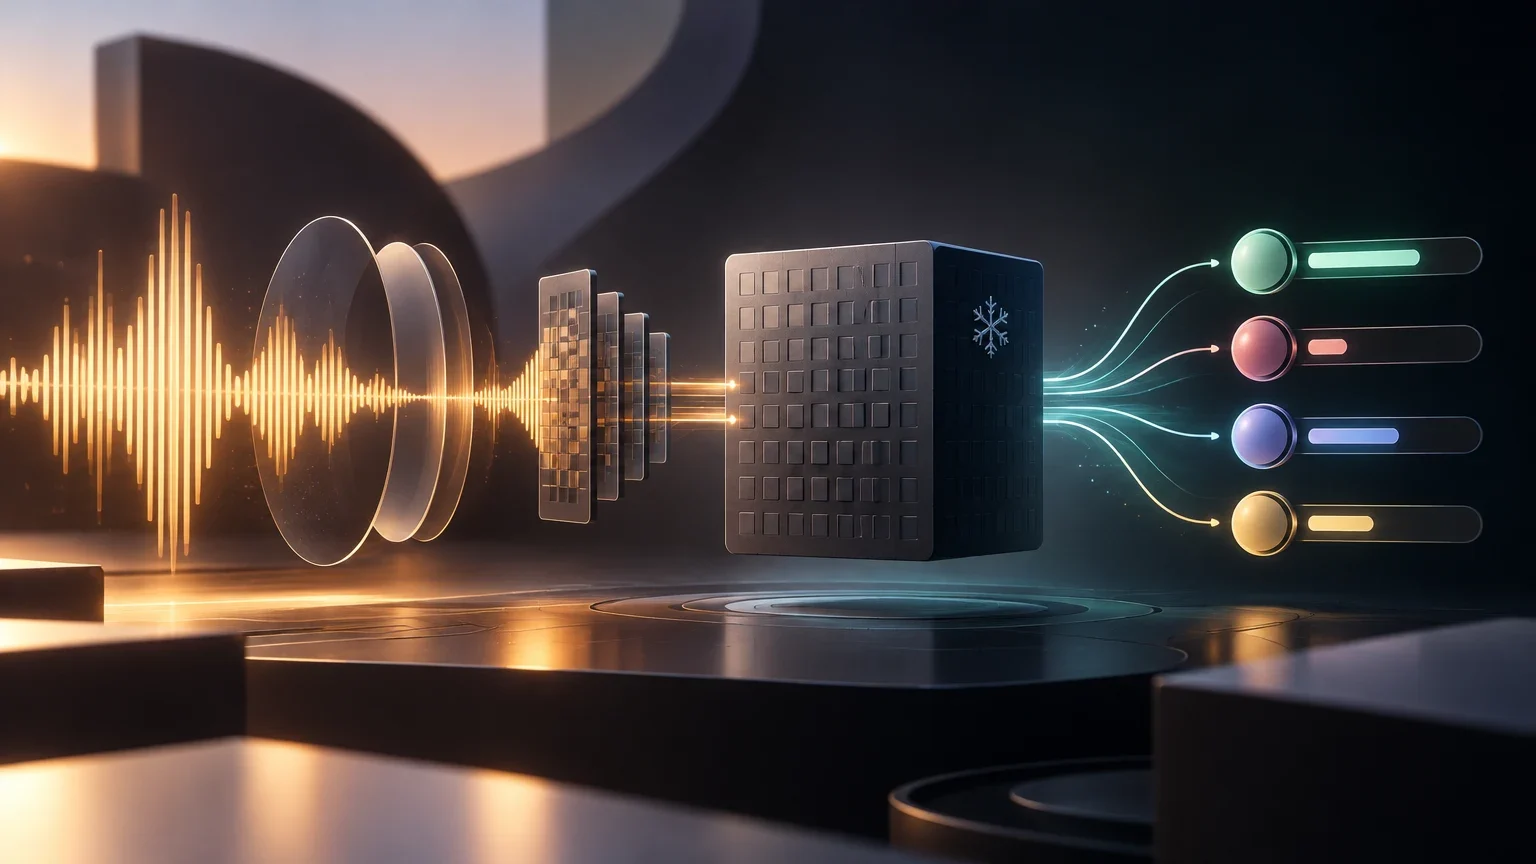
DuplexJev schlägt eine modulare Architektur vor, in der ein ASR-Encoder (Automatische Spracherkennung) und ein generalistisches LLM eingefroren bleiben. Nur ein kleiner Konnektor wird trainiert, um die versteckten Zustände des Encoders in Embeddings zu transformieren, die mit dem Embedding-Raum des LLM kompatibel sind.
Anstatt eine vollständige textuelle Antwort zu dekodieren, formuliert das System jede Frage als Wahrscheinlichkeitsverteilung über einen geschlossenen Satz von Optionen (dargestellt durch Buchstaben). Das LLM führt einen einzigen Inferenz-Durchlauf (Forward Pass) durch, und die Antwort wird aus den Logits an der Position des Antworttokens extrahiert, ohne Sampling- oder Dekodierungsschritte.
Die Entscheidung, den LLM und den ASR-Encoder einzufrieren, basiert auf der Annahme, dass die allgemeine Sprachverständnis- und Sprachextraktionsfähigkeit bereits in diesen großen, vorab trainierten Modellen vorhanden ist. Durch das Einfrieren dieser Komponenten wird sichergestellt, dass die spezifischen Fähigkeiten des LLM, Kontext zu verstehen und logische Schlussfolgerungen zu ziehen, nicht durch das Training auf die spezifische Aufgabe der Latenzreduzierung überlagert oder degradiert werden. Der Konnektor fungiert als adaptiver Übersetzer, der die spezifischen Merkmale der Audioeinführung in einen Raum übersetzt, in dem das eingefrorene LLM bereits effektiv arbeiten kann. Diese modulare Trennung ermöglicht es, die Rechenlast des Trainings auf einen minimalen Teil des Systems zu beschränken, während die Leistungsfähigkeit der großen Modelle vollständig erhalten bleibt.
Komponenten der DuplexJev-Architektur
Zusammenfassung der festen und trainierbaren Elemente des Systems.
| Komponente | Status | Funktion |
|---|---|---|
| ASR-Encoder | Eingefroren | Extrahiert versteckte Zustände aus dem Audiosignal |
| Konnektor (Fusion/Projector) | Trainierbar | Mappt Audio-Zustände in den Embedding-Raum des LLM |
| LLM (Qwen3-32B) | Eingefroren | Verarbeitet den Kontext und erzeugt Verteilungen über Optionen |
Single-Token-Überwachung und paralinguistisches Verständnis
Ein zentraler Befund des Preprints ist, dass die traditionelle Destillation von Transkripten verhindert, dass das LLM Merkmale des Sprechers (wie Geschlecht oder Emotion) lernt, da der 'Lehrer' der Destillation nur den Text sieht und nicht die Stimme hört. Durch die Überwachung nur des Antworttokens mit Kreuzentropie lernt das Modell, diese paralinguistischen Signale direkt aus dem Audio zu extrahieren.
Die Autoren berichten, dass mit dieser Technik die Genauigkeit bei der Identifizierung von Geschlecht und Emotion 90 % erreicht, ausgehend von einem Zufallsniveau (55 % bzw. 28 %), wenn nur Destillation verwendet wird. Dies zeigt, dass die Engstelle nicht im Konnektor liegt, sondern im Trainingsziel.
Der Verzicht auf die Destillation von Transkripten zugunsten der direkten Überwachung des Antworttokens ist ein entscheidender methodischer Bruch, der die Art und Weise, wie das Modell paralinguistische Informationen verarbeitet, grundlegend verändert. Da der Text die prosodischen und emotionalen Nuancen der Stimme nicht vollständig widerspiegelt, verliert das Modell bei der rein textbasierten Destillation den Zugang zu diesen kritischen Signalen. Durch die direkte Optimierung der Logits für die geschlossenen Optionen lernt das Modell, die relevanten akustischen Merkmale direkt aus den eingebetteten Audiozuständen zu extrahieren, die durch den Konnektor bereitgestellt werden. Dies führt zu einer tieferen Integration der paralinguistischen Analyse in die Entscheidungslogik des Systems, anstatt sie als nachgelagerte Textanalyse zu behandeln.
Ergebnisse zu Latenz und Rechenkapazität
In Tests auf einem 8-GPU-Knoten (H200) beantwortet das System 80 Entscheidungen über 8 Äußerungen in etwa 0,1 Sekunden. Im Vergleich dazu dauert ein Kaskadenansatz, der transkribiert und dann eine JSON-Antwort generiert, 1,57 Sekunden pro Ereignis, was einer Latenzreduzierung um den Faktor 17 entspricht.
Die Servicekapazität verbessert sich ebenfalls erheblich: Während der JSON-Ansatz keine Last innerhalb eines Budgets von 0,5 Sekunden bedienen kann, bedient die Single-Token-Lektüre zwischen 17 und 20 Ereignisse pro Sekunde auf einer einzigen GPU. Der Hauptvorteil liegt in der Latenz unter konversationellen Budgets, nicht unbedingt im rohen Durchsatz bei maximaler Sättigung.
Die signifikante Reduktion der Latenz von 1,57 Sekunden auf 92 Millisekunden pro Ereignis verdeutlicht den fundamentalen Unterschied zwischen der sequentiellen Generierung von Text und der parallelen Bewertung von Wahrscheinlichkeitsverteilungen. Während der Kaskadenansatz Zeit benötigt, um jedes Token der Antwort nacheinander zu erzeugen, berechnet das Single-Token-Verfahren die gesamte Antwort in einem einzigen Inferenz-Durchlauf. Diese Effizienzsteigerung ist besonders relevant für Szenarien, in denen die Reaktionszeit des Agenten direkt von der Geschwindigkeit dieser Mikro-Entscheidungen abhängt. Die Fähigkeit, eine hohe Anzahl von Ereignissen pro Sekunde innerhalb eines engen Zeitbudgets zu verarbeiten, ermöglicht es dem System, auch bei komplexen Dialogströmen flüssig und reaktiv zu bleiben, ohne dass die Nutzer spürbare Verzögerungen erleben.
Vergleich von Latenz und Kapazität (1 H200)
Durchschnittliche Zeit pro Ereignis und Ereignisse pro Sekunde innerhalb eines Budgets von 0,5 s.
| Methode | Durchschnittliche Latenz (ms) | Ereignisse/s (0,5 s) |
|---|---|---|
| JSON-Kaskade (ASR + LLM) | 1567 | 0 |
| Single-Token-Lektüre (DuplexJev) | 92 | 20,4 |
Einschränkungen und Status der Evidenz
Es ist entscheidend hervorzuheben, dass diese Ergebnisse aus einem Preprint (arXiv:2610.02638) stammen und weder peer-reviewed noch unabhängig repliziert wurden. Die Leistungszahlen, wie die 90-%-Genauigkeit in der Paralinguistik oder die 0,1-s-Latenz, sind Behauptungen der Autoren, basierend auf ihren eigenen Datensätzen und Hardware-Konfigurationen.
Obwohl die Autoren die Veröffentlichung von Gewichten, Trainingsrezepten und einem zweisprachigen Datensatz (qa100) ankündigen, wurde die tatsächliche Verfügbarkeit dieser Ressourcen nicht unabhängig verifiziert. Darüber hinaus konzentriert sich die Bewertung auf geschlossene Aufgaben und bewertet keine kontinuierliche Streaming-Eingabe, was die direkte Verallgemeinerung auf alle Produktions-Szenarien von Sprachagenten einschränkt.
Die Tatsache, dass die Bewertung auf geschlossenen Aufgaben und diskreten Entscheidungen basiert, bedeutet, dass die Robustheit des Systems gegenüber offenen, unstrukturierten Sprachströmen oder variablen Umgebungsbedingungen noch nicht vollständig belegt ist. Die gemessenen Latenzwerte und Genauigkeitsraten gelten spezifisch für die konfigurierten Testumgebungen und die verwendeten Datensätze. Bevor diese Architektur in produktiven Umgebungen mit unvorhersehbaren Nutzerinteraktionen und variablen Netzwerkbedingungen eingesetzt wird, ist eine umfassende Validierung unter realen Bedingungen erforderlich. Die angekündigte Offenlegung der Ressourcen ist ein wichtiger Schritt zur Transparenz, aber die unabhängige Replikation der Ergebnisse bleibt der entscheidende Faktor für die Bestätigung der praktischen Anwendbarkeit und Skalierbarkeit des vorgeschlagenen Ansatzes.
Offene Fragen
- Die tatsächliche Verfügbarkeit des von den Autoren angekündigten Codes, der Gewichte und des qa100-Datensatzes wurde nicht verifiziert.
- Die Latenz von 0,1 s für 80 Entscheidungen hängt von einem 8-GPU-H200-Knoten ab; die Leistung auf weniger leistungsfähiger Hardware oder in Streaming-Umgebungen wurde nicht bewertet.
- Die 90-%-Genauigkeit bei Geschlecht und Emotion wird in spezifischen Datensätzen (AISHELL-1, ESD, CREMA-D) gemessen und kann unter Rauschbedingungen oder mit Sprechern, die im Training nicht repräsentiert sind, variieren.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen