Il problema della latenza negli agenti vocali
Gli agenti vocali full-duplex devono prendere numerose decisioni piccole e chiuse mentre l'utente parla: determinare se il turno è completo, identificare un'interruzione (barge-in) o selezionare un riempitivo (filler) adeguato. Attualmente, questi sistemi rispondono generando testo in modo autoregressivo, un processo lento che blocca la risposta dell'agente fino al completamento della decodifica.
In un assistente vocale per auto analizzato nello studio, queste decisioni consumano il 30% di tutti i token di input del LLM. Questo carico non solo aumenta la latenza percepita dall'utente, ma richiede anche capacità di calcolo aggiuntiva per mantenere la fluidità durante le ore di punta, aumentando i costi operativi.
Architettura: connessione tra codificatore e LLM congelato
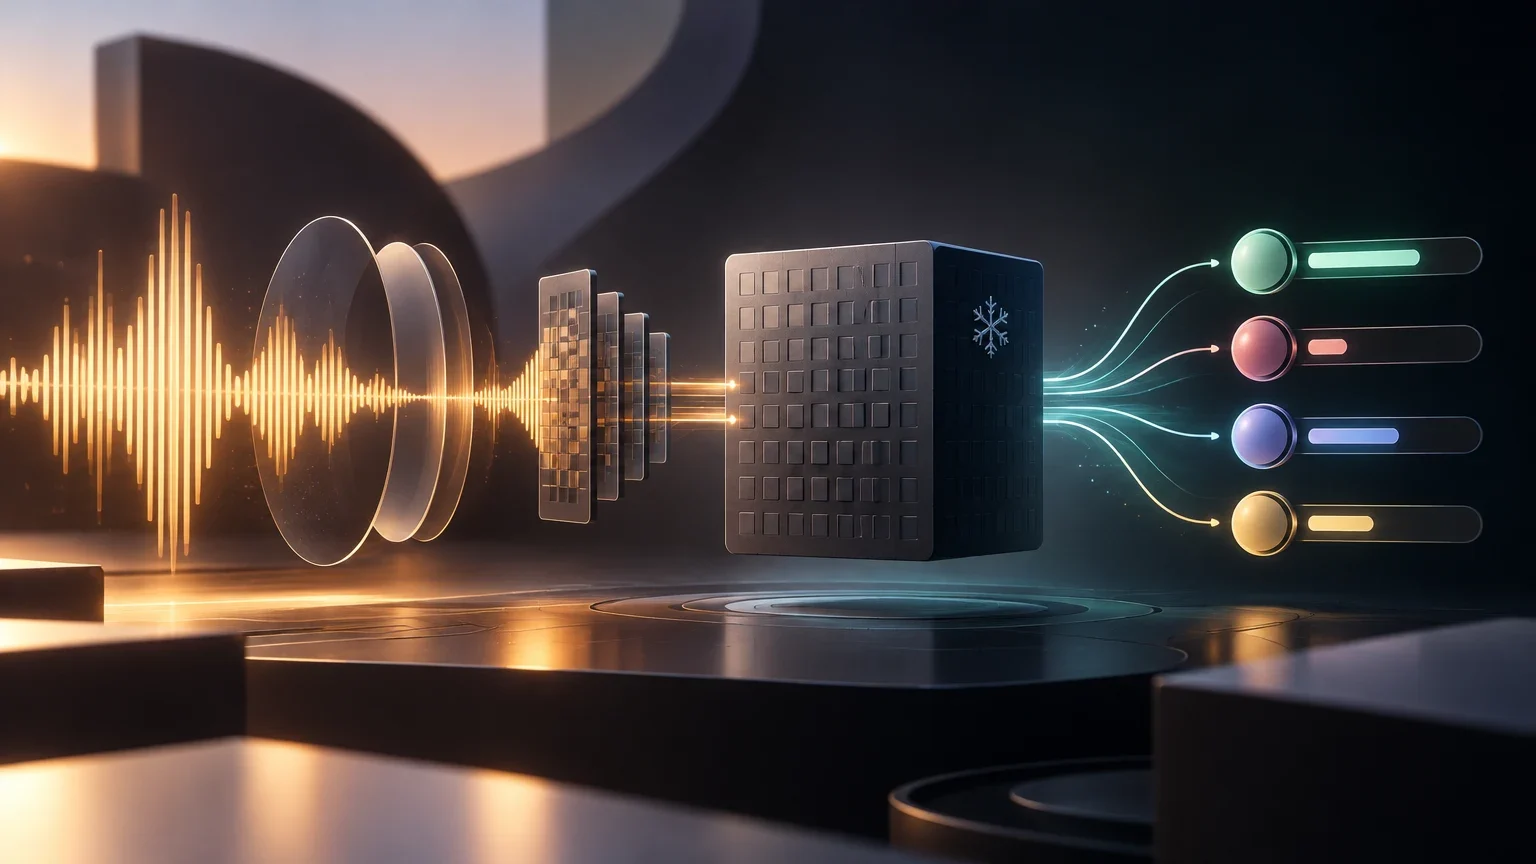
DuplexJev propone un'architettura modulare in cui un codificatore ASR (riconoscimento automatico della voce) e un LLM generalista rimangono congelati. Viene addestrato solo un connettore piccolo che trasforma gli stati nascosti del codificatore in embedding compatibili con lo spazio di embedding del LLM.
Invece di decodificare una risposta testuale completa, il sistema formula ogni domanda come una distribuzione di probabilità su un insieme chiuso di opzioni (rappresentate da lettere). Il LLM esegue un singolo passaggio di inferenza (forward pass) e la risposta viene estratta dai logit nella posizione del token di risposta, senza passi di campionamento o decodifica.
Componenti dell'architettura DuplexJev
Riepilogo degli elementi fissi e addestrabili del sistema.
| Componente | Stato | Funzione |
|---|---|---|
| Codificatore ASR | Congelato | Estrae stati nascosti dal segnale audio |
| Connettore (Fusion/Projector) | Addestrabile | Mappa gli stati audio nello spazio di embedding del LLM |
| LLM (Qwen3-32B) | Congelato | Elabora il contesto e genera distribuzioni sulle opzioni |
Supervisione di un singolo token e comprensione paralinguistica
Un risultato chiave del preprint è che la distillazione tradizionale delle trascrizioni impedisce al LLM di apprendere le caratteristiche del parlante (come genere o emozione), poiché l'insegnante della distillazione vede solo il testo e non ascolta la voce. Supervisionando solo il token di risposta con l'entropia incrociata, il modello impara a estrarre questi segnali paralinguistici direttamente dall'audio.
Gli autori riportano che, con questa tecnica, l'accuratezza nell'identificazione del genere e dell'emozione raggiunge il 90%, partendo da un livello casuale (55% e 28% rispettivamente) quando si usa solo la distillazione. Questo dimostra che il collo di bottiglia non sta nel connettore, ma nell'obiettivo di addestramento.
Risultati di latenza e capacità di calcolo
In test effettuati su un nodo da 8 GPU (H200), il sistema risponde a 80 decisioni su 8 enunciati in circa 0,1 secondi. In confronto, un approccio a cascata che trascrive e poi genera una risposta JSON impiega 1,57 secondi per evento, rappresentando una riduzione della latenza di 17 volte.
La capacità di servizio migliora anche significativamente: mentre l'approccio JSON non riesce a servire alcun carico entro un budget di 0,5 secondi, il metodo di lettura di un singolo token serve tra 17 e 20 eventi al secondo su una singola GPU. Il vantaggio principale risiede nella latenza entro budget conversazionali, non necessariamente nel throughput grezzo a massima saturazione.
Confronto di latenza e capacità (1 H200)
Tempo medio per evento ed eventi al secondo entro un budget di 0,5 s.
| Metodo | Latenza media (ms) | Eventi/s (0.5s) |
|---|---|---|
| Cascata JSON (ASR + LLM) | 1567 | 0 |
| Lettura di un singolo token (DuplexJev) | 92 | 20.4 |
Limitazioni e stato dell'evidenza
È fondamentale sottolineare che questi risultati provengono da un preprint (arXiv:2610.02638) e non sono stati sottoposti a revisione paritaria né replicati in modo indipendente. Le cifre di prestazioni, come l'accuratezza del 90% nella paralinguistica o la latenza di 0,1 s, sono affermazioni degli autori basate sui propri set di dati e configurazioni hardware.
Sebbene gli autori annuncino la pubblicazione di pesi, ricette di addestramento e un set di dati bilingue (qa100), la disponibilità effettiva di queste risorse non è stata verificata in modo indipendente. Inoltre, la valutazione si concentra su task chiusi e non valuta l'input in streaming continuo, limitando la generalizzazione diretta a tutti gli scenari di agenti vocali in produzione.
Questioni aperte
- Non è stata verificata la disponibilità effettiva del codice, dei pesi e del set di dati qa100 annunciati dagli autori.
- La latenza di 0,1 s per 80 decisioni dipende da un nodo da 8 GPU H200; le prestazioni su hardware meno potente o in ambienti di streaming non sono valutate.
- L'accuratezza del 90% per genere ed emozione è misurata su set specifici (AISHELL-1, ESD, CREMA-D) e può variare in condizioni di rumore o con parlanti non rappresentati nell'addestramento.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione