Ein Punktestand erzählt nicht die ganze Geschichte
Ein Agent kann in einem Benchmark eine Aufgabe bestehen. Das Ergebnis zeigt, dass das System nach dem angewandten Bewertungsverfahren Punkte erhalten hat. Es sagt aber nicht unbedingt, wie der Agent zu diesem Ergebnis kam, ob seine Behauptung, die Aufgabe abgeschlossen zu haben, stimmt oder ob er bei einer Wiederholung ähnlich abschneiden würde. Diese Lücke zwischen erhaltenen Punkten und nachprüfbar gezeigter Fähigkeit steht im Mittelpunkt von Trust Layer, einem in einem Preprint vorgestellten Rahmenwerk.
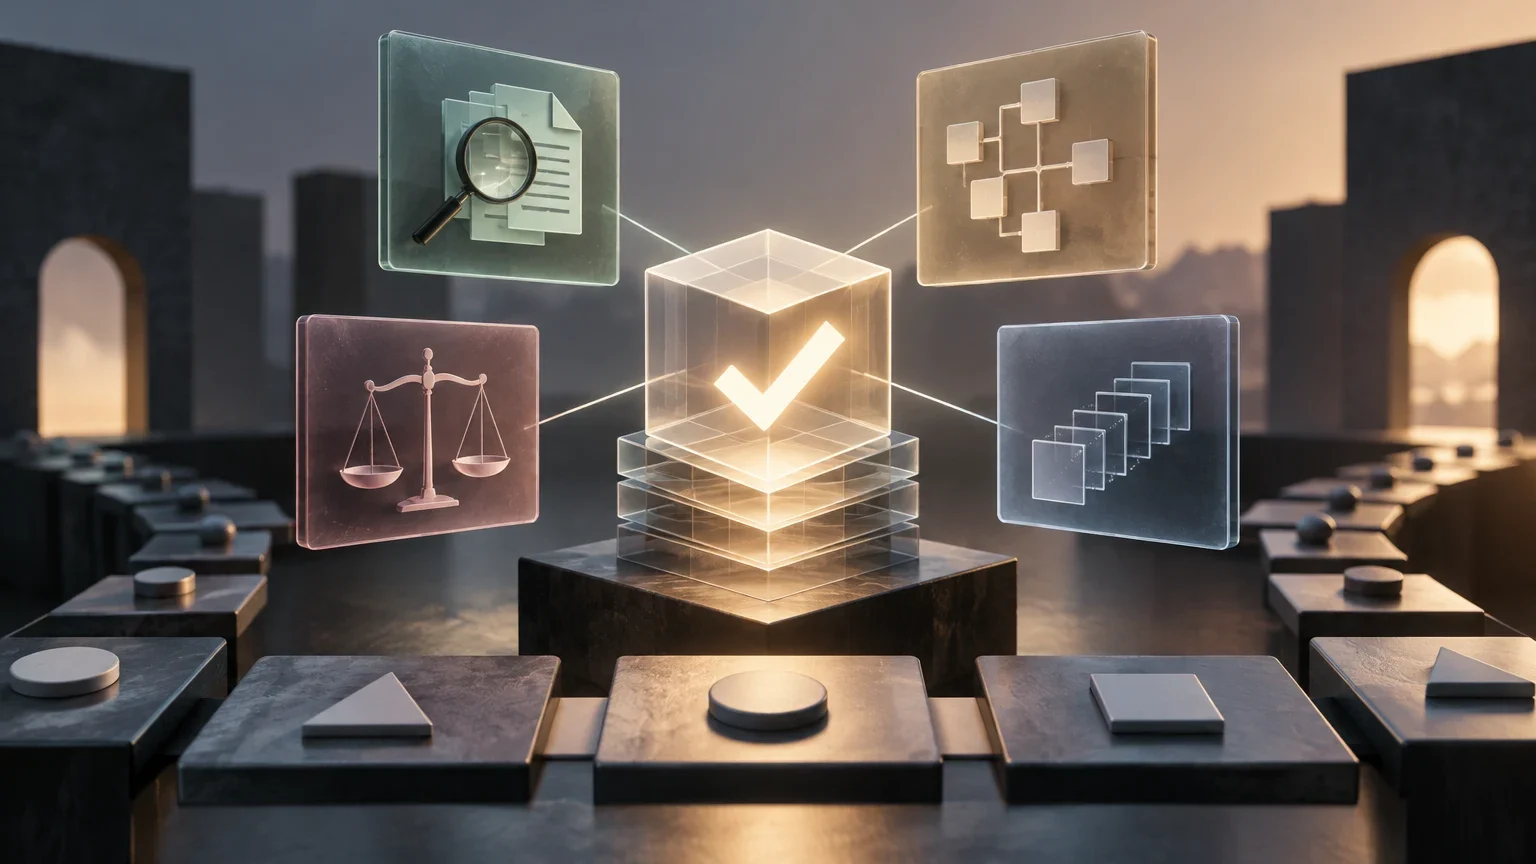
Der Vorschlag ersetzt den Punktestand nicht und soll ihn auch nicht verändern. Stattdessen ergänzt er die nachträgliche Auswertung um Prüfungen und weist aus, ob ein Ergebnis vier Vertrauensprüfungen besteht. So sollen zwei Fragen getrennt werden, die oft in einer einzigen Zahl zusammenfallen: Wie viele Punkte hat der Agent erzielt – und welche Belege sprechen dafür, dass diese Punkte tatsächliche, nachvollziehbare und reproduzierbare Leistung widerspiegeln?
Die Autorinnen und Autoren wenden den Rahmen auf fünf Agentenkonfigurationen und 108 Aufgaben aus Agents’ Last Exam an. Die berichteten Zahlen beziehen sich daher auf dieses konkrete Experiment. Sie sind keine allgemeine Schätzung zur Zuverlässigkeit aller Agenten, Modelle oder Benchmarks. Ebenso wenig belegen sie, dass Trust Layer bereits als Standard eingeführt oder unabhängig validiert wurde.
Vier unterschiedliche Fragen zu einem bestandenen Test
Die erste Prüfung fragt, ob das Ergebnis durch die Bewertungslogik des Benchmarks selbst gestützt wird. Es genügt nicht, nur die Endnote zu betrachten. Vielmehr wird geprüft, ob die gespeicherte Antwort die Bedingungen erfüllt, die der Bewertungsmechanismus anwenden sollte. Dabei geht es um den Zusammenhang zwischen Belegen und Bewertungskriterien – nicht darum, ob die Kriterien für sich genommen eine nützliche Fähigkeit in der realen Welt messen.
Die zweite Prüfung untersucht, ob eine bestandene Antwort durch einen nachvollziehbaren Rechen- oder Handlungsvorgang zustande kam. Sie soll unterscheiden, ob ein Ergebnis von überprüfbaren Schritten oder Belegen begleitet wird oder ob die Aufzeichnungen nicht ausreichen, um den Weg dorthin nachzuvollziehen. „Nicht nachvollziehbar“ bedeutet nicht automatisch „falsch“. Es bedeutet, dass sich der geforderte Prozess anhand der untersuchten Artefakte nicht verifizieren lässt.
Die dritte Prüfung vergleicht die Behauptung des Agenten, die Aufgabe abgeschlossen zu haben, mit dem tatsächlichen Ablauf. Ein System könnte beispielsweise melden, dass es eine Aufgabe erledigt hat, obwohl die gespeicherten Belege den erfolgreichen Abschluss nicht zeigen. Laut Zusammenfassung des Preprints wurden falsche Abschlussbehauptungen bestätigt. Eine konkrete Häufigkeit für diese Kategorie wird dort jedoch nicht angegeben; deshalb lässt sich dafür keine Rate nennen.
Die vierte Frage lautet, ob das Ergebnis bei einer erneuten Ausführung bestehen bleibt. Ein einzelner Durchlauf reicht nicht aus, um diese Stabilität zu messen. Im beschriebenen Experiment wurde der Agent erneut ausgeführt und die erreichten Punktestufen wurden verglichen. Ein einmaliges Bestehen und eine gleichbleibende Leistung sind somit unterschiedliche Hinweise.
Was die vier Eigenschaften prüfen
| Eigenschaft | Praktische Frage | Was sie allein nicht belegt |
|---|---|---|
| Unterstützung durch die Bewertungslogik | Erfüllt der vorliegende Beleg die Bewertungsregeln des Benchmarks? | Dass der Benchmark alle relevanten Fähigkeiten misst. |
| Nachvollziehbarkeit | Gibt es gespeicherte Belege dafür, wie eine bestandene Antwort zustande kam? | Dass jede nicht nachvollziehbare Antwort zwangsläufig falsch ist. |
| Wahrhaftigkeit der Abschlussmeldung | Stimmt die Erfolgsmeldung mit den Aufzeichnungen zum tatsächlichen Ablauf überein? | Die allgemeine Zuverlässigkeit des Agenten bei anderen Aufgaben. |
| Stabilität | Bleibt die erreichte Punktestufe bei wiederholter Ausführung erhalten? | Dass das Ergebnis unter beliebigen Konfigurationen gleich bleibt. |
Was sich anhand gespeicherter Aufzeichnungen prüfen lässt – und was eine Wiederholung erfordert
Der Beschreibung des Preprints zufolge stützen sich die ersten drei Prüfungen auf gespeicherte Artefakte. Praktisch setzt eine solche Prüfung voraus, dass relevante Aufzeichnungen vorhanden sind – etwa Antworten, Ergebnisse der Bewertung und Belege für ausgeführte Aktionen – und sich der jeweiligen Aufgabe zuordnen lassen. Aus der Zusammenfassung geht nicht hervor, welche konkreten Formate für jede Prüfung erforderlich sind oder welche Artefakte in den untersuchten Fällen fehlten.
Für die Stabilitätsprüfung ist ein anderer Schritt nötig: Der Agent muss erneut ausgeführt werden. In der Arbeit wurde die Stabilität anhand von fünf Durchläufen gemessen. Je nach untersuchter Konfiguration blieben 18 bis 46 Prozent der Aufgaben nicht in derselben Punktestufe. Diese Spanne zeigt Unterschiede zwischen den getesteten Konfigurationen. Sie ist keine Aussage darüber, welcher Anteil bei beliebigen Agenten oder Benchmarks betroffen wäre.
Das Rahmenwerk verbindet außerdem Modellurteile mit deterministischen Regeln. Modellurteile dienen dazu, Belege unter Verwendung einer Mehrheitsentscheidung zu kennzeichnen; die endgültigen Bewertungen folgen deterministischen Regeln. Diese Unterscheidung ist wichtig: Die Methode stellt die ergänzenden Modellurteile nicht für sich genommen als abschließenden Beweis dar. Außerdem sollen die Prüfungen den aufgezeichneten Punktestand nicht verändern.
So lässt sich eine Trust-Layer-Prüfung praktisch einordnen
- 01Den ursprünglichen Benchmark-Punktestand beibehalten und mit der bewerteten Aufgabe verknüpfen.
- 02Die Bewertungslogik prüfen und feststellen, ob die gespeicherte Antwort sie erfüllt.
- 03Untersuchen, ob die Artefakte den Ablauf nachvollziehbar machen und die Abschlussbehauptung stützen.
- 04Für eine Stabilitätsmessung den Agenten erneut ausführen und die erreichten Punktestufen vergleichen.
- 05Die Prüfungen zusammen mit der Bewertung darstellen, ohne sie mit einer neuen Punktzahl gleichzusetzen.
Auffällige Ergebnisse – aber begrenzt auf das untersuchte Experiment
In den fünf untersuchten Konfigurationen gab es laut Zusammenfassung bestandene Durchläufe ohne nachvollziehbare Berechnung. Die Häufigkeit unterschied sich zwischen den Modellen um bis zum Zehnfachen. Das weist auf deutliche Unterschiede innerhalb der untersuchten Gruppe hin, erklärt aber nicht von selbst, wodurch sie entstehen. Ebenso wenig lässt sich daraus ableiten, welche Konfiguration bei anderen Aufgaben zuverlässiger wäre.
Die Arbeit fand außerdem bestätigte Fälle falscher Abschlussbehauptungen und Schwankungen zwischen mehreren Durchläufen. Insgesamt bestanden nur 22,6 Prozent der aufgezeichneten bestandenen Ergebnisse alle vier Prüfungen. Das angegebene 95-Prozent-Konfidenzintervall reicht von 15,0 bis 32,6 Prozent; die Stichprobengröße beträgt n=84. Dieser Anteil bezieht sich auf die bestandenen Ergebnisse, die in die Berechnung eingingen, nicht auf alle denkbaren Ausführungen oder auf eine allgemeine Grundgesamtheit von Benchmarks.
Die passende Schlussfolgerung lautet nicht, dass Agenten nur einen bestimmten Anteil der Aufgaben erfolgreich erledigen können. Die Zahl beschreibt, welcher Anteil der bestandenen Ergebnisse im Experiment alle vier Prüfungen zugleich bestand. Scheitert ein Ergebnis an einer Prüfung, hängt die Interpretation davon ab, an welcher: Es kann Zweifel an der Bewertung geben, die Nachvollziehbarkeit kann fehlen, eine Erfolgsmeldung kann unbelegt sein oder das Ergebnis kann zwischen Wiederholungen schwanken.
Abgrenzung zu anderen Verfahren zur Bewertung von Agenten
Bei Tests von Agenten stehen häufig Fähigkeiten wie Planung, Ausführung von Aktionen, Werkzeugnutzung und Reaktionen des Systems im Mittelpunkt. Trust Layer soll diese Art der Bewertung nicht ersetzen. Der Vorschlag ergänzt sie um eine Prüfung der Belege, auf denen die vergebenen Punkte beruhen. Neben der Frage, ob ein Agent die erwartete Antwort erreicht hat, wird damit auch gefragt, ob sich das Ergebnis verifizieren lässt und bei Wiederholungen stabil bleibt.
Ein damit verbundenes, aber anderes Problem ist die Frage, ob ein Benchmark tatsächlich die Fähigkeit abbildet, die er messen soll. Eine unabhängige Arbeit zur Prüfung von Agenten-Benchmarks untersucht Aufzeichnungen aus 15 Benchmarks und analysiert, wann deren Punktestände Aussagen über Fähigkeiten stützen. Die Gültigkeit eines Benchmarks ist nicht dasselbe wie die Frage, ob ein konkretes Ergebnis nachvollziehbar war oder eine Abschlussbehauptung mit dem beobachteten Ablauf übereinstimmte. Beide Forschungsrichtungen können sich ergänzen, aber die eine belegt nicht automatisch die andere.
Auf Grundlage der verfügbaren Angaben lässt sich nicht behaupten, dass Trust Layer bestehenden Prüfverfahren überlegen ist oder die Qualität von Benchmarks verbessert. Die Zusammenfassung beschreibt die Prüfungen und die Ergebnisse einer Anwendung, aber keinen systematischen Vergleich mit anderen Methoden. Um einen möglichen Vorteil zu beurteilen, müssten Protokolle, Kriterien und Ergebnisse unter vergleichbaren Bedingungen gegenübergestellt werden.
Was noch fehlt, um den Nutzen außerhalb der Studie zu beurteilen
Der Vorschlag bietet eine strukturierte Möglichkeit, Punktestände um überprüfbare Fragen zu ergänzen. Aus den verfügbaren Angaben geht jedoch nicht hervor, ob der Code, die Artefakte oder die Daten veröffentlicht wurden, die für eine Reproduktion der Prüfungen nötig wären. Auch lässt sich nicht im Detail feststellen, welche praktischen Entscheidungen jede einzelne Regel erfordert. Ohne diese Materialien ist es für andere Teams schwierig zu prüfen, ob sie zu denselben Bewertungen kämen.
Die beschriebene Untersuchung umfasst fünf Konfigurationen, 108 Aufgaben aus einem Benchmark und fünf Ausführungen zur Messung der Stabilität. Anwendungen auf andere Aufgabentypen, Bewertungsverfahren und Agenten könnten zeigen, ob sich die Eigenschaften übertragen lassen und welche Rolle die Qualität der Aufzeichnungen spielt. Wichtig wäre auch zu untersuchen, was geschieht, wenn Artefakte fehlen oder die Bewertungslogik keine eindeutige Prüfung zulässt.
Vorerst ist Trust Layer als methodischer Vorschlag zu verstehen, der durch Ergebnisse einer konkreten Anwendung ergänzt wird – nicht als etablierte Norm oder als Garantie dafür, dass ein Punktestand wahr ist. Der zentrale Gedanke besteht darin, die vergebenen Punkte mit Belegen dazu zu versehen, wie sie zustande kamen, was während der Aufgabe geschah und ob das Ergebnis eine Wiederholung übersteht. Ob dieser Ansatz nützlich ist, hängt davon ab, ob er reproduziert und in weiteren Kontexten getestet werden kann.
Offene Fragen
- Anhand der verfügbaren Angaben lässt sich nicht bestätigen, ob vollständiger Code, Daten und Artefakte für eine Reproduktion zugänglich sind.
- Für falsche Abschlussbehauptungen wird keine konkrete Häufigkeit angegeben.
- Die Ergebnisse beruhen auf fünf Konfigurationen, 108 Aufgaben und fünf Durchläufen; eine Übertragbarkeit auf andere Benchmarks ist nicht belegt.
- Ein systematischer Vergleich des Rahmenwerks mit bestehenden Prüfverfahren ist nicht bestätigt.
- Die verfügbaren Angaben beschreiben die Zusammenfassung des Preprints und belegen keine unabhängige Validierung.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen