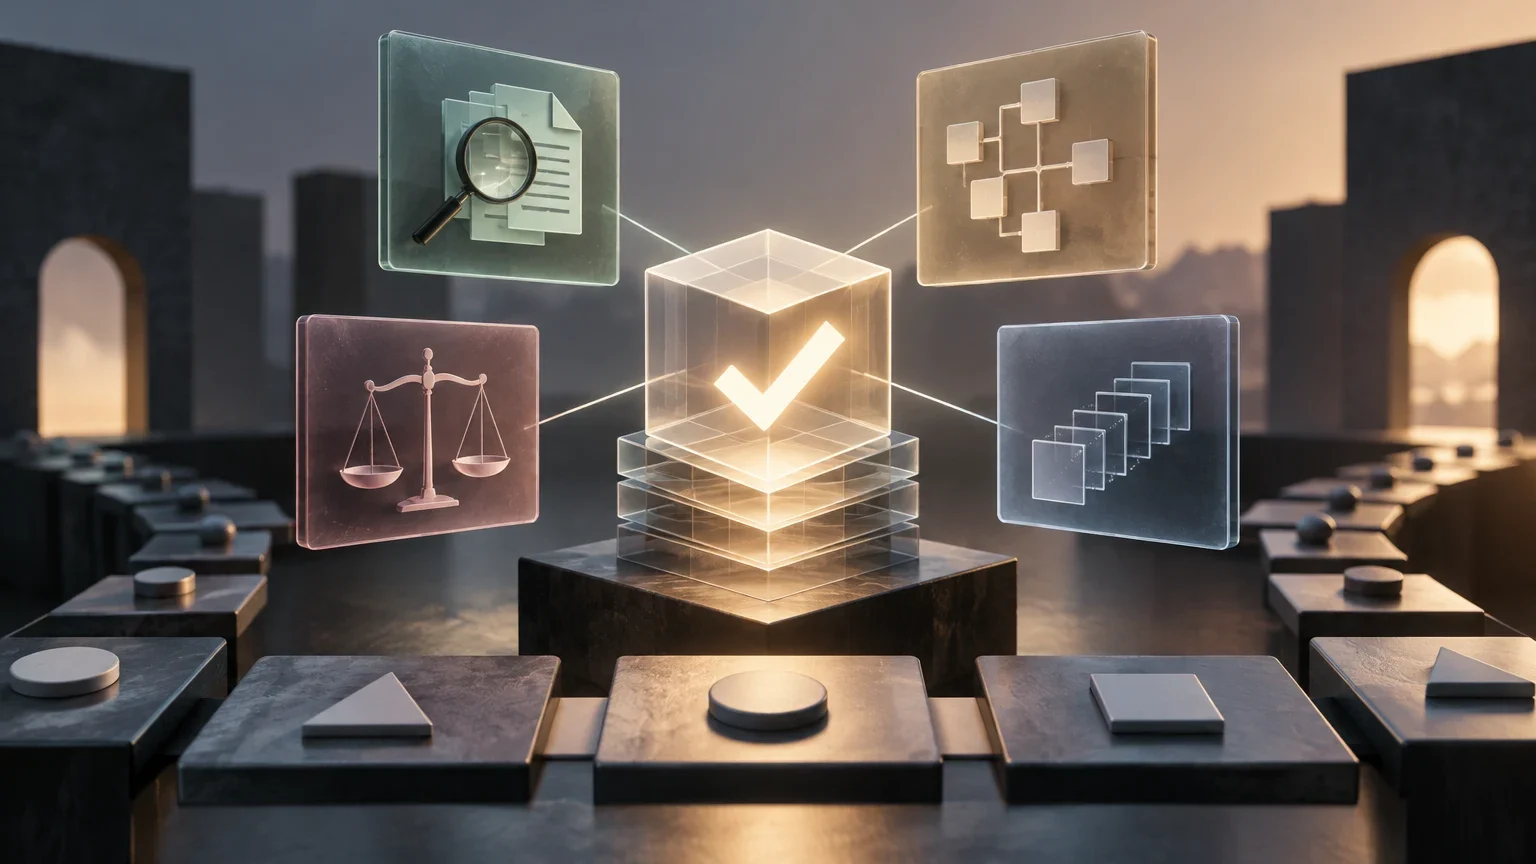
Un punteggio non racconta tutta la storia
Un agente può ottenere un punteggio sufficiente in un benchmark. Il risultato conferma che il sistema ha ricevuto credito secondo la procedura di valutazione adottata, ma non spiega necessariamente che cosa abbia fatto per ottenerlo, se la sua dichiarazione di aver completato il task sia veritiera o se il risultato si ripeterebbe in una nuova esecuzione. È questa differenza tra ricevere credito e dimostrare in modo verificabile una capacità che Trust Layer, un framework presentato in un preprint, si propone di affrontare.
La proposta non sostituisce il punteggio e non intende modificarlo. Aggiunge verifiche successive e comunica se il risultato supera quattro controlli di affidabilità. L’obiettivo è separare due domande che spesso confluiscono in un unico numero: quale punteggio ha ottenuto l’agente e quali prove permettono di credere che quel punteggio rappresenti una prestazione reale e riproducibile.
Il lavoro applica il framework a cinque configurazioni di agenti su 108 task di Agents’ Last Exam. I numeri descrivono quindi quello specifico esperimento: non vanno interpretati come una stima universale dell’affidabilità di tutti gli agenti, modelli o benchmark. Non dimostrano nemmeno che il framework sia stato adottato come standard o convalidato in modo indipendente.
Quattro domande diverse su un risultato sufficiente
La prima verifica chiede se il risultato è supportato dalla logica di valutazione del benchmark stesso. Non basta guardare il voto finale: occorre esaminare se la risposta registrata soddisfa le condizioni che il valutatore avrebbe dovuto applicare. La domanda riguarda il rapporto tra le prove e il criterio di punteggio, non se quel criterio misuri, da solo, una capacità utile nel mondo reale.
La seconda verifica mira a stabilire se una risposta giudicata sufficiente sia stata ottenuta attraverso un processo computazionale tracciabile. L’obiettivo è distinguere un risultato accompagnato da passaggi o prove verificabili da uno per il quale non è disponibile una documentazione sufficiente a ricostruire come sia stato raggiunto. «Non tracciabile» non significa automaticamente «errato»: indica che, sulla base degli artefatti esaminati, non è possibile verificare il processo richiesto.
La terza verifica confronta la dichiarazione di completamento dell’agente con quanto è effettivamente avvenuto. Per esempio, il sistema potrebbe affermare di aver portato a termine un task anche se le prove conservate non mostrano che l’azione sia stata completata. Il riepilogo del preprint segnala casi confermati di false dichiarazioni di completamento, ma non fornisce una percentuale specifica per questa categoria; non è quindi corretto attribuirle una frequenza.
La quarta domanda riguarda la tenuta del risultato quando l’agente viene eseguito di nuovo. Una sola esecuzione non consente di misurare questa stabilità. Nell’esperimento descritto, il controllo richiede di ripetere l’esecuzione e confrontare i punteggi ottenuti. Un singolo risultato sufficiente e una prestazione costante sono dunque segnali diversi.
Che cosa verifica ciascuna proprietà
| Proprietà | Domanda pratica | Che cosa non dimostra da sola |
|---|---|---|
| Supporto del valutatore | Le prove soddisfano la logica di punteggio del benchmark? | Che il benchmark misuri tutte le capacità rilevanti. |
| Tracciabilità | Sono conservate prove di come è stata ottenuta una risposta sufficiente? | Che ogni risposta non tracciabile sia necessariamente errata. |
| Veridicità del completamento | La dichiarazione di successo corrisponde a quanto mostrano i registri? | L’affidabilità generale dell’agente su altri task. |
| Stabilità | Il livello di punteggio si mantiene ripetendo l’esecuzione? | Che il risultato si mantenga con qualsiasi configurazione. |
Che cosa si può verificare nei registri e che cosa richiede una nuova prova
Secondo la descrizione del preprint, le prime tre proprietà vengono valutate usando artefatti conservati. In pratica, l’audit dipende dalla disponibilità di registri pertinenti — per esempio risposte, risultati del valutatore e prove delle azioni — e dalla possibilità di collegarli al task. Il riepilogo non permette di precisare quali formati siano richiesti per ciascun controllo né quali artefatti mancassero nei casi esaminati.
Per verificare la stabilità serve invece eseguire nuovamente l’agente. Il lavoro ha misurato questa proprietà con cinque esecuzioni e riporta che, a seconda della configurazione valutata, tra il 18% e il 46% dei task non è rimasto nella stessa fascia di punteggio. L’intervallo segnala differenze tra le configurazioni studiate: non significa che la stessa proporzione valga per qualsiasi agente o benchmark.
Il framework combina inoltre giudizi di modelli e regole deterministiche. I giudizi dei modelli vengono usati per etichettare le prove con una votazione a maggioranza, mentre i verdetti finali seguono regole deterministiche. La distinzione è importante: il metodo non presenta i giudizi ausiliari, da soli, come prove conclusive e dichiara che i controlli non modificano il punteggio registrato.
Come leggere in pratica un audit Trust Layer
- 01Conservare il punteggio originale del benchmark e collegarlo al task valutato.
- 02Esaminare la logica di valutazione e verificare se la risposta registrata la soddisfa.
- 03Controllare se gli artefatti consentono di ricostruire il processo e confrontare la dichiarazione di completamento con le prove.
- 04Se si vuole misurare la stabilità, ripetere l’esecuzione e confrontare le fasce di punteggio.
- 05Presentare i controlli insieme al voto, senza confonderli con un nuovo punteggio.
Risultati rilevanti, ma circoscritti all’esperimento
Nelle cinque configurazioni analizzate, il riepilogo segnala esecuzioni giudicate sufficienti senza calcolo tracciabile. La frequenza variava fino a dieci volte tra i modelli. Il dato indica differenze importanti all’interno del campione studiato, ma non spiega da solo perché si verifichino e non consente di concludere quale configurazione sarebbe più affidabile su task diversi.
Il lavoro ha inoltre rilevato casi confermati di false dichiarazioni di completamento e variazioni tra le esecuzioni. Nel complesso, soltanto il 22,6% dei risultati sufficienti registrati ha superato tutte e quattro le verifiche. L’intervallo di confidenza al 95% riportato va dal 15,0% al 32,6%, con n=84. Il dato si riferisce ai risultati sufficienti inclusi nel calcolo, non a tutte le esecuzioni possibili né a una popolazione generale di benchmark.
L’interpretazione corretta non è che gli agenti siano in grado di svolgere correttamente solo una determinata frazione dei task. Il risultato descrive quanti dei risultati sufficienti dell’esperimento hanno superato contemporaneamente i quattro controlli. Se un controllo non viene superato, la conclusione dipende da quale: possono esserci dubbi sul valutatore, mancare la tracciabilità, la dichiarazione di successo può non essere supportata o il risultato può variare tra le ripetizioni.
In che cosa si distingue dagli altri metodi di valutazione degli agenti
I test sugli agenti prendono spesso in esame aspetti quali pianificazione, azioni, uso degli strumenti e risposte del sistema. Trust Layer non elimina questo tipo di valutazione: propone di aggiungere un esame delle prove che giustificano il credito assegnato. Invece di chiedere soltanto se l’agente ha raggiunto la risposta attesa, chiede anche se il risultato è verificabile e se si ripete con stabilità.
Esiste inoltre un problema correlato, ma distinto: stabilire se un benchmark rappresenti davvero la capacità che dichiara di misurare. Un lavoro indipendente sull’audit dei benchmark per agenti analizza le tracce in 15 benchmark e studia quando i punteggi supportano affermazioni sulle capacità. La validità del benchmark non coincide con la verifica della tracciabilità di un singolo risultato o del fatto che una dichiarazione di completamento corrisponda a quanto accaduto. Le due linee di lavoro possono integrarsi, ma l’una non dimostra automaticamente l’altra.
Le informazioni disponibili non permettono di affermare che Trust Layer sia migliore dei metodi di audit esistenti o che migliori la qualità dei benchmark. Il riepilogo descrive i controlli e i risultati di un’applicazione, ma non presenta un confronto sistematico con altri metodi. Per stabilire se offra un vantaggio sarebbe necessario confrontare protocolli, criteri e risultati in condizioni equivalenti.
Che cosa manca per valutarne l’utilità al di fuori dello studio
La proposta offre un modo strutturato per accompagnare un punteggio con domande verificabili, ma le informazioni disponibili non consentono di confermare se siano stati pubblicati il codice, gli artefatti o i dati necessari per riprodurre i controlli. Non permettono neppure di determinare nel dettaglio quali decisioni operative richieda ciascuna regola. Senza questi elementi, per altri gruppi è difficile verificare se otterrebbero gli stessi verdetti.
La valutazione descritta riguarda cinque configurazioni, 108 task di un benchmark e cinque esecuzioni per misurare la stabilità. Applicare il framework ad altri tipi di task, valutatori e agenti aiuterebbe a capire se le proprietà si mantengono e in che modo incidano le differenze nella qualità dei registri. Sarebbe inoltre importante studiare che cosa succede quando mancano artefatti o quando la logica di valutazione non consente una verifica univoca.
Per ora, Trust Layer va considerato una proposta metodologica accompagnata dai risultati di un’applicazione specifica, non una norma consolidata né una garanzia della correttezza di un punteggio. Il suo contributo centrale consiste nel chiedere che al credito ottenuto in un benchmark siano affiancate prove su come è stato assegnato, su ciò che è accaduto durante il task e sulla tenuta del risultato quando la prova viene ripetuta. L’utilità dell’approccio dipenderà dalla possibilità di riprodurlo e sperimentarlo in altri contesti.
Questioni aperte
- Con le informazioni fornite non è possibile confermare se codice, dati e artefatti completi siano disponibili per riprodurre l’analisi.
- Non viene indicata una percentuale specifica di false dichiarazioni di completamento.
- I risultati riguardano cinque configurazioni, 108 task e cinque esecuzioni; non è stato dimostrato che si generalizzino ad altri benchmark.
- Non è confermato un confronto sistematico tra il framework e i metodi di audit esistenti.
- Le informazioni disponibili descrivono il riepilogo del preprint e non attestano una convalida indipendente.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione