Definition in einem Satz
Diseño sistemático de instrucciones, datos, herramientas, memoria y estado que se entregan al modelo en cada paso.
Definition: Informationen für eine Aufgabe gestalten
Kontext-Engineering bezeichnet die Gestaltung und Verwaltung der Informationen, die einem KI-Modell während eines Ausführungsschritts zur Verfügung gestellt werden, damit es eine konkrete Aufgabe bearbeiten kann. Dazu können Anweisungen, die Nachricht der Nutzerin oder des Nutzers, Teile des Gesprächsverlaufs, Beispiele, Werkzeugergebnisse, abgerufene Dokumente und Angaben zum aktuellen Arbeitsstand gehören. Die zentrale Frage lautet nicht nur, was man dem Modell sagen sollte, sondern auch, welche Informationen in welcher Form und zu welchem Zeitpunkt einfließen sollen – und welchen Grenzen sie unterliegen.
Der Begriff wird in einem sich entwickelnden Feld verwendet; eine formale Definition, die über alle Disziplinen und Anbieter hinweg allgemein anerkannt wäre, gibt es nicht. Sinnvoller ist es, ihn als praktische Bezeichnung für eine Reihe beobachtbarer technischer Entscheidungen zu verstehen: Informationen zusammenzutragen, relevante Teile auszuwählen, sie für die Aufgabe aufzubereiten und sie zu aktualisieren, wenn sich Ergebnisse oder Systemzustand ändern. Der Begriff allein garantiert weder eine bestimmte Methode noch eine Leistungsverbesserung.
In einem einfachen Gespräch besteht der Kontext möglicherweise vor allem aus Anweisungen und Nachrichten. Eine Anwendung mit Dokumentenabruf oder Werkzeugen kann zusätzlich externe Ergebnisse einbeziehen. Bei einem Agenten, der in mehreren Schritten arbeitet, lassen sich Informationen außerhalb des Gesprächs speichern und bei Bedarf wieder einfügen. Entscheidend ist in jedem Fall, welche Inhalte dem Modell bei der jeweiligen Ausführung tatsächlich vorliegen.
Was zum Kontext gehören kann
Anweisungen legen die Rolle, Einschränkungen oder das gewünschte Format fest. Die Nachricht der Nutzerin oder des Nutzers enthält das unmittelbare Anliegen. Der Gesprächsverlauf kann auf frühere Entscheidungen verweisen, sofern diese weiterhin relevant sind. Beispiele veranschaulichen Antwort- oder Lösungsmuster; wie nützlich sie sind, hängt jedoch davon ab, ob sie zur aktuellen Aufgabe passen.
Abgerufene Dokumente und Werkzeugergebnisse liefern Informationen, die nicht in der ursprünglichen Nachricht enthalten waren. Ein Werkzeug kann beispielsweise den Inhalt einer Datei oder das Ergebnis einer Suche zurückgeben. Der Arbeitsstand kann festhalten, was bereits erledigt wurde, was noch offen ist und welches Ergebnis für den nächsten Schritt bewahrt werden sollte. Diese Elemente müssen nicht immer vorhanden sein: Unnötige Inhalte belegen ebenfalls Platz und können zusätzliches Rauschen erzeugen.
Der Kontext ist nicht zwangsläufig ein einzelner Text, den eine Person von Hand verfasst. Eine Anwendung kann vor jedem Modellaufruf mehrere Informationsquellen zusammenführen. Ein Teil stammt möglicherweise aus einer Anfrage, ein anderer aus einer Datenquelle, einer Suche, dem Gesprächsverlauf oder einem vorherigen Arbeitsschritt. Wer nur den für Nutzende sichtbaren Prompt betrachtet, kann deshalb unter Umständen nicht erkennen, welche Informationen das Modell tatsächlich erhalten hat.
Häufige Bestandteile und Prüffragen
| Bestandteil | Möglicher Zweck | Prüffrage |
|---|---|---|
| Anweisungen | Aufgabe, Einschränkungen und Ausgabeformat festlegen. | Sind sie klar und widerspruchsfrei? |
| Gesprächsverlauf und Arbeitsstand | Kontinuität zwischen Gesprächsrunden oder Arbeitsschritten ermöglichen. | Welche Teile sind noch erforderlich und aktuell? |
| Dokumente und Werkzeugergebnisse | Daten für eine Antwort oder Handlung bereitstellen. | Sind sie für diese Aufgabe relevant, zuverlässig und ausreichend? |
| Beispiele | Ein Antwort- oder Arbeitsmuster veranschaulichen. | Passen sie zum aktuellen Fall, ohne zu einer ungeeigneten Nachahmung zu führen? |
Der Kontext-Engineering-Zyklus
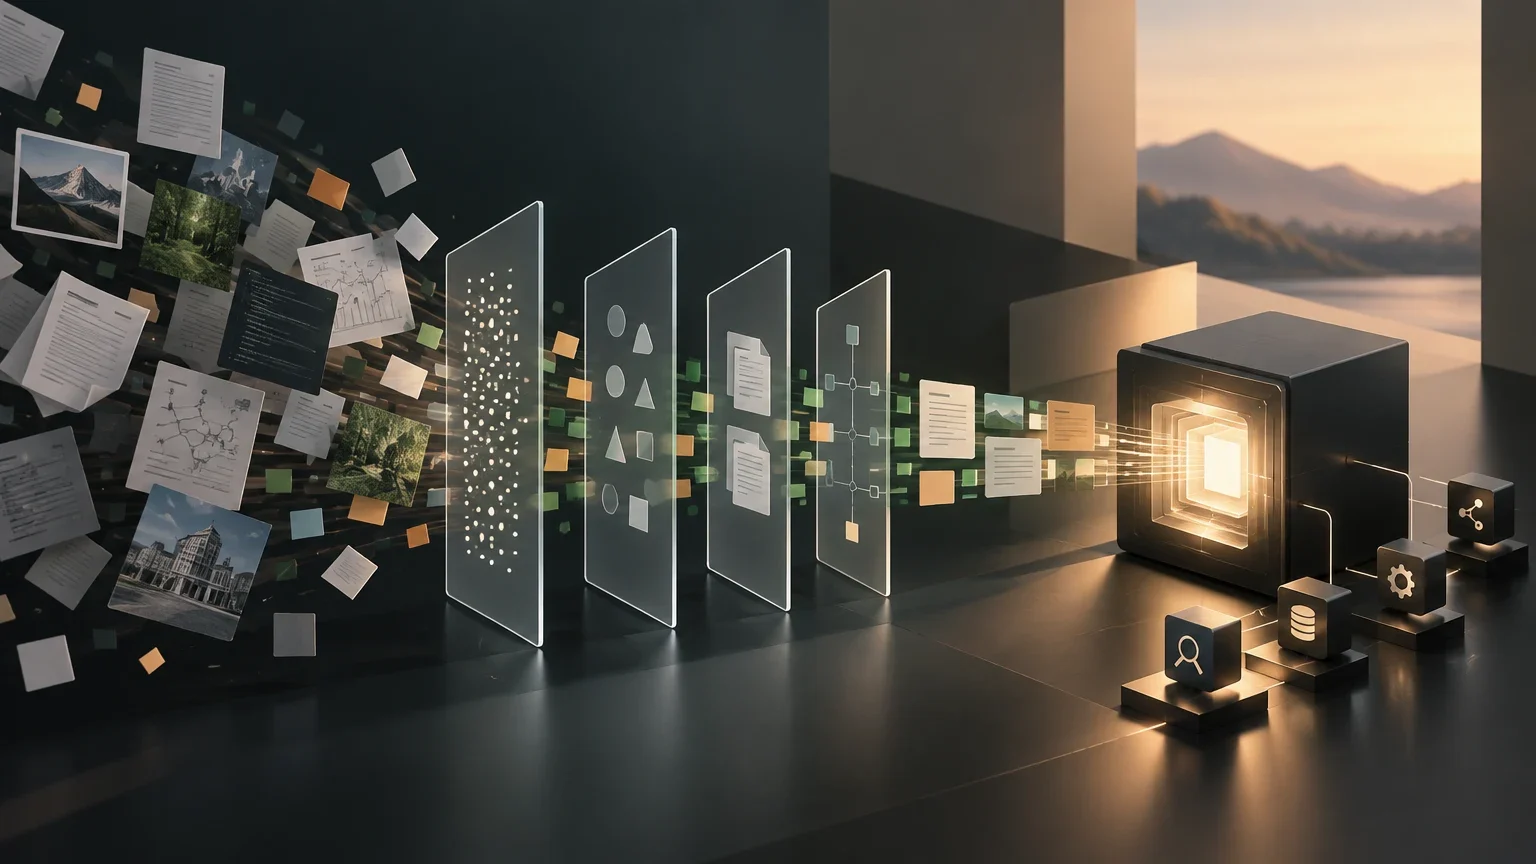
Eine Kontextstrategie lässt sich als Zyklus beschreiben. Zunächst wird ermittelt, was die Aufgabe erfordert – etwa eine Frage zu beantworten, eine Datei zu ändern oder Quellen miteinander zu vergleichen. Anschließend werden potenzielle Informationen aus der Nachricht, dem Gesprächsverlauf, Dokumenten, Werkzeugen oder einem externen Gedächtnis beschafft. Daten zu finden bedeutet nicht, dass sie alle in den Kontext gehören: Relevante Inhalte müssen ausgewählt, auf ihre Aktualität geprüft und nicht hilfreiche Inhalte ausgeschlossen werden.
Danach werden die ausgewählten Informationen geordnet und gegebenenfalls umgeformt. Es kann nötig sein, Textstellen herauszulösen, Ergebnisse zusammenzufassen, belegte Aussagen von offenen Fragen zu trennen oder den Arbeitsstand zu strukturieren. Anschließend werden die ausgewählten Inhalte in den Kontext aufgenommen, den das Modell erhält. Nach einer Antwort oder Handlung kann das System das Ergebnis prüfen und den Arbeitsstand aktualisieren: einen nützlichen Befund bewahren, veraltete Angaben ersetzen oder nach noch fehlenden Informationen suchen.
Wenn die Aufgabe weiterläuft, wiederholt sich der Prozess. Welche Strategie passt, hängt von der Aufgabe, den Quellen und den Fähigkeiten des Systems ab; ein Rezept, das ein korrektes Ergebnis garantiert, gibt es nicht. Eine schlechte Auswahl kann entscheidende Informationen auslassen. Eine zu umfangreiche Auswahl kann es dem Modell erschweren, das Wesentliche zu finden. Daher sollte der Zyklus an konkreten Anforderungen ausgerichtet und seine Wirkung beobachtet werden.
Ein grundlegender Zyklus
- 01Ermitteln, was die Aufgabe erfordert und welches Ergebnis erwartet wird.
- 02Mögliche Informationen aus der Nachricht, dem Gesprächsverlauf, Dokumenten oder Werkzeugen beschaffen.
- 03Relevante Inhalte auswählen, ordnen und aufbereiten.
- 04Die ausgewählten Informationen in den verfügbaren Modellkontext aufnehmen.
- 05Antwort oder Handlung prüfen und den Arbeitsstand für den nächsten Schritt aktualisieren.
Anwendungsbeispiel: Programmieragent
Angenommen, jemand bittet darum, einen Fehler in einer Anwendung zu beheben. Es kann unnötig sein, dafür auf einmal sämtliche Projektdateien zu laden. Eine gezieltere Strategie beginnt damit, die Fehlermeldung zu untersuchen und die wahrscheinlich betroffenen Komponenten zu finden. Das System kann Dateien, Tests und Dokumentation mithilfe von Werkzeugen durchsuchen und dem Modell die passenden Ausschnitte zusammen mit den Einschränkungen der gewünschten Änderung bereitstellen.
Nach einer Änderung können Testergebnisse oder Werkzeugausgaben zum Kontext des nächsten Schritts werden. Muss die Arbeit in einer späteren Phase fortgesetzt werden, kann eine Statusnotiz das Ziel, getroffene Entscheidungen, geänderte Dateien und offene Aufgaben zusammenfassen. Diese Notiz ist eine unvollständige Darstellung der Arbeit, kein vollständiges Protokoll und keine Garantie dafür, dass kein wichtiges Detail verloren ging.
Das Beispiel zeigt, dass Kontextverwaltung sowohl bedarfsgesteuerte Abfragen als auch den Erhalt von Informationen zwischen Arbeitsschritten umfassen kann. Beschriebene Systeme für länger laufende Agenten nutzen Übergaben und extern gespeicherte Zustände, um weiterzuarbeiten, wenn ein einzelnes Kontextfenster nicht ausreicht. Wie solche Mechanismen konkret umgesetzt werden, hängt vom jeweiligen Agenten ab.
Anwendungsbeispiel: Kundenservice
Bei einem Kundenservice-Assistenten könnte die Frage einer Person mit der für den Fall geltenden aktuellen Richtlinie und einem relevanten Teil des autorisierten Gesprächsverlaufs kombiniert werden. Geht es beispielsweise um den Status einer Rücksendung, benötigt das System möglicherweise die aktuelle Anfrage, die einschlägige Regel und die Bestellangabe, die zur Zuordnung des Vorgangs erforderlich ist. Das Beispiel dient der Veranschaulichung: Die verfügbaren Quellen dokumentieren kein konkretes Kundenservicesystem mit genau dieser Konfiguration.
Die Auswahl sollte den Zugriff zugleich auf das Notwendige beschränken. Wenn eine personenbezogene Angabe bei der Bearbeitung nicht hilft, gibt es keinen Grund, sie standardmäßig in den Kontext aufzunehmen. Die Anwendung muss festlegen, welche Informationen abgerufen werden dürfen, wer Zugriff darauf hat und wie lange sie gespeichert werden. Datenschutz- und Autorisierungsentscheidungen gehören zum Systemdesign; sie lassen sich nicht dadurch lösen, dass man dem Modell einfach weitere Anweisungen gibt.
Der Assistent sollte außerdem zwischen einer aktuellen Richtlinie und früheren Nachrichten unterscheiden, die möglicherweise nicht mehr gültig sind. Hängt eine Antwort von einer geltenden Regelung ab, muss sich die abgerufene Information mit einer autorisierten Quelle abgleichen lassen. Dass ein Dokument im Kontext auftaucht, beweist für sich genommen weder, dass es korrekt oder aktuell ist, noch, dass es auf den konkreten Fall zutrifft.
Anwendungsbeispiel: Recherche-Agent
Ein Recherche-Agent kann eine komplexe Frage in mehrere Arbeitsstränge aufteilen und die jeweils gesammelten Materialien getrennt verwalten. Statt bei jedem Schritt sämtliche Dokumente einem einzigen Modell vorzulegen, kann er Quellen und Erkenntnisse thematisch ordnen und dem koordinierenden Agenten eine Zusammenfassung mit Verweisen auf relevante Materialien und noch offenen Fragen übergeben.
Eine Zusammenfassung erleichtert die Übergabe zwischen Arbeitsphasen, kann aber Nuancen oder Einschränkungen auslassen. Deshalb sollte der Arbeitsstand unterscheiden, was in den Quellen beobachtet wurde, was eine Schlussfolgerung ist und was noch geprüft werden muss. Hängt eine Schlussfolgerung von einem bestimmten Detail ab, kann es notwendig sein, das ursprüngliche Dokument erneut heranzuziehen, statt sich allein auf eine Zusammenfassung zu verlassen.
Ein von Anthropic beschriebenes Multi-Agenten-Recherchesystem ist ein Beispiel dafür, wie Agenten mit getrennten Kontexten arbeiten und ihre Erkenntnisse für einen koordinierenden Agenten zusammenfassen können. Es handelt sich um einen konkreten Anwendungsfall; daraus folgt nicht, dass dieselbe Architektur für jede Recherche besser geeignet ist.
Verwandte Begriffe: Prompt, RAG, Chunking, Gedächtnis und Kontextfenster
Prompt Engineering beschäftigt sich hauptsächlich damit, Anweisungen zu formulieren und zu ordnen, um die Antwort eines Modells zu lenken. Kontext-Engineering hat einen breiteren Umfang: Es berücksichtigt auch, wie die übrigen verfügbaren Informationen zusammengetragen, ausgewählt, geordnet und aktualisiert werden. Beide Praktiken können sich überschneiden. Eine gute Anweisung ist Teil des Kontexts, beantwortet aber nicht von selbst die Frage, welche Dokumente abgerufen oder welche Zustandsinformationen bewahrt werden sollen.
Retrieval-Augmented Generation, kurz RAG, verbindet Informationsabruf mit Generierung. RAG kann eine Möglichkeit sein, Dokumente für den Kontext zu beschaffen, ist aber kein Synonym für Kontext-Engineering. Auch ein RAG-System muss entscheiden, was abgerufen wird, welche Textstellen einfließen und wie mit den Ergebnissen umzugehen ist. Umgekehrt lässt sich Kontext auch ohne ein RAG-System verwalten.
Chunking bezeichnet das Aufteilen von Dokumenten oder anderen Materialien in Einheiten, die gespeichert, abgerufen oder verarbeitet werden können. Es beeinflusst, welche Teile ein Modell erreichen können, entscheidet aber allein weder über deren Relevanz noch darüber, wie sie mit Anweisungen und Gesprächsverlauf kombiniert werden. Mit „Gedächtnis“ sind Mechanismen gemeint, die Informationen zwischen Zeitpunkten oder Aufgaben speichern und wieder abrufen. Vor dem Einfügen abgerufener Erinnerungen in den aktuellen Kontext muss das System prüfen, ob sie noch relevant sind.
Das Kontextfenster bezeichnet die Informationsmenge, die ein Modell bei einer Ausführung verarbeiten kann, abhängig von den Eigenschaften des jeweiligen Systems. Es ist keine Strategie zur Auswahl von Inhalten: Ein großes Fenster sagt nicht, was hineingehört, und garantiert nicht, dass jedes Element gleich viel Aufmerksamkeit erhält. Ein Cache kann Inhalte oder Verarbeitungsergebnisse wiederverwenden und so wiederholte Arbeit reduzieren. Auch das ist nicht dasselbe wie zu entscheiden, welche Informationen für eine konkrete Aufgabe benötigt werden.
Begriffe voneinander abgrenzen
| Begriff | Zentrale Frage | Bezug zum Kontext-Engineering |
|---|---|---|
| Prompt Engineering | Wie lassen sich Anweisungen formulieren? | Es ist ein Teil der Kontextgestaltung, nicht der gesamte Prozess. |
| RAG | Wie lassen sich Informationen für die Generierung abrufen? | Es kann Dokumente beisteuern; deren Auswahl und Einbindung müssen dennoch gesteuert werden. |
| Chunking | Wie lassen sich Materialien in Einheiten aufteilen? | Es beeinflusst, was abgerufen werden kann, entscheidet aber nicht allein darüber, was einbezogen werden sollte. |
| Gedächtnis | Welche Informationen sollen zwischen Zeitpunkten gespeichert und abgerufen werden? | Es kann Zustandsinformationen liefern, die vor der Aufnahme in den aktuellen Kontext geprüft werden müssen. |
| Kontextfenster | Wie viele Informationen kann eine Ausführung verarbeiten? | Es setzt eine Grenze, aber keine Auswahlregel. |
Häufige Irrtümer und Grenzen
Ein häufiger Irrtum ist die Annahme, mehr Kontext helfe immer. Experimente mit Modellen und langen Kontexten haben gezeigt, dass die Fähigkeit, Informationen zu nutzen, davon abhängen kann, an welcher Stelle sich der relevante Beleg befindet. Mehr Text oder ein größeres Kontextfenster garantieren daher nicht, dass das Modell die benötigte Information besser erkennt oder verwendet.
Ein weiterer Fehler besteht darin, verfügbare Informationen mit tatsächlich verwendeten Informationen gleichzusetzen. Dass ein Dokument eingebunden wurde, beweist nicht, dass es die Antwort korrekt beeinflusst hat. Ebenso bewahrt eine Zusammenfassung nicht zwangsläufig alle Nuancen des Originals. Beim Verdichten können Bedingungen, Ausnahmen oder Meinungsverschiedenheiten verloren gehen. Entscheidende Einzelheiten sollten sich deshalb anhand der Quelle überprüfen lassen.
Abgerufenes Material kann zudem unvollständig, irrelevant oder veraltet sein. Dokumente und Webseiten können auch bösartige Anweisungen enthalten, die sich an den Agenten richten. Behandelt das System solche Inhalte als vertrauenswürdige Anweisungen, kann es von seiner Aufgabe abgebracht werden. Prompt Injection ist ein Risiko, das entsteht, wenn nicht vertrauenswürdige Inhalte in den Kontext gelangen. Schutzmaßnahmen müssen geprüft werden; ihre bloße Existenz belegt nicht, dass sie wirksam sind.
Die Kontextauswahl bringt außerdem Abwägungen bei Kosten, Latenz und Datenschutz mit sich. Mehr Informationen abzurufen oder zu verarbeiten kann zusätzlichen Aufwand verursachen. Nicht benötigte Daten weiterzugeben, vergrößert unnötig deren Offenlegung. Eine universell richtige Kontextmenge gibt es nicht: Sie hängt von der Aufgabe, der Qualität der Quellen, den Systembeschränkungen und den Fehlern ab, die vermieden werden sollen.
Eine Strategie bewerten
Um festzustellen, ob eine Strategie hilft, sollten repräsentative Testaufgaben definiert und vorab festgelegt werden, was als akzeptables Ergebnis gilt. Anschließend lassen sich Varianten vergleichen: etwa die Folgen davon, weniger Dokumente abzurufen, Belege anders anzuordnen oder eine ausführlichere Statuszusammenfassung zu speichern. Wo möglich, sollte jeweils nur eine Entscheidung verändert werden, damit sich die Ergebnisse leichter interpretieren lassen.
Bei der Bewertung können die Qualität von Antworten oder Handlungen, ausgelassene relevante Informationen, Auswahlfehler, Latenz, Kosten sowie Umfang und Sensibilität der einbezogenen Daten betrachtet werden. Bei dokumentengestützten Systemen ist außerdem zu prüfen, ob Antworten auf einschlägigen und aktuellen Quellen beruhen. Ergebnisse sind immer im Verhältnis zu den verwendeten Aufgaben und Testdaten zu interpretieren; sie belegen nicht automatisch, dass die Strategie auch in anderen Fällen funktioniert.
Um eine Verbesserung tatsächlich der Kontextverwaltung zuzuschreiben, müssen Ergebnisse systematisch verglichen werden. Modell und weitere relevante Bedingungen sollten dabei möglichst gleich bleiben. Ein einzelner überzeugender Eindruck reicht nicht aus, um einen ursächlichen Zusammenhang nachzuweisen. Treten Fehler auf, kann eine Analyse dessen, was abgerufen, ausgelassen und dem Modell tatsächlich bereitgestellt wurde, helfen, die Ursache einzugrenzen.
Kurze Checkliste für die Überprüfung
- 01Beantworten die einbezogenen Informationen einen ermittelten Bedarf der Aufgabe?
- 02Wurden Relevanz und Aktualität der Quellen geprüft?
- 03Bleiben wichtige Details erhalten, die eine Zusammenfassung auslassen könnte?
- 04Werden nicht benötigte personenbezogene Daten ausgeschlossen?
- 05Wurden Qualität, Auslassungen, Latenz und Kosten anhand repräsentativer Aufgaben gemessen?
- 06Wurden nicht vertrauenswürdige Eingaben und Fälle getestet, in denen der Abruf fehlschlägt?
Praktische Kriterien und verwandte Begriffe
Präzisieren Sie beim Entwurf eines Systems zunächst die Aufgabe und die Information, die eine Antwort oder Handlung verändern könnte. Rufen Sie nur Informationen aus zulässigen Quellen ab, wählen Sie relevante Inhalte aus und halten Sie die Möglichkeit offen, das Originalmaterial zu prüfen, wenn eine Zusammenfassung nicht ausreicht. Aktualisieren Sie den Arbeitsstand, sobald neue Belege vorliegen, statt unbegrenzt Gesprächsverlauf anzusammeln, der womöglich nicht mehr nützlich ist.
Testen Sie den Entwurf anschließend mit normalen Fällen und Grenzfällen: widersprüchlichen Quellen, veralteten Informationen, mehrdeutigen Anfragen und Dokumenten mit Anweisungen, die nichts mit der Aufgabe zu tun haben. Prüfen Sie, was das Modell erreicht, was ausgeschlossen bleibt und welches Ergebnis entsteht. Wenn das System scheitert, nehmen Sie nicht automatisch an, dass es mehr Kontext benötigt. Untersuchen Sie stattdessen, ob das Problem beim Abruf, bei der Auswahl oder Anordnung, bei der Aktualität der Daten oder bei der Interpretation durch das Modell liegt.
Weitere Begriffe finden sich in den Glossareinträgen zu Prompt Engineering, RAG, Chunking und Gedächtnis sowie im allgemeinen Glossarindex. Die praktische Abgrenzung ist einfach: Prompt Engineering betrifft vor allem Anweisungen, RAG den Informationsabruf für die Generierung, Chunking die Aufteilung von Materialien und Gedächtnis das Speichern und Abrufen von Zustandsinformationen. Kontext-Engineering befasst sich damit, wie diese Bausteine für eine konkrete Ausführung kombiniert werden.