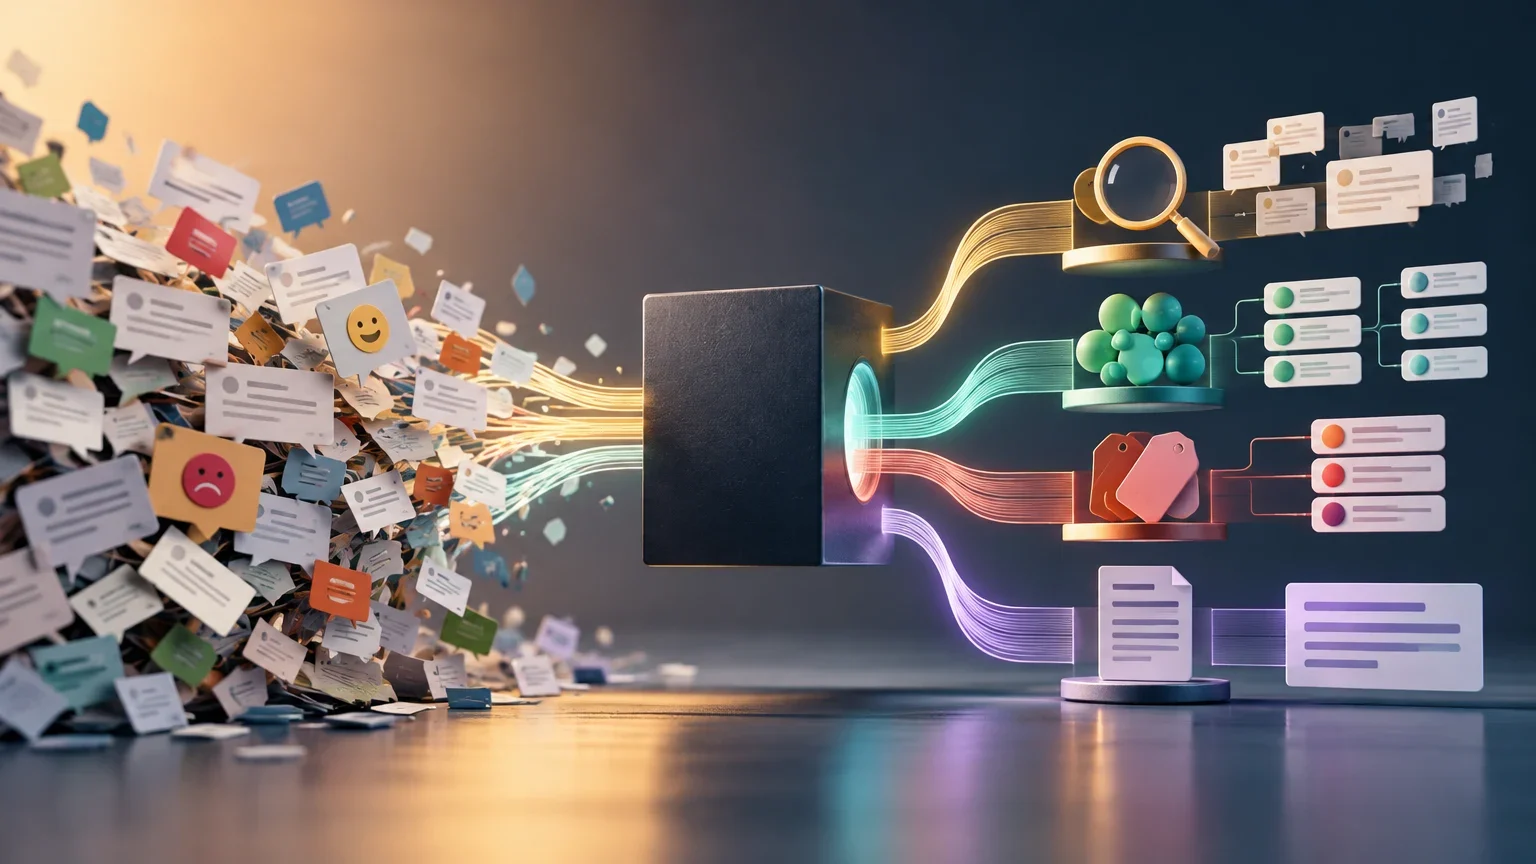
Délimiter le problème : quatre tâches distinctes
La première étape pour choisir un outil d'analyse du feedback est d'identifier ce qu'il faut faire avec les données. Il ne s'agit pas de la même chose que de trouver un commentaire spécifique, de découvrir des motifs cachés ou de rédiger un résumé exécutif. Confondre ces tâches conduit à mettre en œuvre des solutions coûteuses pour des problèmes simples ou, à l'inverse, à utiliser des méthodes rudimentaires pour des besoins complexes.
Il existe quatre besoins principaux : localiser des commentaires pertinents par la recherche, regrouper des thèmes par découverte exploratoire, mesurer des catégories connues par classification supervisée et rédiger une synthèse par génération assistée. Chacune nécessite une approche technique différente et a des implications distinctes en termes de coût, de précision et de maintenance.
La distinction entre ces quatre tâches est fondamentale car elle détermine la nature des données d'entrée et la forme de la sortie attendue. Par exemple, la recherche se concentre sur la localisation précise d'éléments spécifiques au sein d'un ensemble, produisant une liste de résultats pertinents, tandis que la découverte vise à identifier des structures thématiques dans un corpus non étiqueté, générant des groupes de commentaires similaires. Cette différenciation évite l'erreur courante d'appliquer une méthode de classification supervisée à un problème qui relève en réalité de la simple localisation textuelle, ce qui entraînerait un surcoût inutile et une complexité technique superflue.
Chaque approche technique possède des implications distinctes en termes de coût, de précision et de maintenance, ce qui justifie une analyse préalable approfondie. La recherche littérale ou sémantique offre une solution rapide pour des requêtes ponctuelles, alors que la génération assistée, bien qu'utile pour synthétiser de grands volumes, nécessite une vigilance accrue pour garantir la fidélité des résumés aux sources originales. En clarifiant ces besoins dès le départ, les équipes peuvent éviter de mettre en œuvre des solutions coûteuses pour des problèmes simples ou, à l'inverse, d'utiliser des méthodes rudimentaires pour des besoins complexes qui exigent une robustesse algorithmique supérieure.
Différences entre les quatre tâches d'analyse
Tableau contrastant l'objectif, l'entrée typique et la sortie attendue de chaque tâche.
| Tâche | Objectif principal | Entrée typique | Sortie attendue |
|---|---|---|---|
| Recherche | Localiser des commentaires spécifiques | Requête textuelle ou sémantique | Liste de commentaires pertinents |
| Découverte | Identifier des thèmes sans étiquettes préalables | Corpus de texte non étiqueté | Groupes de commentaires similaires |
| Classification | Attribuer des catégories connues | Texte et taxonomie définie | Étiquettes par commentaire |
| Génération | Rédiger une synthèse | Corpus complet ou filtré | Texte narratif résumant |
Entrées et restrictions du corpus
Avant de comparer les techniques, il est nécessaire d'auditer les caractéristiques de l'ensemble de données. Les commentaires clients sont rarement homogènes : ils proviennent de sondages, de tickets de support, d'avis publics et de réseaux sociaux, chacun avec son propre format, sa longueur et son niveau de structure.
Les facteurs critiques incluent le volume total de commentaires, la diversité des langues, la fréquence d'arrivée de nouvelles données et la présence d'informations personnelles. Un corpus petit et stable peut être géré avec des règles simples, tandis qu'un flux continu multilingue exige des modèles capables de généraliser et de se mettre à jour fréquemment.
L'audit des caractéristiques de l'ensemble de données est une étape préliminaire indispensable avant de comparer les différentes techniques d'analyse. Les commentaires clients proviennent rarement de sources homogènes ; ils sont issus de sondages, de tickets de support, d'avis publics et de réseaux sociaux, chacun présentant son propre format, sa longueur et son niveau de structure. Cette hétérogénéité impose une évaluation rigoureuse du volume total, de la diversité des langues et de la fréquence d'arrivée des nouvelles données, car ces facteurs influencent directement la capacité des modèles à généraliser et à se mettre à jour.
La présence d'informations personnelles constitue une contrainte supplémentaire qui doit être prise en compte dès la phase de conception. Un corpus petit et stable peut être géré avec des règles simples, tandis qu'un flux continu multilingue exige des modèles capables de traiter des données variées et de s'adapter fréquemment. Si les commentaires contiennent des données personnelles, l'approche choisie doit permettre l'anonymisation ou la minimisation des données avant le traitement, car la vérification de l'accès et de la rétention autorisés est un préalable légal et éthique à toute mise en œuvre technique.
Comparaison des alternatives techniques
Pour la tâche de localisation, la recherche littérale suffit si les requêtes sont exactes, mais la recherche sémantique permet de trouver des commentaires liés conceptuellement même s'ils ne partagent pas de mots-clés. Pour la découverte de thèmes, le regroupement exploratoire (clustering) identifie des motifs sans besoin d'étiquettes préalables, bien qu'il nécessite une interprétation humaine pour nommer les groupes.
La classification supervisée est l'option la plus robuste lorsqu'une taxonomie définie et des exemples étiquetés sont disponibles. Elle permet de mesurer la précision et de corriger les erreurs de manière systématique. La génération assistée, quant à elle, est utile pour synthétiser de grands volumes, mais doit être utilisée avec prudence pour éviter les hallucinations ou des résumés qui ne reflètent pas fidèlement les sources.
Pour la tâche de localisation, la recherche littérale suffit lorsque les requêtes sont exactes, mais la recherche sémantique permet de trouver des commentaires liés conceptuellement même s'ils ne partagent pas de mots-clés. Cette capacité à comprendre le contexte est essentielle pour identifier des signaux faibles qui seraient invisibles par une simple correspondance textuelle. Pour la découverte de thèmes, le regroupement exploratoire identifie des motifs sans besoin d'étiquettes préalables, bien qu'il nécessite une interprétation humaine pour nommer les groupes et leur attribuer une signification opérationnelle.
La classification supervisée est l'option la plus robuste lorsqu'une taxonomie définie et des exemples étiquetés sont disponibles, car elle permet de mesurer la précision et de corriger les erreurs de manière systématique. La génération assistée, quant à elle, est utile pour synthétiser de grands volumes, mais doit être utilisée avec prudence pour éviter les hallucinations ou des résumés qui ne reflètent pas fidèlement les sources. Un cas documenté par une entité financière illustre cette complexité en décrivant un flux combinant des embeddings multilingues, un fine-tuning avec SetFit, une réduction de dimensionnalité avec UMAP et un regroupement avec HDBSCAN, permettant de classifier des commentaires dans plusieurs langues et de détecter des thèmes récurrentes.
Matrice de décision pour choisir l'approche
Le choix final dépend du croisement entre le résultat requis et les conditions opérationnelles de l'équipe. S'il n'y a pas d'étiquettes préalables et qu'il faut découvrir des thèmes, le regroupement exploratoire est le point de départ. Si les catégories sont définies et qu'il y a des exemples étiquetés, la classification supervisée offre un meilleur contrôle et une meilleure traçabilité.
Le budget, la latence acceptable et la capacité de révision humaine sont des facteurs déterminants. Un système en temps réel exige une infrastructure plus coûteuse qu'un système par lots. De plus, la tolérance à l'erreur varie selon l'usage : une erreur dans la classification d'une plainte de sécurité est plus grave qu'une erreur dans la catégorisation d'un élogie.
Le choix final dépend du croisement entre le résultat requis et les conditions opérationnelles de l'équipe. S'il n'y a pas d'étiquettes préalables et qu'il faut découvrir des thèmes, le regroupement exploratoire est le point de départ, tandis que si les catégories sont définies et qu'il y a des exemples étiquetés, la classification supervisée offre un meilleur contrôle et une meilleure traçabilité. Cette matrice de décision simplifiée guide la sélection de la technique initiale selon la disponibilité des étiquettes et le besoin de mise à jour, en tenant compte des considérations clés telles que la nécessité d'interprétation humaine ou la possibilité de mesurer la précision.
Le budget, la latence acceptable et la capacité de révision humaine sont des facteurs déterminants dans cette décision. Un système en temps réel exige une infrastructure plus coûteuse qu'un système par lots, ce qui doit être évalué en fonction des besoins opérationnels. De plus, la tolérance à l'erreur varie selon l'usage : une erreur dans la classification d'une plainte de sécurité est plus grave qu'une erreur dans la catégorisation d'un élogie. Il est donc crucial d'aligner la complexité technique avec la criticité des données traitées pour éviter des risques disproportionnés.
Matrice de décision simplifiée
Guide rapide pour sélectionner la technique initiale selon la disponibilité des étiquettes et le besoin de mise à jour.
| Condition | Approche recommandée | Considération clé |
|---|---|---|
| Sans étiquettes préalables | Regroupement exploratoire | Nécessite l'interprétation humaine des clusters |
| Avec étiquettes et exemples | Classification supervisée | Permet de mesurer la précision et de corriger |
| Besoin de synthèse | Génération assistée | Vérifier la fidélité aux sources |
| Recherche ponctuelle | Recherche sémantique | Coût inférieur aux modèles complexes |
Erreurs pertinentes et vérifications opérationnelles
Les erreurs les plus coûteuses ne sont pas toujours les plus visibles. Omettre un signal critique, comme une plainte de sécurité, peut avoir de graves conséquences. Attribuer une catégorie incorrecte peut entraîner des actions inappropriées. Produire une synthèse non étayée par des commentaires identifiables érode la confiance dans le système.
Avant la mise en œuvre, il est essentiel de vérifier que chaque étiquette ou affirmation de la synthèse peut être retracée jusqu'aux commentaires sources. Il doit exister un processus de correction lorsqu'une personne détecte une erreur et un mécanisme de déléguage à la révision humaine pour les cas ambigus ou à fort impact. La traçabilité et la capacité d'audit sont aussi importantes que la précision du modèle.
Les erreurs les plus coûteuses ne sont pas toujours les plus visibles. Omettre un signal critique, comme une plainte de sécurité, peut avoir de graves conséquences, tandis qu'attribuer une catégorie incorrecte peut entraîner des actions inappropriées. Produire une synthèse non étayée par des commentaires identifiables érode la confiance dans le système et compromet sa crédibilité auprès des parties prenantes. Ces risques soulignent l'importance de mettre en place des mécanismes de contrôle rigoureux pour garantir la fiabilité des résultats.
Avant la mise en œuvre, il est essentiel de vérifier que chaque étiquette ou affirmation de la synthèse peut être retracée jusqu'aux commentaires sources. Il doit exister un processus de correction lorsqu'une personne détecte une erreur et un mécanisme de déléguage à la révision humaine pour les cas ambigus ou à fort impact. La traçabilité et la capacité d'audit sont aussi importantes que la précision du modèle, car elles permettent de maintenir la confiance et d'assurer la conformité aux exigences légales et éthiques. Ce processus de validation avant la mise en œuvre garantit que l'approche choisie satisfait les conditions réelles de l'équipe.
Processus de validation avant la mise en œuvre
Étapes pour s'assurer que l'approche choisie satisfait les conditions réelles de l'équipe.
- 01Définir la tâche principale : recherche, découverte, classification ou génération.
- 02Auditer le corpus : volume, langues, structure et données personnelles.
- 03Vérifier la disponibilité des étiquettes et des exemples représentatifs.
- 04Évaluer le budget, la latence et la capacité de révision humaine.
- 05Établir un mécanisme de traçabilité et de correction des erreurs.
Questions ouvertes
- Il n'existe pas de données comparatives indépendantes sur les coûts ou les performances entre les techniques pour un même corpus.
- L'efficacité des modèles génératifs pour une synthèse fidèle dépend de la qualité des instructions et de la vérification humaine, sans métriques standard universelles.
- L'impact de la latence sur la satisfaction client varie selon le secteur et n'est pas quantifié dans les sources fournies.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction