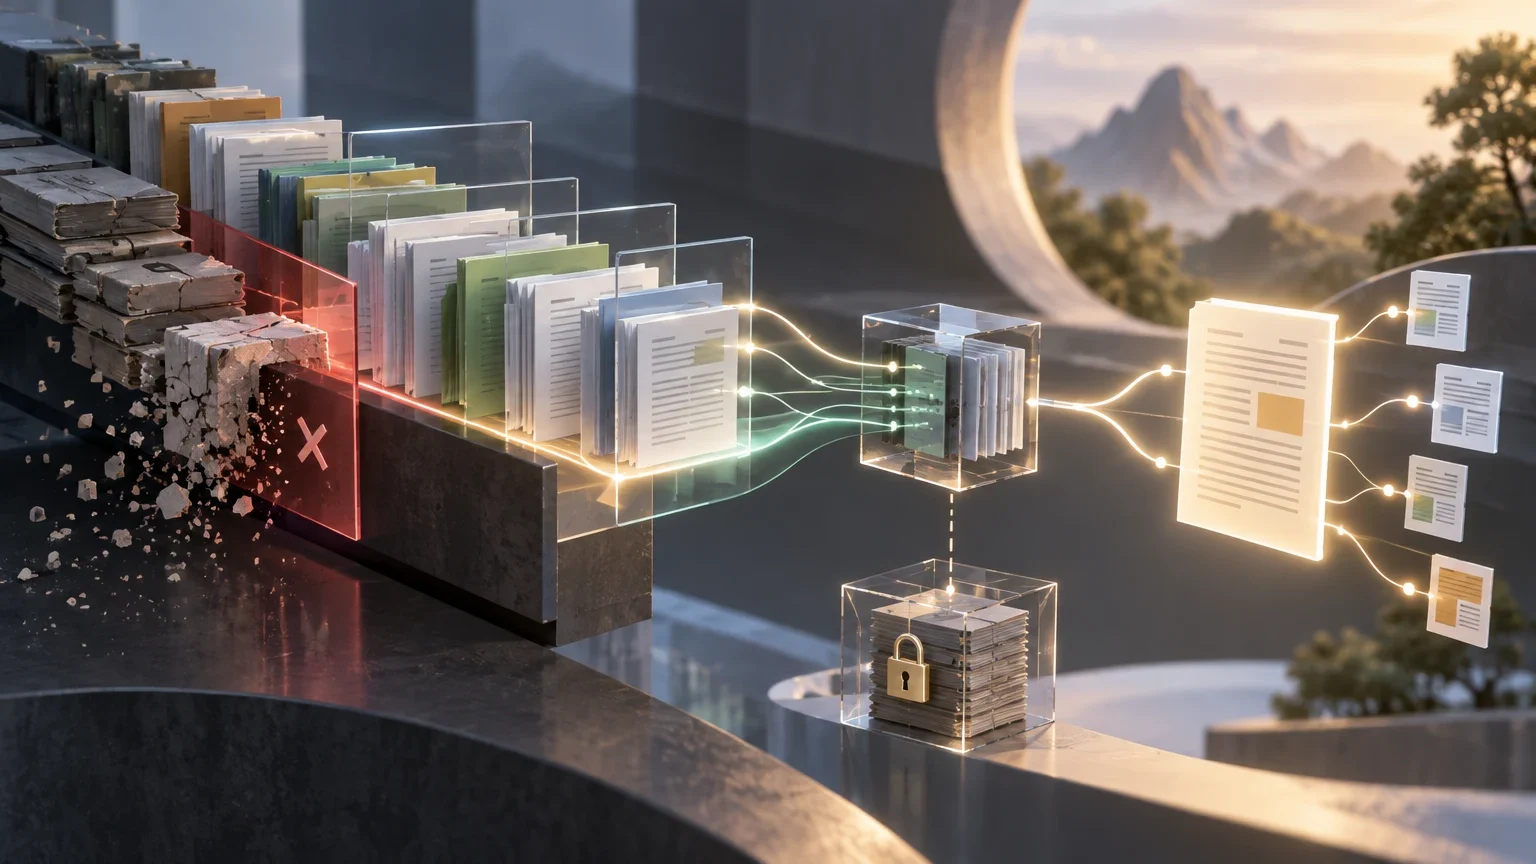
Le problème : une citation peut être exacte et pourtant inutilisable
Un système de génération augmentée par récupération, ou RAG, est souvent évalué en vérifiant s’il récupère un texte pertinent et si la réponse s’appuie sur ce texte. Ce contrôle est nécessaire, mais il ne suffit pas lorsque le corpus évolue. Une réponse peut reproduire fidèlement un extrait d’une politique annulée, d’un manuel remplacé ou d’un contrat qui ne s’applique plus à la personne qui pose la question. Dans ce cas, la défaillance ne se situe pas nécessairement dans la génération : elle se trouve dans le cycle de vie de la preuve.
Il convient de distinguer deux questions. La première est sémantique : l’extrait récupéré répond-il à la requête ? La seconde relève de la gouvernance : cette source était-elle autorisée, accessible et en vigueur pour cette requête et à cet instant ? La similarité vectorielle, à elle seule, ne résout pas la seconde. Un ancien texte peut sembler plus proche de la question qu’une révision récente ; une copie locale peut contenir des instructions différentes d’une politique centrale ; et un extrait indexé lorsqu’une personne disposait d’un accès peut continuer à apparaître après la perte de cette permission.
La thèse opérationnelle est simple : ajouter des fichiers à un index ne crée pas une base de connaissances maintenable. Il faut pour cela une identité stable du document, une révision identifiable, une période de validité, une règle d’autorité, des contrôles d’accès appliqués lors de la récupération et un journal reliant chaque réponse aux preuves effectivement consultées. Il faut également un retrait explicite : le fait de ne plus publier un fichier dans la source ne garantit pas qu’il disparaisse des index, réplicas, caches ou journaux dérivés.
Ce guide traite le corpus comme un système d’enregistrements soumis à des changements, et non comme un simple dossier de fichiers. L’objectif n’est pas de promettre des réponses infaillibles. Il consiste à pouvoir démontrer pourquoi une preuve était éligible, détecter le moment où elle cesse de l’être et s’abstenir lorsque les règles disponibles ne permettent pas de déterminer laquelle de plusieurs sources actives doit prévaloir.
Dissocier identité, révision, validité, autorité et accès
L’identité répond à la question de l’objet documentaire géré. Elle doit rester stable même si le titre, l’emplacement ou le format changent. Par exemple, une politique d’entreprise peut conserver son identifiant canonique lorsqu’elle passe d’un document bureautique à une page web. La révision répond à la question de l’édition précise qui contient le texte. Une correction éditoriale et un remplacement normatif peuvent créer des révisions distinctes, même si la modification semble mineure.
La validité exprime la période durant laquelle une révision peut être utilisée comme preuve. Elle ne doit pas être confondue avec la date d’indexation ni avec la date de modification technique du fichier. Une politique publiée aujourd’hui peut entrer en vigueur le mois prochain ; une autre peut être conservée uniquement pour des consultations historiques. Il est donc utile d’enregistrer au minimum un début de validité, une fin de validité lorsqu’elle existe et un état opérationnel, tel que brouillon, approuvé, actif, retiré ou restauré à titre exceptionnel.
L’autorité ordonne les sources susceptibles de traiter le même sujet. Une politique globale approuvée peut prévaloir sur un guide local, sauf si une exception valable s’applique à une juridiction, une unité ou un produit. Cette règle ne peut pas être déduite de manière fiable à partir de la rédaction ou de la similarité. Elle doit être un attribut gouverné, doté d’un propriétaire et d’une règle explicite de préséance. Si deux sources actives se contredisent et qu’aucune règle applicable n’existe, le comportement prudent consiste à ne pas en choisir une selon sa popularité ou sa proximité sémantique.
La permission d’accès est une autre dimension indépendante. Un extrait ne cesse pas de contenir des informations protégées parce qu’il a été découpé, vectorisé ou stocké dans un index. Les filtres d’autorisation doivent être appliqués avant le classement des résultats par pertinence et doivent être mis à jour lorsque les listes de contrôle d’accès évoluent. La documentation de services de recherche confirme que la sécurité au niveau du document peut restreindre les documents d’un index visibles par une personne, et que les changements de permissions imposent de maintenir synchronisés les documents concernés.
Cette conception rejoint une idée fondamentale de la provenance : distinguer les entités, les activités et les agents. Le document canonique, sa révision et chaque extrait sont des entités ; l’extraction, le découpage, la création d’embeddings et l’indexation sont des activités ; le propriétaire, l’approbateur et le service qui exécute un processus sont des agents. Modéliser ces relations n’oblige pas à adopter une technologie précise, mais évite de transformer la traçabilité en notes libres difficiles à interroger.
Décision minimale avant de récupérer un extrait
| Dimension | Question opérationnelle | Traitement si elle manque ou échoue |
|---|---|---|
| Identité | L’extrait est-il relié à un document canonique ? | L’exclure des réponses appuyées sur des preuves. |
| Révision | Connaît-on l’édition exacte ayant produit l’extrait ? | L’exclure ou le signaler pour réparation du corpus. |
| Validité | La révision était-elle active à l’instant de la requête ? | La filtrer avant de calculer la similarité. |
| Autorité | Une règle de préséance existe-t-elle pour son périmètre ? | Faire remonter le conflit ou s’abstenir. |
| Accès | La personne conserve-t-elle l’autorisation de consulter le document ? | Ne pas renvoyer l’extrait ni l’utiliser pour la génération. |
Modèle de données minimal pour un corpus gouverné
Un modèle minimal n’a pas besoin de saisir tous les métadonnées possibles, mais il doit inclure celles qui permettent de décider l’éligibilité et de reconstruire les faits. L’entité de document canonique peut comprendre un identifiant immuable, un type documentaire, un périmètre, un propriétaire responsable, une source d’origine et une classification. L’entité de révision doit disposer de son propre identifiant, d’une empreinte du contenu reçu, d’un état d’approbation, d’un début et d’une fin de validité, d’une date de publication connue et d’une relation avec la révision antérieure ou remplacée.
Chaque extrait récupérable doit porter l’identifiant du document canonique et de la révision, une position ou une plage stable au sein de la révision, l’empreinte de son texte normalisé et les attributs nécessaires au filtrage. L’embedding n’est pas l’extrait : il s’agit d’une représentation dérivée. Il nécessite donc son propre identifiant de modèle, une version de configuration, une date de calcul et une référence à l’extrait exact qui l’a produit. L’index est aussi une entité opérationnelle : enregistrez sa version, sa partition ou son réplica, sa configuration de recherche, son instant de publication et l’ensemble des révisions incluses.
Ajoutez des relations explicites telles que remplace, dérive de, fusionne et retire. Une fusion documentaire ne correspond pas nécessairement à un remplacement un pour un : plusieurs documents peuvent être absorbés par une nouvelle source, tandis qu’une partie de l’information peut ne pas avoir de successeur. Cette distinction permet de répondre à la question de savoir si un document a été retiré, quel est son successeur lorsqu’il existe et si une consultation historique doit encore pouvoir le retrouver sous des contrôles spécifiques.
Les champs temporels demandent une discipline particulière. Conservez le temps observé dans la source, le temps d’approbation, l’intervalle de validité métier, le temps d’extraction et le temps de publication dans l’index. Ne supposez pas qu’ils sont interchangeables. Pour reconstruire une réponse, il importe de savoir ce qui était connu et ce qui était disponible opérationnellement, en plus de savoir quel texte se déclarait en vigueur. Lorsque les horloges de plusieurs systèmes ne sont pas synchronisées ou qu’une date provient de métadonnées peu fiables, enregistrez cette incertitude au lieu de la transformer en certitude artificielle.
Entités et champs à conserver
| Entité | Champs minimaux | Finalité |
|---|---|---|
| Document canonique | ID stable, propriétaire, périmètre, classification, autorité | Identifier l’objet gouverné. |
| Révision | ID, empreinte, état, validité, successeur ou prédécesseur | Déterminer quelle édition peut être utilisée. |
| Extrait | ID, révision, plage, empreinte textuelle, métadonnées de filtrage | Récupérer une preuve traçable. |
| Embedding | ID, extrait, modèle, configuration, date | Distinguer la représentation dérivée du texte. |
| Publication d’index | ID, configuration, ensemble inclus, heure de publication | Reconstruire l’environnement de recherche. |
| Événement de réponse | requête, filtres, candidats, version d’index, heure | Expliquer les preuves disponibles et sélectionnées. |
Flux de changement : mettre à jour n’est pas une opération unique
L’ajout initial commence par la validation de la source, de l’identité, du propriétaire, de la classification et des règles d’accès. Le contenu est ensuite extrait, une révision est créée, le texte est découpé, des représentations sont calculées et une version d’index est publiée. La publication doit être atomique du point de vue de la requête ou, au minimum, éviter les états dans lesquels une partie d’une révision est visible et une autre ne l’est pas. Si des approbations sont requises, un brouillon peut être traité techniquement sans être éligible aux réponses.
Une correction mineure exige de comparer la nouvelle empreinte à celle de la révision antérieure et de localiser les segments modifiés. Recalculer uniquement les extraits concernés peut réduire le travail, mais seulement si l’algorithme de découpage maintient des références correctes. Si une modification déplace des titres, une numérotation ou des sections, elle peut affecter davantage d’extraits qu’une comparaison littérale ne l’indique. L’optimisation doit rester subordonnée à la traçabilité : il vaut mieux réindexer davantage de contenu que conserver des liens ambigus entre un embedding et un texte.
Le remplacement d’une politique est un événement de gouvernance. Il doit créer une révision ou un document successeur, fixer la date d’entrée en vigueur, clôturer la validité de l’élément antérieur lorsque cela s’applique et propager le retrait à tous les artefacts dérivés. Dans certains systèmes d’indexation, les documents qui ne sont plus présents dans la source peuvent exiger une action de suppression explicite ; une réexécution ne doit donc pas être considérée comme la preuve d’un retrait complet. La vérification doit examiner l’état des index et des réplicas, et pas seulement le registre de la source.
Un retrait total conserve, si la politique de conservation le permet, un historique non éligible aux réponses ordinaires. Cet historique peut être nécessaire pour l’audit, l’enquête sur un incident ou la reconstruction d’une réponse passée. Il doit être séparé des index actifs, avec des contrôles d’accès et une finalité définie. Restaurer une source retirée est exceptionnel : cela doit produire un nouvel événement, justifier le changement d’état et déclencher une nouvelle publication vérifiable, au lieu d’effacer la trace du retrait antérieur.
Processus de remplacement d’une source
- 01Enregistrer la révision entrante, son propriétaire, son autorité et sa date de validité prévue.
- 02Comparer le contenu et les métadonnées à la révision en vigueur ; identifier les extraits affectés et les relations de succession.
- 03Approuver ou rejeter la nouvelle révision selon le flux documentaire applicable.
- 04Créer ou mettre à jour les extraits et embeddings ; publier une version d’index identifiable.
- 05Marquer la révision antérieure comme remplacée ou retirée à la date définie et l’exclure de l’éligibilité à la récupération.
- 06Invalider les résultats de récupération et les réponses stockées qui dépendent de la révision antérieure.
- 07Exécuter des tests de requête, de permissions, de réplicas et de caches ; conserver le résultat du déploiement.
Réindexation, caches et doublons : maintenir la cohérence entre les représentations
La réindexation sélective est utile lorsqu’il est possible de démontrer la relation entre chaque représentation et son entrée. Calculez les différences de texte et de métadonnées. Une modification du contenu impose de revoir les extraits et embeddings affectés. Une modification de la validité, de l’autorité, de la juridiction ou de la permission peut ne pas altérer le texte, mais elle change l’éligibilité à la récupération ; les filtres, index de métadonnées et caches doivent donc être mis à jour. Ne traiter que les modifications textuelles ouvre une voie à des réponses incorrectes fondées sur un contenu littéralement inchangé.
Tous les caches ne stockent pas la même chose. Il peut exister des caches de téléchargement de la source, d’extraits traités, d’embeddings, de résultats de récupération et de réponses finales. Chacun a besoin d’une clé qui incorpore les dépendances pertinentes, comme la version d’index, la révision des sources, l’identité de la personne ou son groupe d’accès, la juridiction et la date de la requête lorsque la réponse porte sur la validité. Réutiliser une réponse sans ces dimensions peut divulguer du contenu ou ressusciter une politique retirée.
Les principes du cache web distinguent fraîcheur, validation et invalidation, et établissent que les requêtes qui modifient l’état d’une ressource doivent invalider les représentations stockées applicables. Dans un corpus RAG, le mécanisme concret peut différer, mais le principe est transférable : lorsqu’une source ou son éligibilité change, il faut localiser et retirer ou invalider les représentations dérivées susceptibles de continuer à servir la version précédente.
Les doublons sémantiques exigent une politique explicite. Deux extraits peuvent exprimer la même règle tout en appartenant à des révisions différentes ; renvoyer les deux peut accroître artificiellement la confiance du modèle. Regroupez les candidats par document canonique ou par relation de révision avant de générer la réponse. Le regroupement ne doit pas masquer les conflits : si deux sources actives et également autorisées divergent, conservez le conflit comme signal pour s’abstenir ou demander une revue humaine.
Récupérer selon le temps, l’autorité et les permissions avant de classer par similarité
La requête de récupération doit être construite comme une séquence de restrictions et de classement, non comme une recherche vectorielle suivie d’un contrôle facultatif. Déterminez d’abord le contexte : identité de la personne qui interroge, permissions effectives, produit, juridiction, audience, date pertinente et besoin éventuel de consulter l’historique. Filtrez ensuite les révisions et extraits qui ne respectent pas ce contexte. Seuls les candidats éligibles doivent passer au calcul de similarité, à la recherche lexicale ou à une combinaison des deux.
La date pertinente exige une décision produit visible. Pour les questions portant sur la règle actuelle, utilisez l’instant de la requête. Pour une question telle que « quelle politique s’appliquait lorsque j’ai signé ? », demandez ou déduisez avec prudence une date de référence et recherchez dans l’historique autorisé. Si la date n’est pas connue, ne présentez pas une reconstruction historique comme si elle était actuelle. Il vaut mieux demander l’information, afficher la portée temporelle des preuves ou limiter la réponse à ce qui peut être justifié.
L’autorité peut être mise en œuvre sous la forme d’un score, mais ne devrait pas toujours être réduite à un nombre. Certaines règles sont strictes : une norme obligatoire dans une juridiction peut exclure un guide général. D’autres peuvent être préférentielles et permettre la coexistence. Documentez les règles, leur propriétaire et les exceptions. Le système génératif ne devrait pas inventer une hiérarchie à partir du ton des documents.
Avant la rédaction, conservez la liste des candidats filtrés, les motifs d’exclusion, la configuration de l’index et les extraits finalement utilisés. Le journal doit distinguer les preuves récupérées des preuves citées dans la réponse. Il doit aussi enregistrer l’heure de la requête et la version des règles de filtrage. Sans ces données, une enquête ultérieure pourrait retrouver le document actuel, sans pouvoir démontrer quel corpus a produit le résultat d’origine.
Ordre recommandé pour une requête appuyée sur des preuves
- 01Résoudre l’identité, les permissions et le contexte de la personne utilisatrice.
- 02Fixer la date de référence et le périmètre de la requête.
- 03Exclure les documents ou révisions retirés, expirés, futurs, non autorisés ou hors périmètre.
- 04Appliquer les règles d’autorité, de juridiction, de produit et d’audience.
- 05Rechercher et classer uniquement dans l’ensemble éligible.
- 06Regrouper les révisions liées et détecter les conflits non résolus.
- 07Générer une réponse limitée aux preuves sélectionnées ou s’abstenir.
- 08Enregistrer les candidats, exclusions, index, règles et heure de la requête.
Tests de régression, critères d’arrêt et responsabilités
Les tests doivent évaluer le comportement du système face aux changements, et pas seulement la qualité de récupération sur un ensemble stable. Construisez des cas comprenant une politique retirée qui conserve une similarité plus forte que son remplacement, un extrait supprimé d’une révision, une politique approuvée avec une date de validité future, une copie locale qui contredit une source centrale et une permission révoquée après l’indexation. Chaque cas doit déclarer les documents éligibles, celui qui doit prévaloir lorsqu’une règle d’autorité existe et le moment où la bonne sortie consiste à s’abstenir.
Testez également la propagation dans le temps. Mesurez le délai entre l’approbation d’un retrait et son exclusion effective des index, réplicas et caches pertinents. Il ne suffit pas de tester l’index principal : une réponse générée antérieurement peut être stockée dans une autre couche. Définissez des objectifs de délai distincts selon le risque associé à la source. Une politique de sécurité ou un document contenant des données sensibles peut nécessiter une invalidation plus rapide qu’un guide éditorial interne.
Établissez des critères d’arrêt clairs. Bloquez une réponse lorsqu’il manque le lien entre l’extrait et la révision, lorsque les permissions ne peuvent pas être évaluées, lorsque la source n’a pas de propriétaire ou lorsqu’un conflit actif ne dispose pas d’une règle de préséance. Affichez la date de mise à jour lorsqu’elle contribue à interpréter la réponse, mais ne l’utilisez pas pour masquer une incertitude. Orientez vers une revue humaine s’il existe des preuves potentiellement pertinentes que le système ne peut pas ordonner à l’aide de règles explicites.
Les responsabilités doivent être séparées, même si une même personne peut en assumer plusieurs dans les petites équipes. Le propriétaire de source répond du contenu et de son cycle de validité. Le responsable de l’indexation répond de l’extraction, de la publication et de l’invalidation technique. L’approbateur de validité décide quand une révision est utilisable. Le responsable des incidents coordonne le retrait urgent, l’évaluation de l’exposition et la communication. L’équipe produit définit la manière dont l’abstention est exprimée et dont un contexte supplémentaire est demandé à la personne utilisatrice.
Comme prochaine étape, transformez ce modèle en liste de contrôles vérifiables et reliez-le aux guides du centre d’apprentissage sur l’évaluation des assistants, la comparaison des approches de récupération et la découverte des sources. L’implémentation dépendra de l’architecture, mais le critère de succès reste le même : pour chaque réponse importante, l’équipe doit pouvoir expliquer quelles preuves pouvaient être utilisées, lesquelles l’ont été, pourquoi elles étaient autorisées et ce qui aurait empêché de répondre.
Batterie minimale de tests de régression
| Cas | Résultat attendu | Preuve de test |
|---|---|---|
| Document remplacé | La nouvelle révision prévaut même si l’ancienne est plus similaire. | Journal des filtres, candidats et révision sélectionnée. |
| Extrait retiré | Il n’apparaît ni dans la récupération ni dans une réponse stockée. | Requête aux index et vérification de l’invalidation du cache. |
| Validité future | Il n’est pas utilisé pour une question sur la règle actuelle. | Date de référence et motif d’exclusion. |
| Conflit local et central | La règle d’autorité est appliquée ou le système s’abstient. | Règle évaluée et décision résultante. |
| Permission révoquée | L’extrait cesse d’être visible pour l’identité concernée. | Test avec identités autorisée et non autorisée. |
| Reconstruction historique | L’ensemble des preuves alors disponibles est reproduit. | Version d’index, horloge de requête et journal de réponse. |
Questions ouvertes
- La manière exacte de représenter les permissions, la validité et les règles d’autorité dépend du référentiel documentaire, du moteur de recherche et des exigences réglementaires de chaque organisation.
- Une réindexation sélective n’est sûre que si le système peut démontrer quels extraits et représentations dérivent de chaque révision ; dans le cas contraire, il peut être nécessaire de réindexer un ensemble plus large.
- La reconstruction historique peut être limitée par la politique de conservation, par la préservation des versions d’index et par la disponibilité des journaux d’audit.
- Les documents des fournisseurs décrivent des capacités et comportements de produits précis ; ils ne prouvent pas que toute architecture RAG offre les mêmes garanties sans une implémentation et des tests propres.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction