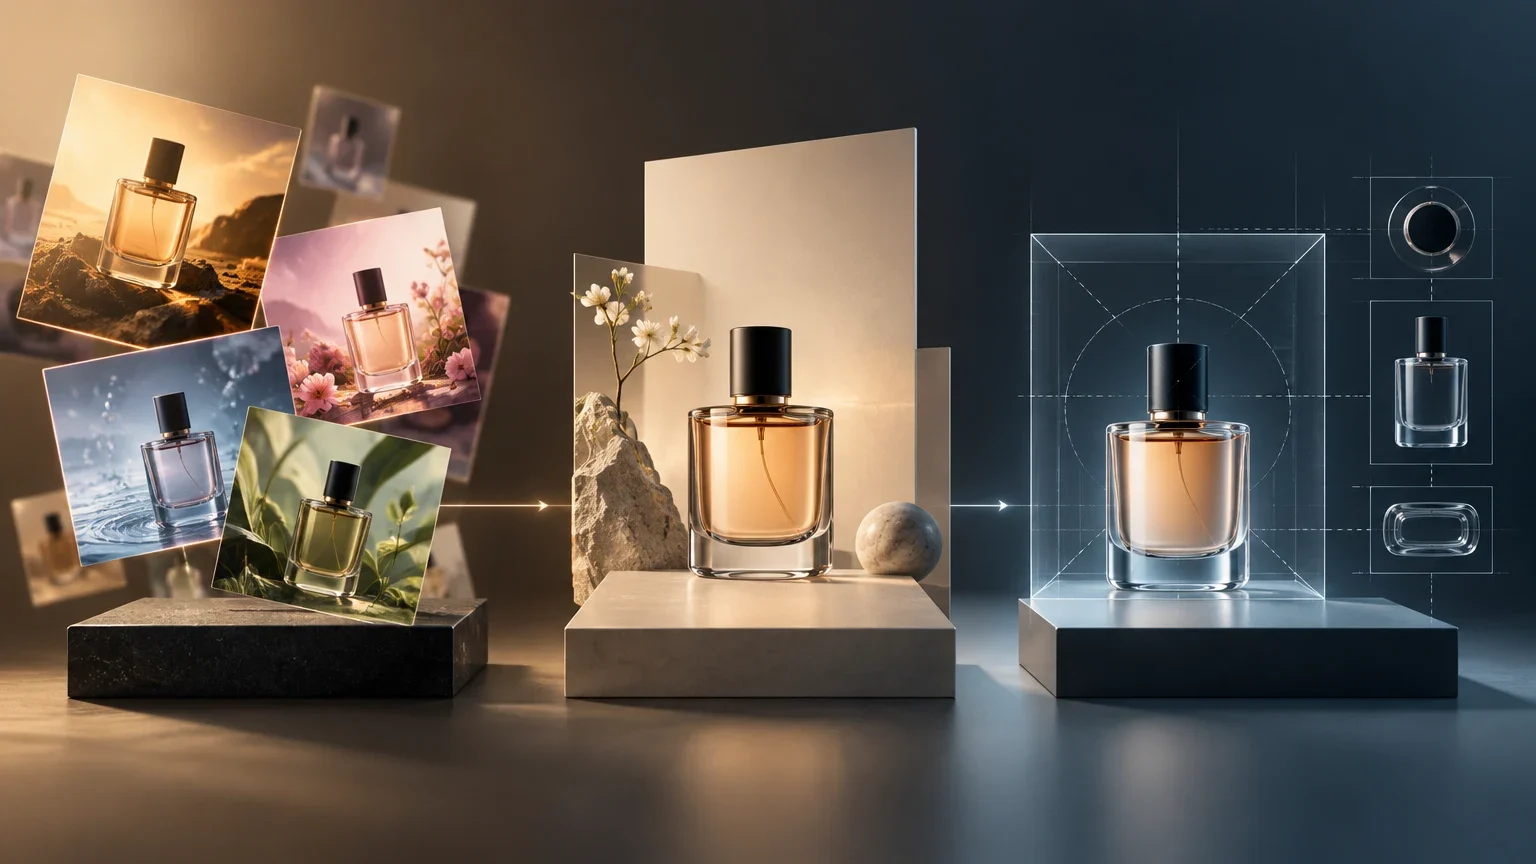
La limite du prompt simple en photographie produit
La génération d'images produit par intelligence artificielle fait face à un défi fondamental : l'écart entre l'intention de l'utilisateur et la capacité de compréhension spatiale du modèle. Les modèles de diffusion actuels n'interprètent pas le langage naturel avec la profondeur nécessaire pour garantir une composition exacte. Comme le souligne la documentation technique, ces systèmes comprennent les concepts de manière générale et les mélangent pour créer quelque chose de cohérent, mais pas nécessairement orienté comme l'a demandé l'utilisateur.
Ce comportement est particulièrement problématique dans le e-commerce, où la position d'un objet, la relation d'échelle entre les éléments ou la visibilité de détails spécifiques sont critiques. Un prompt décrivant une « balle de football sous une balle de basket » peut générer une image où la relation spatiale est incorrecte ou ambiguë. Par conséquent, supposer qu'un texte descriptif détaillé garantit un résultat reproductible est une erreur courante qui mène à la frustration et à la nécessité de corrections manuelles constantes.
Cette limitation fondamentale s'explique par la nature même de l'architecture des modèles de diffusion, qui fonctionnent par débruitage itératif plutôt que par raisonnement logique séquentiel. Le modèle ne construit pas une scène étape par étape en respectant des contraintes géométriques rigides, mais il reconstruit une image à partir de distributions de probabilités apprises sur des millions de paires texte-image. Par conséquent, lorsque le prompt contient des instructions spatiales contradictoires ou complexes, le modèle privilégie la cohérence statistique globale de l'image plutôt que la fidélité stricte à la syntaxe spatiale demandée. Cela signifie que les relations comme « sous », « derrière » ou « à l'intérieur » sont traitées comme des tokens sémantiques parmi d'autres, sans garantie de positionnement absolu dans l'espace bidimensionnel de la sortie.
Dans le contexte spécifique du e-commerce, cette incertitude probabiliste se traduit par un risque opérationnel majeur : l'incohérence perçue par le client final. Une image où un produit semble flotter de manière irréaliste ou où les proportions entre l'objet principal et son environnement sont faussées peut éroder la confiance dans l'authenticité de l'offre. Le prompt simple, en tant qu'outil de contrôle, échoue à fournir la détermination nécessaire pour un usage commercial où chaque pixel doit servir une intention de vente précise. Il est donc impératif de considérer le prompt non pas comme un plan de construction, mais comme une suggestion de style, en acceptant que la géométrie finale sera une interprétation du modèle et non une exécution de l'instruction.
Niveau 1 : Variation esthétique rapide
À ce niveau, l'objectif est de générer des variations visuelles attrayantes pour des campagnes marketing, les réseaux sociaux ou l'exploration de concepts. Ici, l'utilisation directe d'un modèle de diffusion avec un prompt bien structuré est suffisante. La clé ne réside pas dans la précision géométrique, mais dans la cohérence stylistique et la qualité esthétique. Les erreurs de composition mineures sont acceptables si l'image communique l'essence du produit et de la marque.
Pour ce niveau, il est crucial de bien définir les modificateurs de style, l'éclairage et l'environnement. Cependant, il ne faut pas s'attendre à ce que le modèle respecte des instructions complexes de distribution des éléments. La stratégie consiste à générer plusieurs variations et à sélectionner celles qui correspondent le mieux à la direction artistique, en acceptant que le contrôle est limité et que le résultat est une « hypothèse visuelle » qui doit être évaluée subjectivement.
L'acceptation de l'imprécision géométrique au Niveau 1 repose sur une compréhension claire de la valeur perçue de l'image dans ce contexte. Pour les réseaux sociaux ou les bannières promotionnelles, l'impact émotionnel et la qualité visuelle priment sur la véracité technique de la composition. Le but est de capter l'attention et de transmettre une atmosphère, pas de documenter la structure physique du produit. Ainsi, les erreurs de perspective ou de placement sont souvent invisibles pour l'observateur non averti, surtout si l'éclairage et la texture sont de haute qualité. Cette approche permet une itération rapide, où le coût d'une image ratée est minimal puisqu'elle est simplement écartée au profit d'une variante plus réussie.
La stratégie de sélection multiple est donc le levier principal de ce niveau. En générant un lot d'images avec des variations subtiles de prompt ou de paramètres de génération, l'équipe créative transforme le problème de contrôle en un problème de curation. Le temps passé à affiner le prompt pour obtenir une précision parfaite est réalloué à la sélection des meilleures sorties. Cette méthode est particulièrement efficace pour l'exploration de concepts, où la diversité des résultats est un atout plutôt qu'un défaut. Elle permet de découvrir des angles visuels inattendus qui n'auraient pas été envisagés avec une approche trop rigide, tout en maintenant un niveau de qualité esthétique élevé grâce à des modificateurs de style bien définis.
Niveau 2 : Cohérence de marque stricte
Lorsque l'image doit maintenir une identité visuelle stricte (même produit, même angle, même palette de couleurs, même style de fond) pour un catalogue ou une page d'atterrissage, le prompt simple ne suffit plus. C'est là qu'interviennent les outils de référence d'image, tels que image-to-image ou ControlNet. Ces techniques permettent d'utiliser une image de base approuvée pour guider la génération, en s'assurant que les éléments clés restent cohérents entre les différentes variations.
La documentation de Microsoft souligne que les modèles modernes acceptent des entrées texte et image, ce qui facilite ce flux. Cependant, la complexité technique augmente. Il est nécessaire de définir quels éléments de l'image de référence doivent être conservés (composition, style, identité) et lesquels peuvent varier. Ce niveau nécessite une « bible visuelle » ou un document de continuité qui établit des règles claires pour éviter les déviations subtiles qui brisent la cohérence de la marque.
L'intégration de références d'image au Niveau 2 introduit une couche de contrainte qui réduit significativement l'espace de solutions possibles du modèle. En fournissant une image de base, on ancre la génération dans un contexte visuel spécifique, ce qui force le modèle à respecter la composition, les couleurs et les formes déjà présentes. Cette technique est essentielle pour les catalogues où la cohérence entre les pages est un impératif de design. Le modèle ne crée plus ex nihilo, mais il adapte et varie légèrement une structure existante, ce qui garantit que l'identité de la marque reste intacte malgré les changements de fond ou d'éclairage.
La définition précise des éléments à conserver et à modifier est cruciale pour éviter les artefacts indésirables. Utiliser des masques ou des poids de force permet de cibler les zones de l'image qui doivent rester figées (comme le produit lui-même) et celles qui peuvent être régénérées (comme l'arrière-plan). Cette granularité de contrôle transforme l'IA en un outil de retouche assistée plutôt qu'en un générateur autonome. La « bible visuelle » mentionnée précédemment devient alors le guide opérationnel pour ces paramètres, assurant que chaque variation respecte les règles de continuité établies par le département de design, ce qui réduit les allers-retours avec les équipes marketing et accélère la production finale.
Comparatif de contrôle au Niveau 2
| Élément | Prompt simple | Référence d'image (img2img/ControlNet) |
|---|---|---|
| Composition | Aléatoire / Probabiliste | Guidée par l'image de base |
| Identité du produit | Risque de variation élevé | Haute cohérence si masque ou poids approprié |
| Complexité technique | Faible | Moyenne-Élevée (nécessite paramètres de force et masque) |
Niveau 3 : Précision géométrique et détail
Dans les cas où la précision est critique, comme la visualisation de détails techniques, l'intégration exacte d'un produit dans un environnement spécifique ou la correction de défauts visuels, la génération directe (même avec des références) est souvent insuffisante. Ici, le flux de travail doit inclure un post-traitement manuel ou des outils d'édition traditionnels. L'IA peut générer la base, mais le contrôle final revient à l'éditeur humain.
Ce niveau est le plus coûteux en temps et en ressources, mais il est nécessaire lorsque le « coût d'erreur visuelle » est élevé. Par exemple, si une erreur dans la position d'une étiquette ou dans la proportion d'un composant peut entraîner des retours ou des problèmes juridiques, l'intervention manuelle est obligatoire. L'IA s'intègre dans ce flux comme un outil d'accélération, et non comme une solution autonome.
Le recours au post-traitement manuel au Niveau 3 est justifié par la nécessité de garantir une exactitude absolue dans des contextes où l'erreur n'est pas une option. Cela inclut les produits techniques, les pièces de rechange ou les objets dont les dimensions et les détails doivent être représentés avec une fidélité photographique stricte. Dans ces cas, la génération par IA sert de base de travail, fournissant un fond ou une ambiance, mais le produit lui-même est souvent composité ou corrigé manuellement pour s'assurer que chaque détail, de la texture à la réflexion de la lumière, est parfaitement aligné avec la réalité physique de l'objet.
Ce flux de travail hybride combine la rapidité de la génération IA avec la précision de l'édition humaine. L'IA accélère la phase de création du contexte, tandis que l'humain assure la validation finale et les corrections fines. Cette division des tâches est particulièrement efficace pour les volumes faibles à moyens, où le coût de la main-d'œuvre est justifié par la valeur ajoutée de la précision. Elle permet également de gérer les cas complexes où le produit doit être intégré dans un environnement spécifique avec des contraintes de perspective ou d'éclairage que les modèles actuels ne peuvent pas encore résoudre de manière fiable et autonome.
Flux de travail pour précision critique
- 01Générer une image de base avec l'IA en utilisant des références de composition.
- 02Évaluer l'image par rapport à la « bible visuelle » de la marque.
- 03Identifier les déviations géométriques ou de détail.
- 04Corriger manuellement dans un logiciel d'édition (Photoshop, After Effects, etc.).
- 05Valider le résultat final par rapport aux exigences de spécification technique.
Matrice de décision et protocole de test
Pour choisir le flux approprié, le projet doit être évalué selon trois critères : le coût d'une erreur visuelle, le besoin de reproductibilité exacte et le volume de production. Si l'erreur est tolérable et le volume élevé, le Niveau 1 est efficace. Si la cohérence est critique et le volume moyen, le Niveau 2 est l'équilibre optimal. Si la précision est absolue et le volume faible, le Niveau 3 est la seule option viable.
Avant de mettre à l'échelle un flux, un protocole de test est recommandé : générer 10 images avec la méthode choisie, les évaluer par rapport à une liste de vérification de cohérence et mesurer le temps de correction manuelle. Si plus de 30 % des images nécessitent une correction significative, le flux n'est pas adapté à l'échelle de production souhaitée. Cette approche évite l'investissement dans une infrastructure technique inutile ou l'acceptation d'erreurs qui nuisent à la perception de la marque.
Le protocole de test recommandé avant le passage à l'échelle est un garde-fou essentiel contre les coûts cachés de la production. En générant un échantillon représentatif et en le soumettant à une évaluation rigoureuse, on peut identifier les faiblesses du flux choisi avant d'investir dans une infrastructure plus lourde. Le seuil de 30 % de corrections significatives est un indicateur clé : au-delà de ce taux, le temps passé à corriger les images annule les gains de productivité apportés par l'IA, rendant le flux non viable pour une production à grande échelle. Cette mesure objective permet de prendre des décisions éclairées basées sur les données réelles de performance plutôt que sur des suppositions.
L'évaluation doit également prendre en compte la cohérence perçue par le public cible, pas seulement la conformité technique. Une image peut être techniquement correcte mais visuellement incohérente avec l'image de marque, ce qui nécessite une correction ou un rejet. Le protocole de test doit donc inclure une phase de validation par les parties prenantes clés (marketing, design, juridique) pour s'assurer que les images générées répondent à toutes les exigences non seulement esthétiques mais aussi réglementaires et commerciales. Cette approche holistique garantit que le flux choisi est non seulement efficace techniquement, mais aussi aligné avec les objectifs stratégiques de l'entreprise.
Matrice de décision par niveau
| Critère | Niveau 1 (Prompt) | Niveau 2 (Référence) | Niveau 3 (Post-traitement) |
|---|---|---|---|
| Coût d'erreur | Faible | Moyen | Élevé |
| Reproductibilité | Faible | Élevée | Totale (manuelle) |
| Volume | Élevé | Moyen | Faible |
| Ressources techniques | Basiques | Intermédiaires | Avancées + Humaines |
Questions ouvertes
- Il n'y a pas de données quantitatives disponibles sur le pourcentage exact d'images nécessitant une correction manuelle à chaque niveau pour le marché spécifique du e-commerce.
- L'économie de temps en utilisant des références d'image par rapport à la génération directe varie selon la complexité du produit et l'expérience de l'équipe, et n'est pas standardisée dans les sources.
- L'efficacité des modèles spécifiques (comme GPT-Image ou Stable Diffusion) dans la préservation des détails fins du produit n'est pas comparée expérimentalement dans les sources fournies.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction