Quel problème résout l’observabilité ?
Une réponse médiocre ne permet pas, à elle seule, d’identifier le composant qui a échoué. Il peut s’agir d’une génération non étayée, mais aussi d’une requête de récupération ayant renvoyé des documents peu pertinents, d’un outil externe ayant retourné une erreur, d’une validation ayant accepté une sortie incorrecte ou d’une nouvelle tentative ayant modifié le comportement et le coût. Se limiter à enregistrer le texte final et un indicateur d’erreur laisse trop d’hypothèses ouvertes.
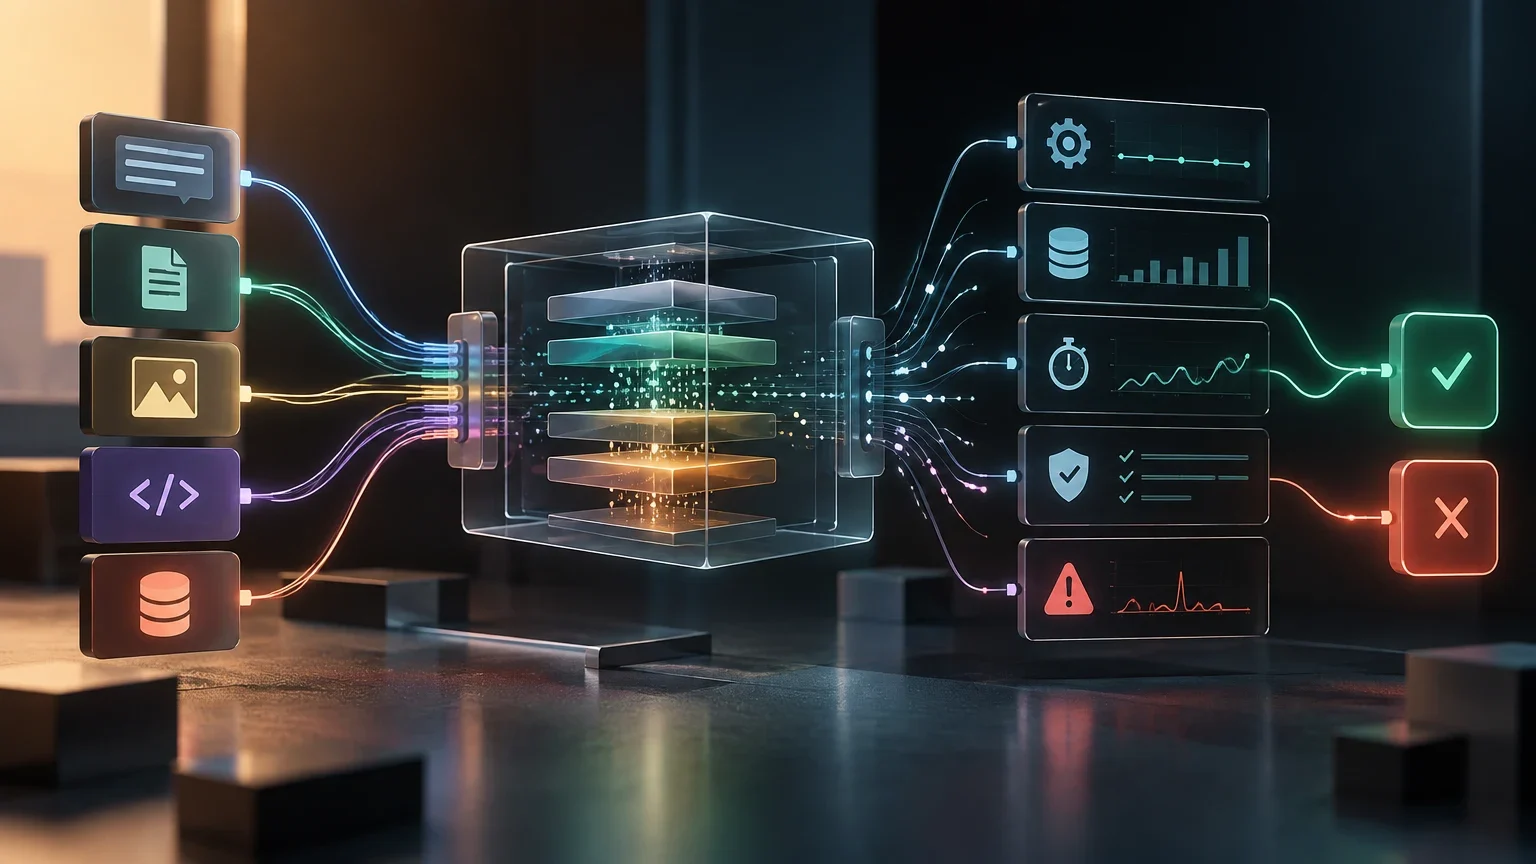
L’observabilité transforme une interaction en une séquence reconstruisible de faits techniques. Son objectif pratique est de répondre, pour une exécution précise comme pour une population d’exécutions, quelle version a traité la demande, quelles entrées structurées elle a reçues, quelles étapes elle a exécutées, combien de temps chacune a pris, quelles ressources ont été consommées et quel a été le résultat vérifiable. Ces éléments permettent de distinguer un incident isolé d’une régression intervenue après une modification.
Elle ne remplace pas les évaluations avant déploiement et ne garantit pas qu’une réponse soit correcte. Son rôle est de compléter ces pratiques par des signaux de production. Les sources fournies décrivent la nécessité de relier le modèle, le prompt, les temps par étape, les nouvelles tentatives, les jetons, le coût et la qualité lorsque le cas d’usage l’exige. Ce guide traduit ce cadre en un contrat d’instrumentation minimal, sans présumer qu’une métrique agrégée explique à elle seule la cause racine.
Pour naviguer depuis ce cadre vers des ressources connexes, l’architecture de contenu peut renvoyer vers [Apprendre](route:learn.index), [Comparer](route:compare.index) et [Découvrir](route:discover.index). Ces liens ne remplacent pas les éléments de preuve recueillis dans la trace de chaque exécution.
L’unité d’analyse : une trace d’interaction
L’unité utile minimale est une trace par interaction métier, et non par appel isolé au modèle. Elle doit commencer lorsque l’application accepte une tâche identifiable — par exemple répondre à une question ou traiter une demande — et se terminer lorsqu’elle livre, rejette ou abandonne un résultat. La trace possède un identifiant stable et contient des intervalles enfants correspondant aux étapes qui la composent.
Un intervalle représente une opération délimitée : normalisation de l’entrée, récupération, appel au modèle, exécution d’un outil, nouvelle tentative, validation, post-traitement ou livraison. Chaque intervalle conserve sa relation de parenté, son début, sa fin, son état et ses attributs spécifiques. Ainsi, une latence totale élevée peut être décomposée sans attribuer automatiquement le retard au fournisseur du modèle.
La trace doit être liée à un identifiant de demande ou de conversation pseudonymisé, à un canal, à un type de tâche et à une cohorte de déploiement. Il n’est pas souhaitable d’utiliser ces attributs pour stocker du texte libre ou des identifiants directs de personnes. L’objectif est de pouvoir segmenter une dégradation par version, tâche, environnement ou canal sans réidentifier la personne ayant utilisé le service.
La reconstruction doit inclure des références immuables aux versions utilisées : modèle et paramètres pertinents, modèle de prompt, configuration de récupération, définition des outils, règles de validation et version du flux. Si un identifiant pointe vers un contenu modifiable, une enquête ultérieure peut reconstruire une configuration différente de celle qui a produit l’incident.
Le contrat minimal de télémétrie
Définissez le contrat avant d’instrumenter. Au niveau de la trace, enregistrez l’identifiant, l’heure, l’environnement, le type de tâche, le canal, la cohorte, la version du flux, l’état final et un résultat métier lorsqu’il existe. Au niveau de l’intervalle, enregistrez le type d’opération, l’état, la durée, le numéro de tentative, les dépendances et les attributs permettant de comparer les configurations. Utilisez un vocabulaire contrôlé pour des états tels que succès, erreur technique, erreur de validation, rejet sûr, annulation et délai dépassé.
Pour un appel au modèle, les attributs minimaux comprennent le fournisseur ou la famille de modèles, la version ou l’alias résolu lorsqu’il est disponible, les paramètres qui modifient matériellement la sortie, l’identifiant du modèle de prompt, les jetons d’entrée et de sortie, ainsi que le coût calculé ou les données suffisantes pour le calculer selon le tarif en vigueur. Pour la récupération, incluez l’index ou la collection versionnée, la stratégie, les filtres, le nombre de candidats et les documents sélectionnés au moyen d’identifiants non sensibles.
Les outils nécessitent un nom et une version, l’opération demandée, le code de résultat, la classe d’erreur, la durée et l’idempotence ou une clé de corrélation lorsqu’ils exécutent des actions. Pour les validations, enregistrez le nom et la version de la règle, le résultat et une catégorie d’échec. Ne confondez pas un JSON syntaxiquement valide avec une réponse acceptable pour le métier : ce sont des signaux distincts.
Le contrat doit préciser ce qui est exclu. Par défaut, évitez les prompts, les réponses, les documents récupérés, les arguments complets des outils, les adresses électroniques, numéros de téléphone, adresses postales, secrets, jetons d’accès et toute donnée non indispensable au diagnostic. Lorsque le texte est nécessaire à un débogage autorisé, appliquez la minimisation, le masquage, les contrôles d’accès et une rétention distincte.
Champs et décision d’enregistrement
| Champ | Usage de diagnostic | Traitement recommandé |
|---|---|---|
| trace_id et span_id | Reconstruire la séquence | Enregistrer |
| Version du modèle, du prompt et du flux | Comparer les modifications | Enregistrer |
| Jetons, durée et état | Mesurer le coût et les performances | Enregistrer |
| ID de document récupéré | Examiner la pertinence | Enregistrer sans contenu par défaut |
| Texte utilisateur ou réponse | Analyser des cas précis | Exclure ou minimiser ; accès restreint |
| Identifiants et secrets | N’apportent aucun diagnostic légitime | Ne pas enregistrer |
Comment mesurer le coût réel par interaction
Le coût par interaction ne correspond pas au coût moyen d’un appel principal. Additionnez les appels du modèle en entrée et en sortie, les nouvelles tentatives, les appels d’outils ayant leur propre facturation, la récupération si elle génère une dépense attribuable et les étapes échouées. Distinguez le coût observé d’une estimation : le premier provient de données d’usage et de prix appliqués ; la seconde peut dépendre de tarifs, d’arrondis ou d’informations incomplètes.
Attribuez chaque composant à la même trace et conservez la devise, la date de calcul et la version de la grille tarifaire ou de la méthode d’estimation. Cette précaution est importante, car une modification de prix, de modèle ou de modalité de traitement peut empêcher la comparaison directe de deux périodes. S’il n’existe aucun coût vérifiable pour un composant, marquez-le comme inconnu au lieu de lui attribuer zéro.
Mesurez des distributions, et pas seulement des moyennes. Une moyenne stable peut masquer une traîne d’interactions comportant de multiples nouvelles tentatives ou des contextes excessifs. Segmentez par tâche, canal, version et résultat final. Le coût d’une exécution qui se termine en erreur reste un coût opérationnel et doit apparaître tant dans le total que dans l’analyse du gaspillage.
Lorsqu’une revue humaine intervient, il est préférable de l’enregistrer comme un coût ou un effort opérationnel distinct, selon une méthode d’estimation explicite. La mélanger à la dépense d’inférence peut masquer qu’une optimisation de latence a déplacé le travail vers les personnes.
Calcul auditable du coût par trace
- 01Regrouper tous les intervalles enfants par trace_id, y compris ceux qui se sont terminés par une erreur ou une annulation.
- 02Additionner le coût des jetons par appel avec le tarif et la date applicables ; conserver la source du calcul comme attribut interne.
- 03Ajouter les coûts attribuables des outils et de la récupération sans remplacer les valeurs inconnues par zéro.
- 04Distinguer le coût d’inférence, l’infrastructure attribuable et la revue humaine estimée.
- 05Publier le total, les composantes, le pourcentage d’exécutions échouées avec coût et les percentiles par cohorte.
Distinguer les sources de latence
La latence de bout en bout est le temps perçu par la personne qui utilise l’application, mais elle n’indique pas quel composant doit être corrigé. Enregistrez des intervalles pour la file d’attente ou l’admission, la préparation du contexte, la récupération, les appels au modèle, le réseau lorsque cela peut être observé, les outils, les nouvelles tentatives, la validation et la sérialisation de sortie. La somme peut ne pas correspondre exactement au total en cas d’opérations parallèles ; c’est pourquoi la relation temporelle entre les intervalles doit également être enregistrée.
Comparez les percentiles de durée par étape, et pas seulement la valeur moyenne totale. Une hausse du percentile élevé des outils, alors que la latence du modèle est stable, oriente l’enquête vers une dépendance externe. Une augmentation de la récupération peut provenir d’un index, d’un filtre ou d’une hausse du nombre de candidats. Une réponse lente due à des nouvelles tentatives impose d’examiner à la fois la condition qui les déclenche et leur politique de limites.
Évitez les attributions simplistes. Le fait qu’une trace contienne un appel au modèle ne démontre pas que le modèle constitue le goulot d’étranglement. L’élément de preuve adéquat est une distribution temporelle segmentée par la même version, le même type de tâche et des conditions comparables. Les changements de trafic, de contenu ou de composition des utilisateurs sont des facteurs de confusion qui doivent être consignés.
Signaux de qualité en production et leurs limites
La qualité ne doit pas être réduite à un score unique. Le retour des utilisateurs reflète l’expérience perçue, mais il peut être rare, biaisé vers les cas extrêmes ou manquer de contexte. La revue humaine permet d’appliquer des critères définis et de détecter des erreurs subtiles, mais elle a un coût et une couverture limitée. Les règles déterministes sont reproductibles pour des exigences vérifiables, telles qu’un schéma ou une autorisation, mais elles ne capturent pas à elles seules l’utilité, l’exactitude factuelle ou l’adéquation au contexte.
Les évaluateurs automatiques peuvent aider à prioriser les échantillons et à suivre des tendances s’ils sont versionnés, calibrés par rapport à une revue humaine et employés avec des limites explicites. Ils ne constituent pas une preuve indépendante de vérité, en particulier lorsqu’ils évaluent des tâches ambiguës ou partagent des biais avec le système évalué. Enregistrez leur version, l’entrée disponible, le critère, le résultat et le niveau de confiance si la méthode le produit.
Reliez tous les signaux à la trace et distinguez clairement leur provenance. Une baisse des évaluations positives n’est pas équivalente à une règle métier non respectée ; une sortie JSON valide ne démontre pas que ses valeurs sont correctes. Le tableau de bord doit permettre de voir chaque signal séparément, puis d’examiner les concordances ou les divergences.
Échantillonnez des cas sans retour utilisateur en plus des cas négatifs. Dans le cas contraire, l’équipe apprend à partir des personnes qui signalent les problèmes, mais pas à partir des erreurs silencieuses. Le plan d’échantillonnage doit être documenté : population, période, strates, taille et critère de revue.
Interprétation des signaux de qualité
| Signal | Ce qu’il apporte | Limite principale |
|---|---|---|
| Retour utilisateur | Expérience perçue | Couverture et biais de réponse |
| Revue humaine | Jugement contextuel avec grille d’évaluation | Coût et variabilité entre évaluateurs |
| Règle déterministe | Conformité reproductible | Ne couvre que des conditions définies |
| Évaluateur automatique | Suivi et priorisation | Requiert un calibrage et peut se tromper |
Diagnostic de quatre incidents fréquents
Une réponse inventée doit être examinée en remontant du résultat vers l’amont. Vérifiez si la tâche exigeait un fondement, si un contexte a été récupéré, quels documents ont été sélectionnés, quelles instructions d’utilisation des sources s’appliquaient et si une règle ou une revue a détecté des affirmations non étayées. Si la configuration de récupération ou la version du prompt n’a pas été enregistrée, la cause peut rester indéterminée ; n’attribuez pas l’échec au modèle par élimination.
Face à un contexte non pertinent, comparez la requête normalisée, les filtres, la collection versionnée, la stratégie, le nombre de candidats et la sélection finale. Le problème peut relever de l’indexation, des filtres, des métadonnées, d’évolutions du corpus ou de la stratégie de classement. La faible pertinence peut aussi provenir d’un classement de la demande dans une mauvaise tâche avant toute récupération d’information.
Pour un JSON invalide, séparez la couche syntaxique de la couche sémantique. Examinez le schéma requis, la méthode de sortie structurée, la version de l’analyseur, les nouvelles tentatives et la réponse de validation. Une nouvelle tentative réussie peut masquer une hausse du taux de premières réponses invalides et augmenter le coût comme la latence.
Face à l’échec d’une action d’outil, déterminez si l’outil a été appelé, s’il a reçu des arguments autorisés, si la dépendance a répondu, si un délai a expiré et s’il y a eu des effets partiels. Les actions ayant des conséquences doivent intégrer des clés d’idempotence, des états de confirmation et des limites de nouvelles tentatives. Une réponse finale satisfaisante ne prouve pas que l’action a été exécutée.
Routine d’enquête sur les incidents
- 01Délimiter l’incident par période, cohorte, tâche et résultat ; conserver l’identifiant de trace d’un échantillon représentatif.
- 02Comparer les traces affectées à un groupe comparable antérieur ou témoin, sans mélanger des canaux ou tâches différents.
- 03Localiser le premier intervalle anormal et examiner ses versions, son état, sa durée, ses nouvelles tentatives et ses dépendances.
- 04Confronter l’hypothèse aux signaux de qualité, aux règles métier et aux résultats des outils.
- 05Appliquer une mesure de mitigation réversible, vérifier son effet sur la cohorte et documenter les éléments de preuve ainsi que les incertitudes restantes.
Alertes, seuils et décisions d’arrêt
Une alerte utile précise la métrique, la fenêtre, le segment, le seuil, le responsable, les éléments de preuve requis et l’action initiale. « La qualité baisse » ne satisfait pas ce critère. Une formulation opérationnelle pourrait surveiller l’augmentation des erreurs de validation d’une version précise sur une fenêtre définie, exiger des traces d’échantillons et attribuer une revue à la personne responsable du flux.
Utilisez les seuils comme des règles d’attention, et non comme une preuve de causalité. Ils doivent reposer sur une référence propre au service et être révisés lorsque le volume, la composition des tâches ou le produit évoluent. Combinez les alertes de disponibilité et de sécurité avec une revue de la qualité et du coût : optimiser une métrique isolée peut en dégrader une autre.
Arrêtez, annulez ou limitez une modification lorsqu’elle enfreint une condition de sécurité, une règle métier critique ou une limite économique convenue, ou lorsque les éléments de preuve montrent une dégradation importante par rapport à une cohorte comparable. Dans les autres cas, réduisez l’exposition par des déploiements progressifs et augmentez l’échantillonnage avant de conclure.
Les sources fournies recommandent de relier performances, coût et qualité, ainsi que de comparer des versions ou des environnements. Le choix précis des seuils n’est pas établi universellement dans ces sources ; il doit être dérivé des risques, de la référence et des engagements de service.
Modèle d’alerte
| Cas | Métrique et fenêtre | Action initiale |
|---|---|---|
| Coût anormal | Coût par trace et percentile élevé par version | Limiter la cohorte et examiner les nouvelles tentatives |
| Sortie invalide | Taux d’échec de validation par flux | Rétablir l’analyseur ou la configuration si le contrat est affecté |
| Outil défaillant | Erreurs et délais dépassés par dépendance | Activer une dégradation sûre et examiner les effets partiels |
| Qualité dégradée | Règles non respectées et échantillon humain comparable | Suspendre l’extension et comparer au contrôle |
Rétention, minimisation et accès
Une trace détaillée peut devenir un référentiel sensible si elle est conçue sans limites. Commencez par la question de diagnostic et n’enregistrez que les attributs nécessaires pour y répondre. Les identifiants pseudonymisés, les hachages gérés de manière appropriée et les catégories d’erreur apportent souvent davantage de valeur opérationnelle que le stockage indiscriminé de prompts, réponses ou documents complets.
Séparez les données opérationnelles des données de débogage exceptionnel. Les premières peuvent inclure des durées, versions, compteurs, états et références techniques ; les secondes, si elles sont justifiées, nécessitent un accès limité, un masquage, une journalisation des accès et une rétention courte définie. Examinez aussi les données que des bibliothèques d’instrumentation envoient à des tiers avant de les activer.
Définissez qui peut consulter les traces, qui peut accéder au contenu exceptionnel et qui peut modifier les règles de rédaction ou de rétention. Les demandes de suppression, les exigences réglementaires et les politiques internes peuvent varier selon la juridiction et le cas d’usage. Ce guide ne détermine pas les obligations juridiques ; elles exigent une évaluation adaptée au contexte de l’organisation.
La documentation New Relic fournie mentionne des filtres permettant d’écarter des données sensibles avant leur envoi. Ce fait confirme la faisabilité technique du filtrage, mais ne démontre pas qu’une configuration précise soit suffisante pour toutes les catégories de données ni pour tous les cadres réglementaires.
Modèle final de lancement et tableau de bord minimal
Avant de publier une version, vérifiez que chaque exécution peut être liée à une version immuable du flux, du prompt, du modèle, de la récupération, des outils et des validations. Vérifiez que les nouvelles tentatives apparaissent comme des intervalles ou des attributs distincts, que les jetons et les coûts sont attribués à toutes les tentatives et que les résultats métier ne sont pas confondus avec les erreurs techniques.
Le tableau de bord minimal doit combiner le volume de traces, le taux d’états finaux, la latence totale et par étape, les jetons et le coût par interaction, les nouvelles tentatives, les résultats de validation, les erreurs d’outils et les signaux de qualité séparés selon leur origine. Tous les graphiques doivent pouvoir être filtrés par période, environnement, version, tâche, canal et cohorte afin d’éviter les comparaisons entre populations hétérogènes.
Pour le lancement, sélectionnez une cohorte témoin ou une référence antérieure et définissez à l’avance les conditions d’élargissement, de pause et de retour en arrière. Conservez des échantillons de traces représentatifs, y compris des exécutions réussies, échouées et coûteuses. Documentez les changements de trafic, de corpus, de prix ou de politiques susceptibles d’altérer l’interprétation.
Le résultat attendu n’est pas une explication automatique de chaque incident. C’est un système qui réduit la dépendance aux souvenirs, aux captures d’écran et aux impressions isolées, et qui montre explicitement quand les éléments de preuve permettent une conclusion et quand ils ne le permettent pas encore.
Checklist de lancement
- 01Attribuer des versions immuables au modèle, au prompt, à la récupération, aux outils, à la validation et au flux.
- 02Exécuter des traces de test couvrant le succès, la nouvelle tentative, l’échec d’outil, le rejet de validation et l’annulation.
- 03Vérifier que coût, jetons et latence sont ventilés par étape et conservés lors des tentatives échouées.
- 04Vérifier les filtres de données sensibles, les autorisations d’accès et la politique de rétention.
- 05Définir une cohorte témoin, les responsables des alertes, des seuils révisables et une condition de retour en arrière.
- 06Examiner un échantillon humain et documenter les incertitudes avant d’élargir le déploiement.
Questions ouvertes
- Les sources fournies sont en grande partie des guides éditoriaux ou des cas de mise en œuvre ; elles n’établissent pas de norme universelle pour les schémas, seuils ou durées de rétention.
- Aucune donnée comparative indépendante n’est fournie pour fixer des valeurs précises d’alerte, des objectifs de qualité ou des coûts acceptables.
- L’URL du cas Buk contient une date future par rapport à certains contextes possibles de publication ; elle est utilisée uniquement comme matériel fourni sur les pratiques décrites, et non pour inférer une actualité ou une adoption générale.
- Les obligations de confidentialité, de sécurité et de conservation dépendent de la juridiction, des données traitées et du contexte organisationnel, et ne peuvent pas être déterminées à partir des sources fournies.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction