Quale problema risolve l’osservabilità
Una risposta insufficiente non identifica da sola il componente che ha fallito. Può trattarsi di una generazione non supportata da fonti, ma anche di una query di recupero che ha restituito documenti poco pertinenti, di uno strumento esterno che ha risposto con un errore, di una validazione che ha accettato un output scorretto o di un tentativo che ha modificato comportamento e costo. Limitarsi a registrare il testo finale e un indicatore di errore lascia aperte troppe ipotesi.
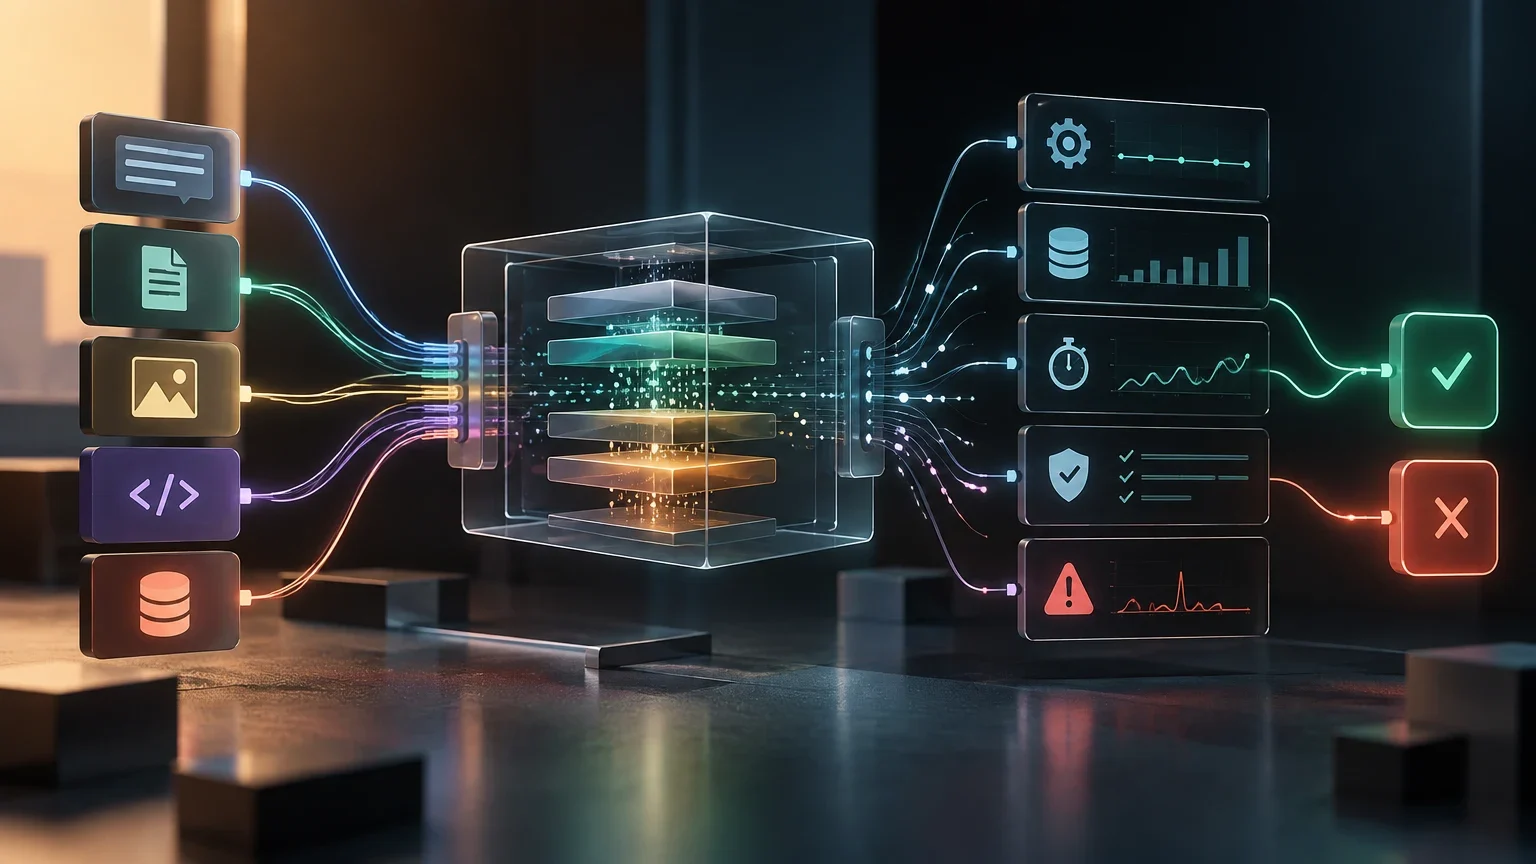
L’osservabilità trasforma un’interazione in una sequenza ricostruibile di fatti tecnici. Il suo scopo pratico è rispondere, per una specifica esecuzione e anche per una popolazione di esecuzioni, quale versione ha gestito la richiesta, quali input strutturati ha ricevuto, quali passaggi ha svolto, quanto è durato ciascuno, quali risorse ha consumato e quale sia stato il risultato verificabile. Questa evidenza consente di distinguere un incidente isolato da una regressione successiva a una modifica.
Non sostituisce le valutazioni precedenti al rilascio né garantisce che una risposta sia corretta. La sua funzione è integrare tali pratiche con segnali di produzione. Le fonti fornite descrivono la necessità di collegare modello, prompt, tempi per fase, tentativi, token, costo e qualità quando il caso d’uso lo richiede. Questa guida traduce tale quadro in un contratto minimo di strumentazione, senza presumere che una metrica aggregata spieghi da sola la causa radice.
Per passare da questo quadro a materiali correlati, l’architettura dei contenuti può collegare a [Impara](route:learn.index), [Confronta](route:compare.index) e [Scopri](route:discover.index). Questi collegamenti non sostituiscono l’evidenza raccolta nella traccia di ogni esecuzione.
L’unità di analisi: una traccia di interazione
L’unità minima utile è una traccia per interazione di business, non per una chiamata isolata al modello. Deve iniziare quando l’applicazione accetta un’attività identificabile — per esempio rispondere a una domanda o elaborare una richiesta — e terminare quando consegna, rifiuta o abbandona un risultato. La traccia dispone di un identificatore stabile e contiene intervalli figli per le fasi che la compongono.
Un intervallo rappresenta un’operazione delimitata: normalizzazione dell’input, recupero, chiamata al modello, esecuzione di uno strumento, tentativo, validazione, post-elaborazione o consegna. Ogni intervallo conserva la relazione gerarchica, l’inizio, la fine, lo stato e attributi specifici. In questo modo, una latenza totale elevata può essere scomposta senza attribuire automaticamente il ritardo al fornitore del modello.
La traccia deve essere associata a un identificatore pseudonimizzato di richiesta o conversazione, a un canale, a un tipo di attività e a una coorte di rilascio. Non è opportuno usare questi attributi per memorizzare testo libero o identificatori diretti di persone. Lo scopo è poter segmentare un degrado per versione, attività, ambiente o canale senza reidentificare chi ha utilizzato il servizio.
La ricostruzione deve includere riferimenti immutabili alle versioni impiegate: modello e parametri rilevanti, modello di prompt, configurazione del recupero, definizione degli strumenti, regole di validazione e versione del flusso. Se un identificatore punta a contenuto modificabile, un’indagine successiva potrebbe ricostruire una configurazione diversa da quella che ha prodotto l’incidente.
Il contratto minimo di telemetria
Definite il contratto prima della strumentazione. A livello di traccia, registrate identificatore, ora, ambiente, tipo di attività, canale, coorte, versione del flusso, stato finale e un risultato di business quando disponibile. A livello di intervallo, registrate tipo di operazione, stato, durata, numero di tentativo, dipendenze e attributi che consentano di confrontare configurazioni. Usate un vocabolario controllato per stati quali successo, errore tecnico, errore di validazione, rifiuto sicuro, annullamento e timeout.
Per una chiamata al modello, gli attributi minimi comprendono fornitore o famiglia del modello, versione o alias risolto quando disponibile, parametri che modificano materialmente l’output, identificatore del template, token di input e output, e costo calcolato oppure dati sufficienti per calcolarlo in base alla tariffa vigente. Per il recupero, includete indice o raccolta versionata, strategia, filtri, numero di candidati e documenti selezionati mediante identificatori non sensibili.
Gli strumenti richiedono nome e versione, operazione richiesta, codice di risultato, classe di errore, durata e idempotenza oppure chiave di correlazione se eseguono azioni. Per le validazioni, registrate nome e versione della regola, risultato e categoria di errore. Non confondete un JSON sintatticamente valido con una risposta accettabile per il business: sono segnali distinti.
Il contratto deve documentare ciò che viene escluso. Per impostazione predefinita, evitate prompt, risposte, documenti recuperati, argomenti completi degli strumenti, e-mail, numeri di telefono, indirizzi, segreti, token di accesso e qualsiasi dato non indispensabile per la diagnosi. Quando il testo è necessario per un debug autorizzato, applicate minimizzazione, mascheramento, controlli di accesso e una conservazione differenziata.
Campi e decisione di registrazione
| Campo | Uso diagnostico | Trattamento consigliato |
|---|---|---|
| trace_id e span_id | Ricostruire la sequenza | Registrare |
| Versione di modello, prompt e flusso | Confrontare le modifiche | Registrare |
| Token, durata e stato | Misurare costo e prestazioni | Registrare |
| ID del documento recuperato | Esaminare la pertinenza | Registrare senza contenuto per impostazione predefinita |
| Testo utente o risposta | Analizzare casi concreti | Escludere o minimizzare; accesso limitato |
| Credenziali e segreti | Non offrono una diagnosi legittima | Non registrare |
Come misurare il costo reale per interazione
Il costo per interazione non equivale al costo medio di una chiamata principale. Sommate le chiamate al modello in input e output, i tentativi, le chiamate a strumenti con fatturazione propria, il recupero se genera una spesa attribuibile e i passaggi falliti. Mantenete distinto il costo osservato da una stima: il primo deriva dai dati di utilizzo e dai prezzi applicati; la seconda può dipendere da tariffe, arrotondamenti o informazioni incomplete.
Attribuite ogni componente alla medesima traccia e conservate valuta, data di calcolo e versione del listino oppure del metodo di stima. Questa precauzione è importante perché una variazione di prezzo, modello o modalità di elaborazione può rendere due periodi non direttamente confrontabili. Se per un componente non esiste un costo verificabile, contrassegnatelo come sconosciuto invece di imputare zero.
Misurate distribuzioni, non solo medie. Una media stabile può nascondere una coda di interazioni con numerosi tentativi o contesti eccessivi. Segmentate per attività, canale, versione e risultato finale. Il costo di un’esecuzione che termina con errore resta un costo operativo e deve comparire sia nel totale sia nell’analisi dello spreco.
Quando interviene una revisione umana, è preferibile registrarla come costo o sforzo operativo distinto, con un metodo di stima esplicito. Mescolarla alla spesa di inferenza può nascondere che un’ottimizzazione della latenza abbia trasferito lavoro alle persone.
Calcolo verificabile del costo per traccia
- 01Raggruppare tutti gli intervalli figli per trace_id, inclusi quelli conclusi con errore o annullamento.
- 02Sommare il costo dei token per chiamata usando la tariffa e la data applicabili; conservare la fonte del calcolo come attributo interno.
- 03Aggiungere i costi attribuibili di strumenti e recupero senza sostituire i valori sconosciuti con zero.
- 04Separare costo di inferenza, infrastruttura attribuibile e revisione umana stimata.
- 05Pubblicare totale, componenti, percentuale di esecuzioni fallite con costo e percentili per coorte.
Separare le fonti di latenza
La latenza end-to-end è il tempo percepito da chi usa l’applicazione, ma non indica quale componente vada corretto. Registrate intervalli per coda o ammissione, preparazione del contesto, recupero, chiamate al modello, rete quando osservabile, strumenti, tentativi, validazione e serializzazione dell’output. La somma potrebbe non coincidere esattamente con il totale in presenza di operazioni parallele; per questo va registrata anche la relazione temporale tra gli intervalli.
Confrontate i percentili di durata per fase e non soltanto il valore medio totale. Un aumento del percentile alto degli strumenti, con latenza del modello stabile, indirizza l’indagine verso una dipendenza esterna. Un incremento del recupero può dipendere da un indice, un filtro o dalla crescita dei candidati. Una risposta lenta causata da tentativi richiede di esaminare sia la condizione che li attiva sia la relativa politica di limite.
Evitate attribuzioni semplicistiche. Il fatto che una traccia contenga una chiamata al modello non dimostra che il modello sia stato il collo di bottiglia. L’evidenza adeguata è una distribuzione temporale segmentata per stessa versione, tipo di attività e condizioni confrontabili. Cambiamenti di traffico, contenuto o composizione degli utenti sono fattori confondenti che devono essere annotati.
Segnali di qualità in produzione e loro limiti
La qualità non deve essere ridotta a un solo punteggio. Il feedback degli utenti riflette l’esperienza percepita, ma può essere scarso, distorto verso casi estremi o privo di contesto. La revisione umana consente di applicare criteri definiti e rilevare errori sottili, ma comporta costi e copertura limitata. Le regole deterministiche sono riproducibili per requisiti verificabili, come uno schema o un’autorizzazione, ma non colgono da sole utilità, accuratezza fattuale o adeguatezza contestuale.
I valutatori automatici possono aiutare a dare priorità ai campioni e seguire le tendenze, se sono versionati, calibrati rispetto alla revisione umana e usati con limiti espliciti. Non costituiscono una prova indipendente di verità, soprattutto quando valutano attività ambigue o condividono bias con il sistema valutato. Registrate versione, input disponibile, criterio, risultato e livello di confidenza, se prodotto dal metodo.
Collegate tutti i segnali alla traccia e distinguetene chiaramente la provenienza. Un calo dei giudizi positivi non equivale a una regola di business violata; un output con JSON valido non dimostra che i suoi valori siano corretti. Il pannello deve permettere di osservare ogni segnale separatamente e quindi esaminare convergenze o divergenze.
Campionate anche casi senza feedback, oltre a quelli negativi. Altrimenti il team impara da chi segnala problemi, ma non dagli errori silenziosi. Il disegno del campione deve essere documentato: popolazione, periodo, strati, dimensione e criterio di revisione.
Interpretazione dei segnali di qualità
| Segnale | Cosa apporta | Limite principale |
|---|---|---|
| Feedback utente | Esperienza percepita | Copertura e distorsione delle risposte |
| Revisione umana | Giudizio contestuale con rubrica | Costo e variabilità fra revisori |
| Regola deterministica | Conformità riproducibile | Copre soltanto condizioni definite |
| Valutatore automatico | Monitoraggio e definizione delle priorità | Richiede calibrazione e può sbagliare |
Diagnosi di quattro incidenti frequenti
Una risposta inventata va indagata dal risultato a ritroso. Verificate se l’attività richiedeva fondamento, se era presente contesto recuperato, quali documenti sono stati selezionati, quali istruzioni sull’uso delle fonti si applicavano e se una regola o una revisione abbia rilevato affermazioni non supportate. Se configurazione del recupero o versione del prompt non sono state registrate, la causa può restare indeterminata; non attribuite il fallimento al modello per esclusione.
In presenza di contesto irrilevante, confrontate query normalizzata, filtri, raccolta versionata, strategia, numero di candidati e selezione finale. Il problema può riguardare indicizzazione, filtri, metadati, modifiche del corpus o strategia di ranking. La scarsa pertinenza può anche nascere dal fatto che la richiesta sia stata classificata nell’attività errata prima del recupero delle informazioni.
Per un JSON non valido, separate il livello sintattico da quello semantico. Esaminate lo schema richiesto, il metodo di output strutturato, la versione del parser, i tentativi e la risposta di validazione. Un tentativo riuscito può nascondere un tasso crescente di prime risposte non valide e aumentare costo e latenza.
Di fronte a un’azione di strumento fallita, determinate se lo strumento sia stato chiamato, se abbia ricevuto argomenti consentiti, se la dipendenza abbia risposto, se si sia verificato un timeout e se vi siano stati effetti parziali. Le azioni con conseguenze devono incorporare chiavi di idempotenza, stati di conferma e limiti di tentativo. Una risposta finale soddisfacente non prova che l’azione sia stata eseguita.
Procedura di indagine sugli incidenti
- 01Delimitare l’incidente per periodo, coorte, attività e risultato; conservare l’identificatore di traccia di un campione rappresentativo.
- 02Confrontare le tracce interessate con un gruppo precedente o di controllo confrontabile, senza mescolare canali o attività differenti.
- 03Individuare il primo intervallo anomalo ed esaminarne versioni, stato, durata, tentativi e dipendenze.
- 04Verificare l’ipotesi rispetto a segnali di qualità, regole di business e risultati dello strumento.
- 05Applicare una mitigazione reversibile, verificarne l’effetto nella coorte e documentare evidenza e incertezze residue.
Avvisi, soglie e decisioni di arresto
Un avviso utile specifica metrica, finestra, segmento, soglia, responsabile, evidenza richiesta e azione iniziale. «La qualità cala» non soddisfa questo criterio. Una formulazione operativa potrebbe monitorare l’aumento degli errori di validazione di una versione specifica in una finestra definita, richiedere tracce campione e assegnare una revisione alla persona responsabile del flusso.
Usate le soglie come regole di attenzione, non come prova di causalità. Devono basarsi su una baseline del servizio stesso e riviste quando cambiano volume, composizione delle attività o prodotto. Combinate avvisi di disponibilità e sicurezza con la revisione di qualità e costo: ottimizzare una metrica isolata può peggiorarne un’altra.
Fermate, ripristinate o limitate una modifica quando viola una condizione di sicurezza, una regola critica di business o un limite economico concordato, oppure quando l’evidenza mostra un degrado rilevante rispetto a una coorte confrontabile. Negli altri casi, riducete l’esposizione mediante rilasci graduali e aumentate il campionamento prima di trarre conclusioni.
Le fonti fornite raccomandano di mettere in relazione prestazioni, costo e qualità e di confrontare versioni o ambienti. La scelta concreta delle soglie non è definita universalmente in tali fonti; deve derivare dai rischi, dalla baseline e dagli impegni di servizio.
Modello di avviso
| Caso | Metrica e finestra | Azione iniziale |
|---|---|---|
| Costo anomalo | Costo per traccia e percentile alto per versione | Limitare la coorte ed esaminare i tentativi |
| Output non valido | Tasso di fallimento della validazione per flusso | Ripristinare parser o configurazione se il contratto è interessato |
| Strumento fallito | Errori e timeout per dipendenza | Attivare un degrado sicuro ed esaminare gli effetti parziali |
| Qualità degradata | Regole non rispettate e campione umano confrontabile | Sospendere l’espansione e confrontare con il controllo |
Conservazione, minimizzazione e accesso
Una traccia dettagliata può trasformarsi in un archivio sensibile se viene progettata senza limiti. Partite dalla domanda diagnostica e registrate soltanto gli attributi necessari per rispondervi. Identificatori pseudonimizzati, hash con gestione adeguata e categorie di errore apportano spesso più valore operativo della memorizzazione indiscriminata di prompt, risposte o documenti completi.
Separate i dati operativi dai dati per il debug eccezionale. I primi possono includere durate, versioni, contatori, stati e riferimenti tecnici; i secondi, se giustificati, richiedono accesso limitato, mascheramento, registrazione degli accessi e una breve conservazione definita. Esaminate inoltre quali dati le librerie di strumentazione inviano a terze parti prima di abilitarle.
Definite chi può consultare le tracce, chi può accedere al contenuto eccezionale e chi può modificare regole di redazione o conservazione. Le richieste di eliminazione, gli obblighi normativi e le politiche interne possono variare in base a giurisdizione e caso d’uso. Questa guida non determina obblighi legali; è necessaria una valutazione applicabile al contesto dell’organizzazione.
La documentazione fornita di New Relic menziona filtri per scartare dati sensibili prima dell’invio. Questo fatto supporta la fattibilità tecnica del filtraggio, ma non dimostra che una configurazione specifica sia sufficiente per tutte le categorie di dati né per tutti i quadri normativi.
Modello finale per il rilascio e pannello minimo
Prima di rilasciare una versione, verificate che ogni esecuzione possa essere collegata a una versione immutabile di flusso, prompt, modello, recupero, strumenti e validazioni. Controllate che i tentativi compaiano come intervalli o attributi distinguibili, che token e costi siano attribuiti a tutti i tentativi e che i risultati di business non vengano confusi con errori tecnici.
Il pannello minimo deve combinare volume di tracce, tasso degli stati finali, latenza totale e per fase, token e costo per interazione, tentativi, risultati delle validazioni, errori degli strumenti e segnali di qualità distinti per origine. Tutti i grafici devono ammettere filtri per periodo, ambiente, versione, attività, canale e coorte, per evitare confronti fra popolazioni eterogenee.
Per il rilascio, selezionate una coorte di controllo o una baseline precedente e definite in anticipo le condizioni per espandere, sospendere e ripristinare. Conservate campioni di tracce rappresentative, incluse esecuzioni riuscite, fallite e ad alto costo. Documentate cambiamenti di traffico, corpus, prezzi o politiche che potrebbero modificarne l’interpretazione.
Il risultato atteso non è una spiegazione automatica per ogni incidente. È un sistema che riduce la dipendenza da ricordi, screenshot e impressioni isolate, e che mostra esplicitamente quando l’evidenza consente una conclusione e quando non è ancora sufficiente.
Checklist di rilascio
- 01Assegnare versioni immutabili a modello, prompt, recupero, strumenti, validazione e flusso.
- 02Eseguire tracce di prova che coprano successo, tentativo, fallimento di uno strumento, rifiuto della validazione e annullamento.
- 03Verificare che costo, token e latenza siano scomposti per fase e conservati nei tentativi falliti.
- 04Verificare filtri per dati sensibili, autorizzazioni di accesso e politica di conservazione.
- 05Definire coorte di controllo, responsabili degli avvisi, soglie rivedibili e condizione di ripristino.
- 06Esaminare un campione umano e documentare le incertezze prima di ampliare il rilascio.
Questioni aperte
- Le fonti fornite sono in larga parte guide editoriali o casi di implementazione; non definiscono uno standard universale per schema, soglie o conservazione.
- Non vengono forniti dati comparativi indipendenti per stabilire valori concreti di avviso, obiettivi di qualità o costi accettabili.
- L’URL del caso Buk contiene una data futura rispetto ad alcuni possibili contesti di pubblicazione; viene usato unicamente come materiale fornito sulle pratiche descritte, non per dedurre attualità o adozione generale.
- Gli obblighi relativi a privacy, sicurezza e conservazione dipendono da giurisdizione, dati trattati e contesto organizzativo e non possono essere determinati dalle fonti fornite.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione