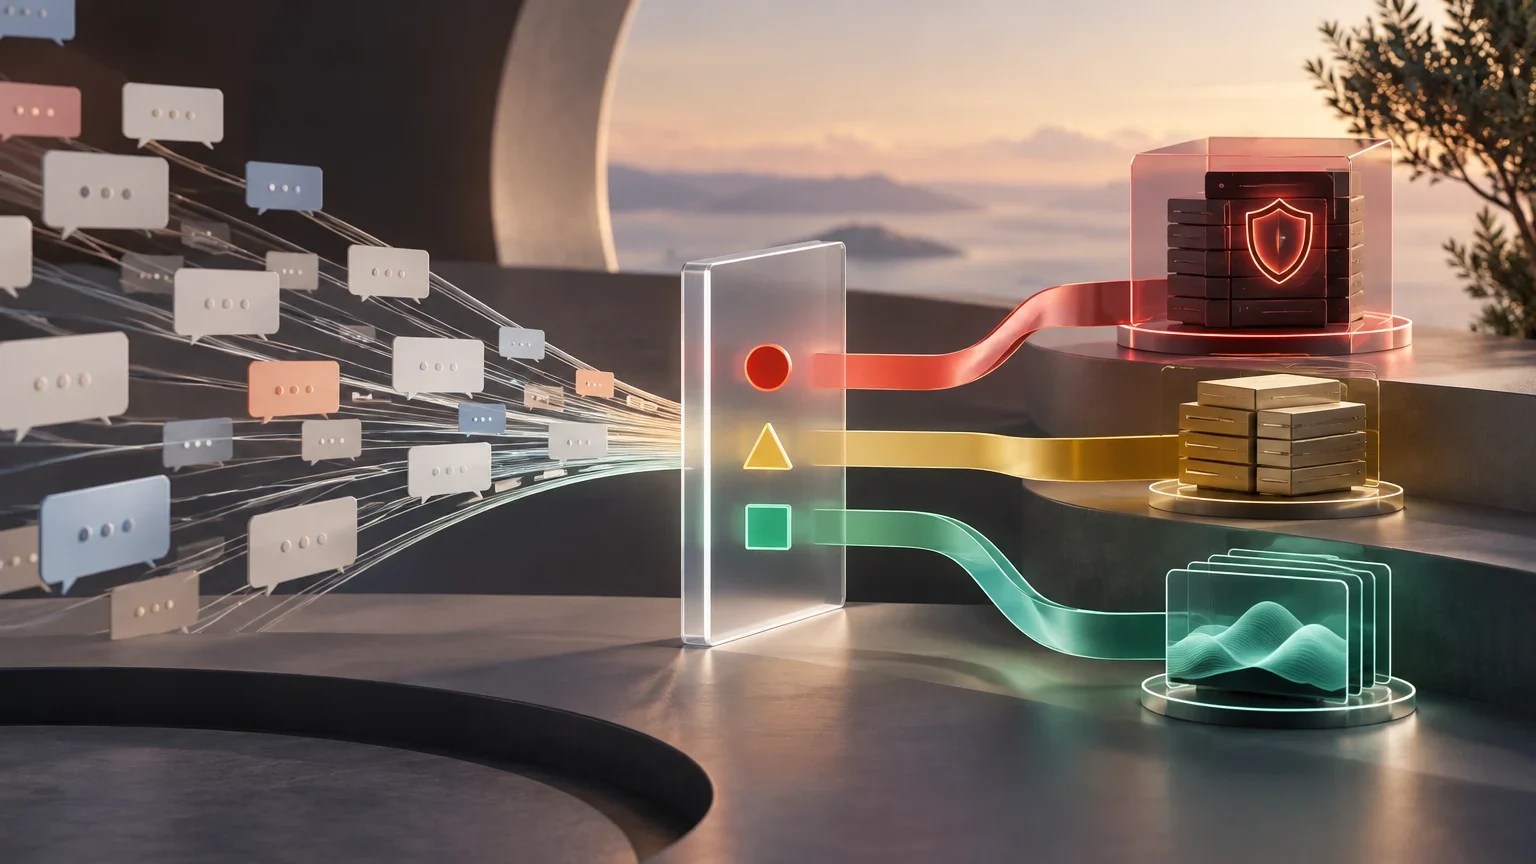
Le problème du service client comme cas d'usage à fort volume
Le service client se caractérise par un volume élevé d'interactions répétitives et une marge d'erreur qui varie considérablement selon le type de demande. Les équipes opérationnelles font face au défi d'équilibrer l'efficacité opérationnelle et la qualité de la réponse, un défi que l'intelligence artificielle conversationnelle aborde grâce au traitement du langage naturel et à l'apprentissage automatique.
Selon des données de l'IBM Institute for Business Value, les dirigeants anticipent une augmentation de 53 % de l'utilisation de l'IA pour favoriser l'auto-service personnalisé et une amélioration de 47 % de la résolution des appels d'auto-service d'ici 2027. Cette tendance indique un déplacement vers l'automatisation, mais nécessite une architecture qui n'applique pas la même technologie à tous les cas, mais qui l'adapte à la nature de l'interaction.
L'adoption de l'intelligence artificielle dans le service client ne se limite pas à une simple modernisation des outils, mais implique une restructuration profonde des flux de travail existants. Les équipes opérationnelles doivent repenser la manière dont les interactions sont triées, routées et résolues, en intégrant des capacités d'analyse sémantique qui permettent de comprendre la nuance derrière chaque demande. Cette transformation nécessite une collaboration étroite entre les équipes techniques et les responsables métier pour s'assurer que les modèles d'apprentissage automatique sont alignés sur les objectifs de service et les contraintes opérationnelles réelles du terrain.
La variabilité du volume d'interactions, souvent marquée par des pics saisonniers ou des événements imprévus, ajoute une couche de complexité à la gestion de la capacité. Une architecture rigide, incapable de s'adapter à ces fluctuations, risque de générer des goulots d'étranglement qui dégradent l'expérience client. L'intelligence artificielle conversationnelle offre ici une flexibilité précieuse en permettant une montée en charge dynamique des ressources de calcul, garantissant ainsi que la qualité de la réponse reste constante même lors des périodes de forte demande, sans nécessiter de surdimensionnement permanent de l'infrastructure.
Classification des interactions : transactionnelles, informatives et résolutives
Pour appliquer le protocole de décision, il est d'abord nécessaire de catégoriser les interactions en trois blocs fonctionnels. Les interactions transactionnelles impliquent une action concrète et déterministe, comme un réinitialisation de mot de passe, la consultation de l'état d'une commande ou la confirmation d'un paiement. Leur logique est binaire et n'admet aucune ambiguïté.
Les interactions informatives cherchent une réponse basée sur une base de connaissances, comme la politique de retour ou les spécifications d'un produit. Ici, l'intention de l'utilisateur peut varier, mais la réponse doit être factuelle et vérifiable. Les interactions résolutives sont les plus complexes : litiges de facturation, plaintes pour mauvais service ou demandes d'indemnisation. Elles nécessitent de l'empathie, du contexte et une capacité de négociation, où l'erreur a un coût réputationnel et économique élevé.
La distinction entre ces trois blocs fonctionnels n'est pas toujours nette dans la pratique, car une interaction peut évoluer au fil de la conversation. Un client qui commence par une demande transactionnelle simple, comme la vérification d'un statut de commande, peut rapidement basculer vers une interaction résolutive si le statut révèle un retard ou une erreur. Cette capacité de transition dynamique est cruciale pour l'architecture technique, qui doit être conçue pour détecter le changement d'intention et réaffecter le traitement en temps réel, passant d'un moteur de règles déterministes à un modèle génératif capable de gérer la complexité émotionnelle et contextuelle de la situation.
Les interactions informatives, bien que semblant plus simples, posent des défis spécifiques liés à la fraîcheur et à la précision des données. La base de connaissances doit être maintenue à jour en permanence pour éviter que le système ne fournisse des informations obsolètes, ce qui pourrait induire le client en erreur. La vérifiabilité de la réponse est donc un impératif, nécessitant des mécanismes de traçabilité qui permettent de remonter à la source exacte de l'information fournie, renforçant ainsi la confiance de l'utilisateur dans la fiabilité du service automatisé.
Typologie des interactions en support
Classification des demandes selon leur nature et leur complexité technique.
| Type d'interaction | Exemple concret | Nature de la réponse | Coût de l'erreur |
|---|---|---|---|
| Transactionnelle | Réinitialisation de mot de passe | Action déterministe (oui/non) | Faible (nouvelle tentative possible) |
| Informatif | Politique de retour | Extraction de connaissances | Moyen (confusion du client) |
| Résolutive | Litige de facturation | Négociation et empathie | Élevé (insatisfaction et churn) |
Protocole de décision : assignation de l'architecture technique
Le protocole assigne la technologie la plus efficace à chaque type d'interaction. Pour le transactionnel, les règles déterministes sont l'option optimale. Elles sont rapides, peu coûteuses et ne échouent pas si la logique est bien définie. Un chatbot traditionnel basé sur des règles ou un système de réponse vocale interactive (IVR) amélioré par l'IA peut gérer ces flux sans besoin de modèles complexes.
Pour l'informatif, un modèle de classification supervisée ou un système de récupération augmentée par génération (RAG) est plus approprié. Ces systèmes analysent l'intention de l'utilisateur et récupèrent la bonne réponse d'une base de connaissances, réduisant le risque d'inventer des informations. Pour le résolutif, les LLM génératifs ou les agents d'IA sont nécessaires pour gérer l'imprévisibilité de la conversation, mais doivent opérer sous une supervision humaine stricte.
L'implémentation de ce protocole de décision exige une phase de calibration rigoureuse pour définir les seuils de basculement entre les différentes architectures. Il est essentiel de tester les modèles de classification sur des jeux de données représentatifs des interactions réelles afin de minimiser les erreurs de catégorisation. Une erreur de classification, par exemple le routage d'une interaction résolutive vers un moteur de règles déterministes, peut avoir des conséquences graves, car le système ne sera pas en mesure de fournir la réponse empathique et contextuelle attendue, entraînant une frustration immédiate du client et une escalade vers un agent humain avec un niveau d'agacement déjà élevé.
La supervision humaine dans le flux résolutif ne se limite pas à une intervention en cas de litige, mais inclut également la formation continue des modèles génératifs. Les retours des agents humains sur la qualité des réponses proposées par l'IA servent de signal d'entraînement pour affiner les futurs comportements du modèle. Cette boucle de rétroaction est fondamentale pour s'assurer que l'IA évolue en parallèle des changements de politique commerciale ou des nouvelles réglementations, maintenant ainsi une cohérence entre les réponses automatisées et les standards de service définis par l'organisation.
Flux d'assignation de la technologie
Étapes pour déterminer l'architecture selon le type de demande.
- 01Identifier l'intention principale de l'utilisateur (transactionnelle, informative ou résolutive).
- 02S'il s'agit d'une interaction transactionnelle, router vers des règles déterministes ou l'automatisation des processus.
- 03S'il s'agit d'une interaction informative, consulter la base de connaissances via la classification ou le RAG.
- 04S'il s'agit d'une interaction résolutive, activer un LLM génératif avec accès au contexte et aux outils d'action.
- 05Évaluer le niveau de risque réglementaire de l'action proposée par l'IA.
Calcul du point d'équilibre et coût de l'erreur
La décision d'automatiser ne dépend pas seulement de la technologie, mais de l'économie de l'erreur. Le point d'équilibre est atteint lorsque le coût de la révision humaine par ticket dépasse la somme du coût d'inférence de l'IA et du coût attendu des erreurs non détectées. Dans les interactions transactionnelles, le coût de l'erreur est faible, ce qui justifie l'automatisation totale. Dans les interactions résolutives, le coût d'une erreur (perte de client, indemnisation) est élevé, ce qui exige une assistance humaine ou une révision préalable.
Pour estimer ce point, les équipes doivent mesurer le coût moyen de la révision humaine (temps de l'agent par ticket) et le comparer au coût d'inférence du modèle. Si le modèle de classification a une précision de 95 % et que le coût de révision des 5 % restants est inférieur au coût d'inférence d'un LLM pour 100 % des cas, l'architecture hybride est plus efficace.
Le calcul du point d'équilibre doit intégrer non seulement les coûts directs de l'infrastructure et de la main-d'œuvre, mais aussi les coûts indirects liés à la complexité de la maintenance. Les systèmes hybrides, qui combinent des règles déterministes et des modèles génératifs, nécessitent une surveillance plus étroite pour s'assurer que les interfaces entre les différents composants fonctionnent correctement. Cette complexité opérationnelle doit être pondérée dans l'analyse coût-bénéfice, car un système trop complexe peut devenir difficile à maintenir et à mettre à jour, augmentant le risque de bugs ou d'incohérences dans le temps.
La mesure de la précision des modèles de classification est un indicateur clé, mais elle doit être interprétée dans le contexte du coût de l'erreur spécifique à chaque type d'interaction. Une précision de 95 % peut être acceptable pour un triage de tickets informatifs, où l'erreur se limite à une redirection incorrecte, mais elle peut être insuffisante pour des interactions résolutives impliquant des décisions financières. Les équipes doivent donc définir des seuils de performance différenciés selon la criticité de l'interaction, ajustant la stratégie d'automatisation en conséquence pour maximiser l'efficacité globale du service client.
Limites réglementaires et supervision humaine
La mise en œuvre de l'IA dans le service client est soumise à la Loi sur l'IA de l'Union européenne. La classification du risque ne dépend pas de la technologie, mais de la finalité et de l'impact. Un chatbot qui répond uniquement aux questions fréquentes est à risque limité, mais un système qui évalue la performance des agents ou décide automatiquement des remboursements peut être classé à haut risque, activant des obligations de supervision humaine compétente et de documentation technique.
Les directives de la Commission européenne établissent que les systèmes destinés à surveiller ou évaluer le travail des personnes entrent dans l'Annexe III à haut risque. Par conséquent, la supervision humaine n'est pas optionnelle dans certains flux : il doit y avoir une personne désignée avec l'autorité de mettre le système en pause et de revoir les décisions. De plus, l'article 50 exige que l'utilisateur sache qu'il interagit avec une IA, une obligation de transparence qui doit être vérifiée dans la configuration du chatbot.
La conformité à la Loi sur l'IA de l'Union européenne n'est pas un simple exercice administratif, mais un pilier de la conception technique des systèmes de service client. Les obligations de documentation technique exigent que les équipes soient en mesure de fournir des preuves claires de la manière dont les décisions sont prises, y compris les données utilisées pour l'entraînement des modèles et les critères de pondération appliqués. Cette transparence est essentielle pour permettre aux autorités de régulation d'auditer les systèmes et pour rassurer les utilisateurs sur le fait que leurs données sont traitées de manière éthique et responsable.
La désignation d'une personne responsable de la supervision humaine doit être accompagnée de la formation adéquate pour comprendre les limites et les biais potentiels des systèmes d'IA. Cette personne doit avoir l'autorité et les outils nécessaires pour intervenir dans le processus décisionnel, que ce soit pour corriger une erreur, suspendre une opération ou ajuster les paramètres du modèle. Cette gouvernance humaine est le dernier rempart contre les défaillances techniques ou éthiques, garantissant que l'automatisation reste au service de l'humain et non l'inverse, dans le cadre d'une relation client durable et de confiance.
Niveaux de risque réglementaire dans le service client
Classification selon la Loi sur l'IA et obligations associées.
| Système d'IA | Niveau de risque | Obligation principale |
|---|---|---|
| Chatbot de première ligne | Limité | Avis d'IA à l'utilisateur (Art. 50) |
| Triage et routage des tickets | Minime | Inventaire et conformité RGPD |
| Tableaux de bord d'évaluation des agents | Élevé | Supervision humaine, FRIA et dossier technique |
Questions ouvertes
- Le coût exact d'inférence par token varie selon le fournisseur et le modèle, donc le point d'équilibre doit être calculé avec des données internes de l'entreprise.
- L'application spécifique de la Loi sur l'IA à certains flux d'« agent assist » peut varier selon l'interprétation des autorités nationales jusqu'à la publication des directives finales.
- Le taux d'erreur acceptable pour une interaction transactionnelle n'est pas standardisé et dépend de la tolérance au risque de chaque organisation.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction