Cosa annuncia OpenAI per GPT‑6
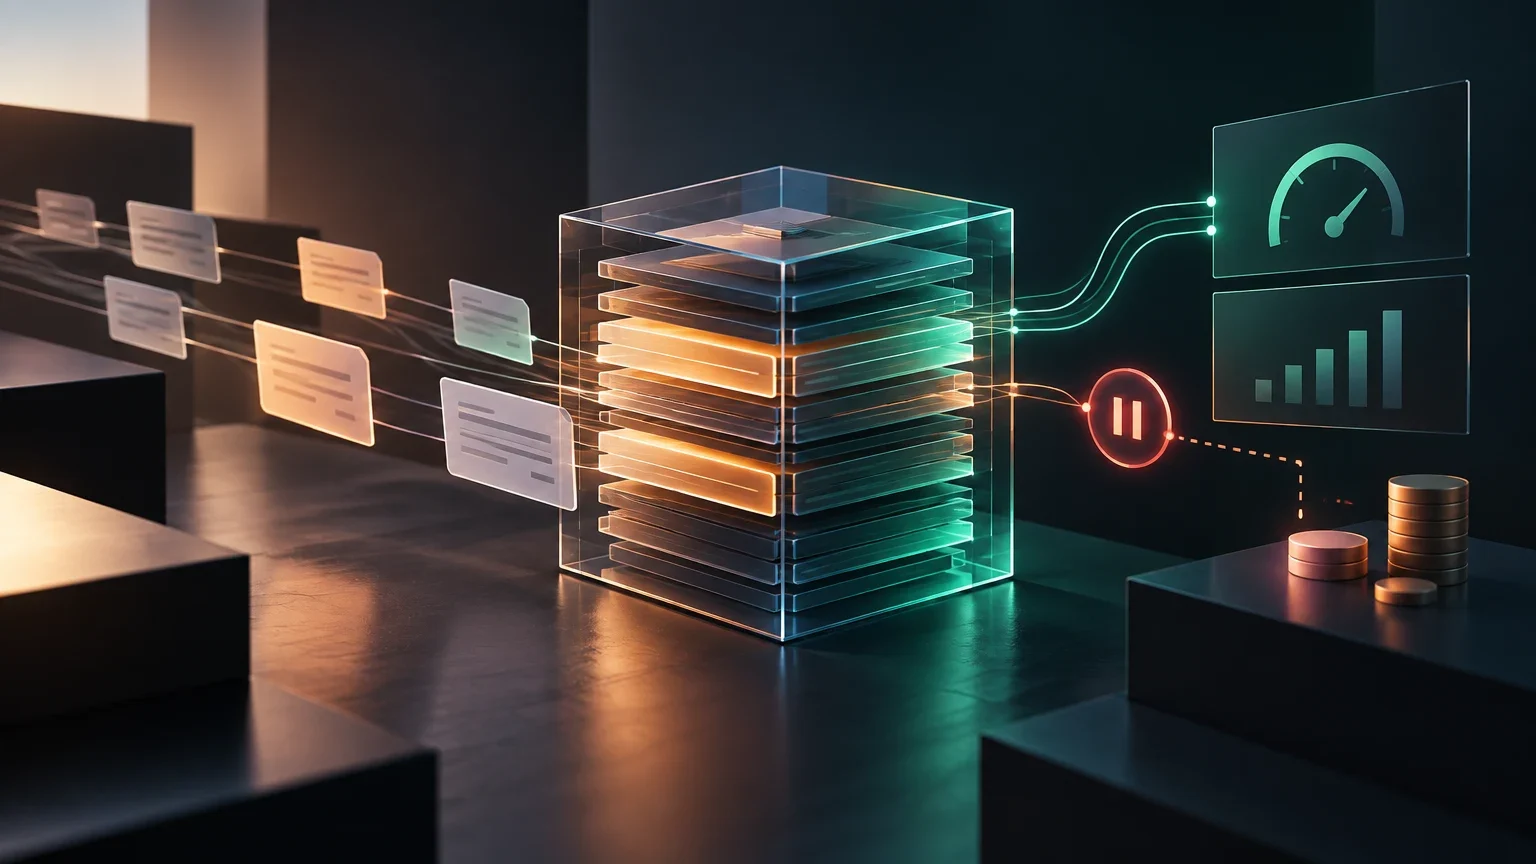
OpenAI ha annunciato un aggiornamento della cache dei prompt per GPT‑6 che comprende una maggiore percentuale di cache hit, nuovi strumenti di diagnostica e punti di interruzione espliciti. L’azienda presenta questi controlli come un modo per ridurre latenza e costi in alcuni utilizzi dell’API. Si tratta dell’obiettivo dichiarato della modifica, non di un risultato garantito per ogni applicazione: il beneficio dipende dalla presenza di parti riutilizzabili tra le richieste e da come queste sono organizzate.
Il changelog dell’API colloca il rilascio di GPT‑6 Sol e GPT‑6 Luna nell’API al 22 settembre 2026. Tuttavia, le informazioni disponibili nelle fonti consultate non precisano quali endpoint supportino ciascun controllo né riportano tutti i requisiti di disponibilità. Prima di modificare un’integrazione, è quindi opportuno verificare il modello e l’endpoint specifici nella documentazione aggiornata.
Per chi gestisce un servizio, la novità importante non è soltanto l’esistenza di una cache. Conta poter osservare meglio se il prefisso di una richiesta viene riutilizzato e definire con maggiore precisione dove termina una parte che si desidera conservare. Questi strumenti possono aiutare a diagnosticare una configurazione, ma non sostituiscono i test di carico né un confronto dei costi effettivamente fatturati.
Cache hit, diagnostica e punti di interruzione
In termini pratici, una cache hit significa che una richiesta può riutilizzare contenuti di input già elaborati invece di doverli processare nuovamente da zero. Il riutilizzo dipende dalla corrispondenza tra le parti pertinenti del prompt e dal rispetto delle regole di caching del modello e dell’API. Non basta che due richieste abbiano lo stesso scopo: se cambia una sezione che precede il contenuto comune, il prefisso riutilizzabile potrebbe non corrispondere più.
La diagnostica serve a distinguere una cache disponibile da una cache che sta effettivamente aiutando. OpenAI annuncia nuovi strumenti diagnostici, ma le fonti fornite non elencano in modo esaustivo ogni campo, la sua definizione o il modo in cui viene presentato per ciascun endpoint. L’approccio prudente è considerarli indicatori operativi e consultare la guida aggiornata per capire esattamente cosa misura ciascun campo prima di usarlo per creare avvisi o report.
I punti di interruzione espliciti consentono di indicare dove separare segmenti del contesto per controllare il riutilizzo. In un’integrazione, questo può aiutare a mantenere distinguibile un prefisso stabile — per esempio, istruzioni condivise — dal contenuto variabile, come la domanda di ciascun utente. La guida di OpenAI relativa a GPT‑5.6 descrive punti di interruzione deterministici all’interno della finestra di contesto. È un riferimento utile, ma non dimostra che ogni dettaglio di configurazione sia identico in GPT‑6.
La cache, inoltre, non rende qualsiasi prompt più economico o più rapido. Se le richieste ripetono raramente lo stesso prefisso, le opportunità di riutilizzo sono limitate. Se il contenuto comune cambia spesso, la percentuale di cache hit potrebbe restare bassa. E se si modifica la struttura senza misurare il risultato, un miglioramento apparente in un piccolo campione potrebbe non ripetersi con il traffico reale.
Cosa verificare in base al modello delle richieste
| Modello osservato | Cosa verificare | Interpretazione prudente |
|---|---|---|
| Prefisso lungo e stabile, con una domanda variabile in coda | Se le richieste registrano cache hit e se l’ordine del contenuto comune resta invariato | Potrebbe esserci un’opportunità di riutilizzo; misurare prima di attribuire un miglioramento |
| Istruzioni comuni che cambiano spesso | Quali modifiche invalidano la corrispondenza e con quale frequenza vengono introdotte | Il riutilizzo potrebbe essere discontinuo |
| Prompt brevi o quasi sempre diversi | La quota di input riutilizzata e il costo complessivo | La cache potrebbe incidere poco rispetto al costo della richiesta |
| Più versioni di prompt in parallelo | Separare i risultati per versione, modello ed endpoint | Una media complessiva potrebbe nascondere differenze importanti |
Possibili effetti su latenza e costi
La latenza può diminuire quando viene riutilizzata una parte significativa dell’input che, altrimenti, dovrebbe essere elaborata di nuovo. OpenAI osserva che il tempo al primo token, o TTFT, è influenzato in modo rilevante dalle dimensioni del prompt di input non presente in cache e dal ragionamento. Una maggiore percentuale di cache hit potrebbe quindi aiutare alcuni carichi di lavoro, ma da sola non permette di dedurre il tempo totale di risposta: contano anche la lunghezza dell’output, il tipo di richiesta e altri fattori.
Il costo va verificato separatamente. La documentazione di GPT‑5.6 indica che, per quel modello e quelli successivi, le scritture in cache hanno una tariffa diversa rispetto all’input non in cache e le letture ricevono uno sconto. È un riferimento utile per capire che lettura e scrittura in cache non necessariamente hanno lo stesso trattamento. Le tariffe attuali di GPT‑6 devono essere controllate nella documentazione aggiornata dei prezzi, non dedotte dalla pagina di un altro modello.
Di conseguenza, un aumento delle cache hit non equivale automaticamente a una riduzione proporzionale della spesa totale. Il risultato dipende dalla quantità di contenuto riutilizzato, dal rapporto tra letture e scritture, dalle tariffe applicabili e dal volume di token in output. È importante anche confrontare richieste equivalenti: un carico più complesso nel periodo successivo può aumentare la spesa anche se la cache funziona meglio.
Test operativo prima e dopo la modifica
- 01Definisci un periodo di riferimento e registra modello, endpoint, versione del prompt e profilo del traffico.
- 02Annota la percentuale di cache hit e le metriche della cache disponibili per quell’endpoint. Consulta la guida per interpretare ciascun campo.
- 03Misura i token di input fatturati, i token di output e il costo totale applicando le tariffe aggiornate; se l’API lo consente, separa letture e scritture.
- 04Confronta TTFT e latenza totale usando percentili come P50, P75 e P95, non soltanto una media.
- 05Modifica una variabile alla volta — per esempio, la posizione di un punto di interruzione — e ripeti la misurazione su richieste comparabili.
- 06Verifica il comportamento quando cambia il prompt e con il traffico reale prima di estendere la configurazione.
Cosa misurare e cosa verificare prima della produzione
La guida di OpenAI sugli errori e sulla latenza consiglia di osservare percentili come P50, P75 e P95, perché le medie possono nascondere un peggioramento che interessa una parte degli utenti. Indica inoltre che lo stato del servizio può aiutare a individuare quando è cambiato il comportamento. Per valutare la cache, è utile registrare queste metriche insieme alla percentuale di cache hit, ai token fatturati e alla versione del prompt. Analizzare una sola variabile renderebbe difficile spiegare il risultato.
Il confronto dovrebbe usare finestre temporali e gruppi ragionevolmente equivalenti. Se tra i periodi cambiano il traffico, le dimensioni medie dei prompt o la distribuzione delle richieste, non si può attribuire automaticamente alla cache la differenza osservata. Quando possibile, suddividi le richieste per versione, modello ed endpoint e mantieni un gruppo di riferimento. Un test controllato aiuta a distinguere una variazione operativa da un miglioramento dovuto alla configurazione.
Prima di intervenire in produzione, verifica nella documentazione dell’API quali modelli ed endpoint supportano i controlli; quali dati espone esattamente la diagnostica; come vengono definite le cache hit; quali condizioni consentono il riutilizzo di un prefisso; e quali prezzi si applicano alle letture e alle scritture in cache. Controlla anche se i punti di interruzione si configurano manualmente e quale effetto documentato hanno sul riutilizzo. Le fonti disponibili qui non chiariscono tutti questi dettagli specifici di GPT‑6.
Per ora, la valutazione è soprattutto operativa: OpenAI annuncia strumenti pensati per migliorare l’osservabilità e il controllo della cache dei prompt in GPT‑6. È ragionevole testarli quando un’applicazione invia prefissi stabili e costosi da elaborare, ma l’entità — o persino la presenza — di un miglioramento va verificata per ogni carico di lavoro. Sono la documentazione e le misurazioni del servizio stesso a dover determinare se conviene modificare la configurazione.
Fonti e limiti delle informazioni
L’annuncio di OpenAI è la fonte principale per descrivere le novità di GPT‑6. Il changelog consente di verificare la data di rilascio nell’API di GPT‑6 Sol e GPT‑6 Luna. Le guide sulla cache e sulla latenza forniscono contesto tecnico generale; quando descrivono condizioni o prezzi relativi ad altri modelli, non vengono presentate come conferma completa di ogni dettaglio per GPT‑6.
Le informazioni pubbliche consultate non bastano per affermare una cifra universale di risparmio, una riduzione garantita della latenza o la compatibilità di ogni controllo con tutti gli endpoint. Questi aspetti vanno verificati nella documentazione aggiornata e attraverso test rappresentativi del flusso specifico.
Questioni aperte
- Le fonti disponibili non specificano completamente quali modelli ed endpoint supportino ciascun nuovo controllo della cache di GPT‑6.
- Non sono elencati tutti i campi esposti dai nuovi strumenti diagnostici né la definizione operativa esatta di ogni metrica.
- Non vengono forniti dati indipendenti sui risparmi o sulle riduzioni di latenza che si possano generalizzare a diversi carichi di lavoro.
- La descrizione di punti di interruzione deterministici nella guida di GPT‑5.6 non conferma che tutte le opzioni di configurazione siano identiche in GPT‑6.
- Le tariffe attuali per le letture e le scritture in cache di GPT‑6 vanno verificate nella documentazione aggiornata dei prezzi.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione