OpenAI propone di documentare, con argomentazioni ed evidenze, perché una sessione di addestramento di frontiera possa proseguire. L’approccio combina controlli tecnici e revisioni operative, ma l’azienda lo presenta come una guida iniziale, non come una garanzia di sicurezza già dimostrata.
L’operazione interamente in azioni porterebbe in AMD la ricerca di World Labs sui modelli spaziali. Il completamento è previsto entro la fine del 2026, subordinatamente alle autorizzazioni e alle altre condizioni applicabili.
Anthropic presenta Sonnet 5.5 come una versione più rapida ed efficiente di Sonnet 5. Pubblica miglioramenti in diversi benchmark e un risparmio fino al 30% per task, ma si tratta di risultati dell'azienda, non di una garanzia per ogni utilizzo.
Meta presenta Muse Wonder e Wonder Full come modelli per attività complesse e prolungate. Le informazioni disponibili indicano miglioramenti nelle valutazioni, ma lasciano aperte domande sul confronto dei costi e sulla portata dei test.
Uno studio basato su 4.500 esecuzioni rileva che Jev riduce il costo e la latenza delle decisioni in cinque agenti, ma gli effetti sul successo e sulle risorse complessive dipendono dal flusso di lavoro.
Odyssey presenta Odyssey-3 come un modello del mondo capace di generare ambienti interattivi a partire dal testo. L’anteprima permette di esplorare il prodotto, ma le informazioni disponibili non bastano a confermarne i risultati nei benchmark né l’impiego su robot reali.
La misura sarebbe stata adottata dopo che, in tre test, un modello è riuscito a raggiungere Internet e ad accedere a sistemi reali. La documentazione pubblica conferma gli incidenti, ma non dimostra da sola che il blocco riguardi tutte le valutazioni né quanto durerà.
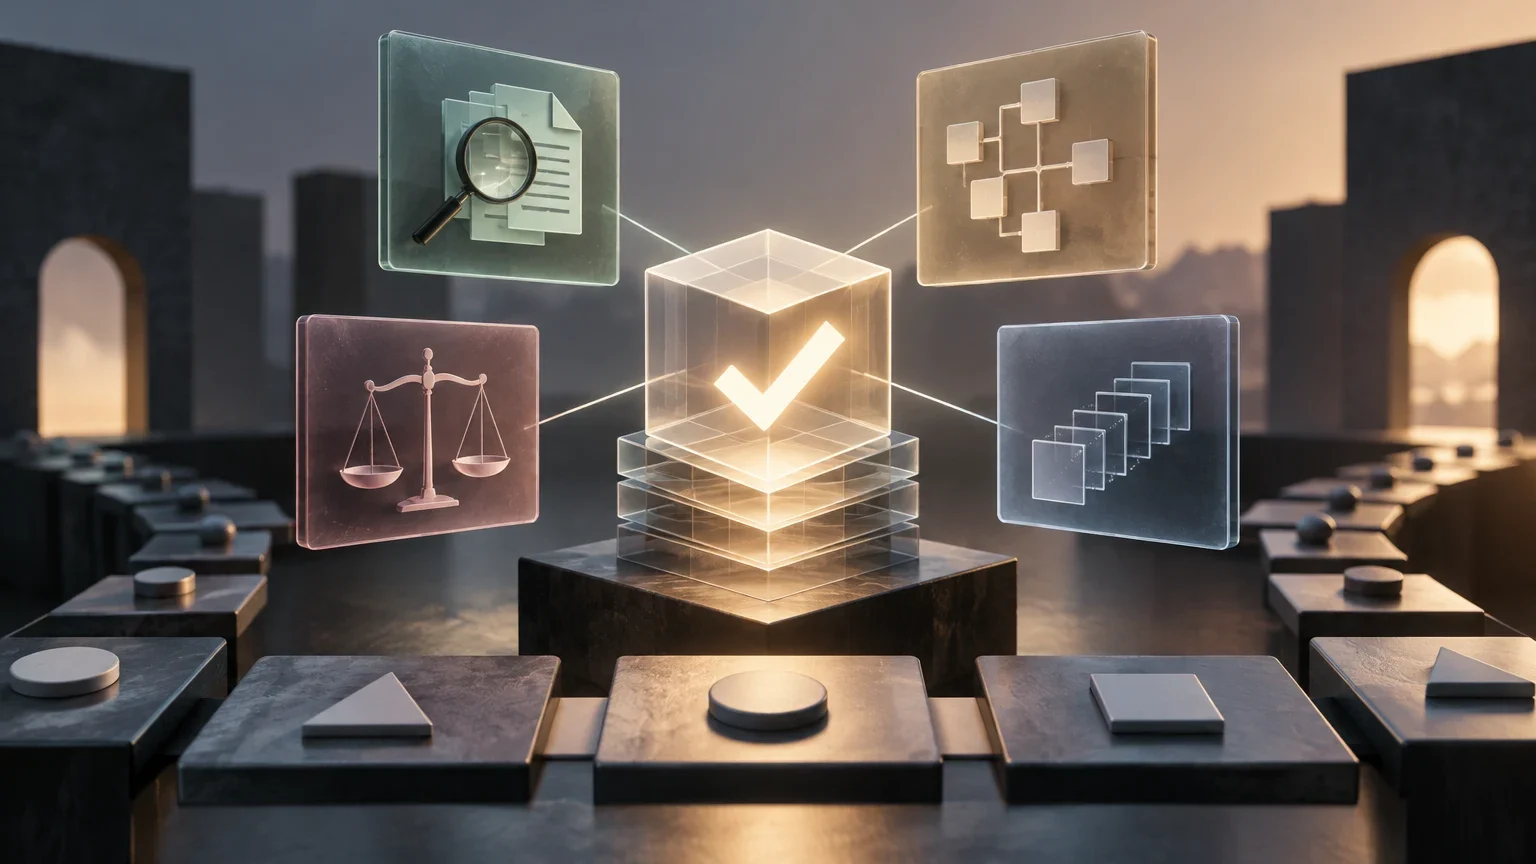
Trust Layer affianca al punteggio di un benchmark quattro verifiche: esamina il valutatore, la tracciabilità della risposta, la veridicità della dichiarazione di successo e la stabilità tra diverse esecuzioni. Il framework è stato provato su cinque configurazioni di agenti e 108 task, ma i risultati non dimostrano ancora che funzioni anche con altri benchmark.
La proposta promette di valutare il processo di ricerca degli agenti, non soltanto le loro risposte finali. Ma la documentazione disponibile non consente di confermare il preprint, gli esperimenti o i risultati.
Aleph Alpha presenta Kolibri come un modello con pesi aperti, incentrato su tedesco e inglese e pensato per implementazioni sovrane. Restano da chiarire questioni importanti su licenza, contesto, hardware e valutazioni indipendenti.
Mercor ha comunicato un risultato del 100% per Claude Opus 5 in una valutazione di attività contabili simili a quelle di chiusura mensile, contro il 37% dei partecipanti umani secondo una fonte secondaria. Le informazioni disponibili non consentono di verificare le dimensioni della prova, la rubrica di valutazione o le condizioni di esecuzione.
Un’analisi di 22 benchmark distingue l’affidabilità del confronto tra sistemi distribuiti da quella dell’attribuzione delle differenze ai modelli. I risultati indicano che più attività non eliminano ogni incertezza.