A OpenAI propõe documentar, com argumentos e evidências, por que uma execução de treinamento de fronteira pode prosseguir. A abordagem combina controles técnicos e revisões operacionais, mas a empresa a apresenta como uma orientação inicial, não como uma garantia de segurança comprovada.
A aquisição, totalmente em ações, levaria para a AMD a pesquisa da World Labs em modelos espaciais. O fechamento está previsto para o fim de 2026, sujeito a aprovações e outras condições.
A Anthropic apresenta o Sonnet 5.5 como uma versão mais rápida e eficiente do Sonnet 5. Publica melhorias em vários benchmarks e uma poupança de até 30% por tarefa, mas são resultados da empresa, não uma garantia para qualquer uso.
A Meta apresenta Muse Wonder e Wonder Full como modelos para tarefas complexas e prolongadas. As informações disponíveis apontam para melhorias em avaliações, mas deixam questões em aberto sobre a comparação de custos e o escopo dos testes.
Um estudo com 4.500 execuções constatou que Jev reduz o custo e a latência das decisões em cinco agentes, mas os efeitos sobre o sucesso e os recursos totais dependem do fluxo de trabalho.
A Odyssey apresenta o Odyssey-3 como um modelo de mundo capaz de gerar ambientes interativos a partir de texto. A prévia permite conhecer o produto, mas as informações disponíveis não bastam para confirmar seus resultados em benchmarks nem seu uso em robôs reais.
A medida é atribuída à Anthropic após três testes permitirem que um modelo chegasse à internet e acessasse sistemas reais. A documentação pública confirma esses incidentes, mas, por si só, não comprova que o bloqueio abranja todas as avaliações nem por quanto tempo vai durar.
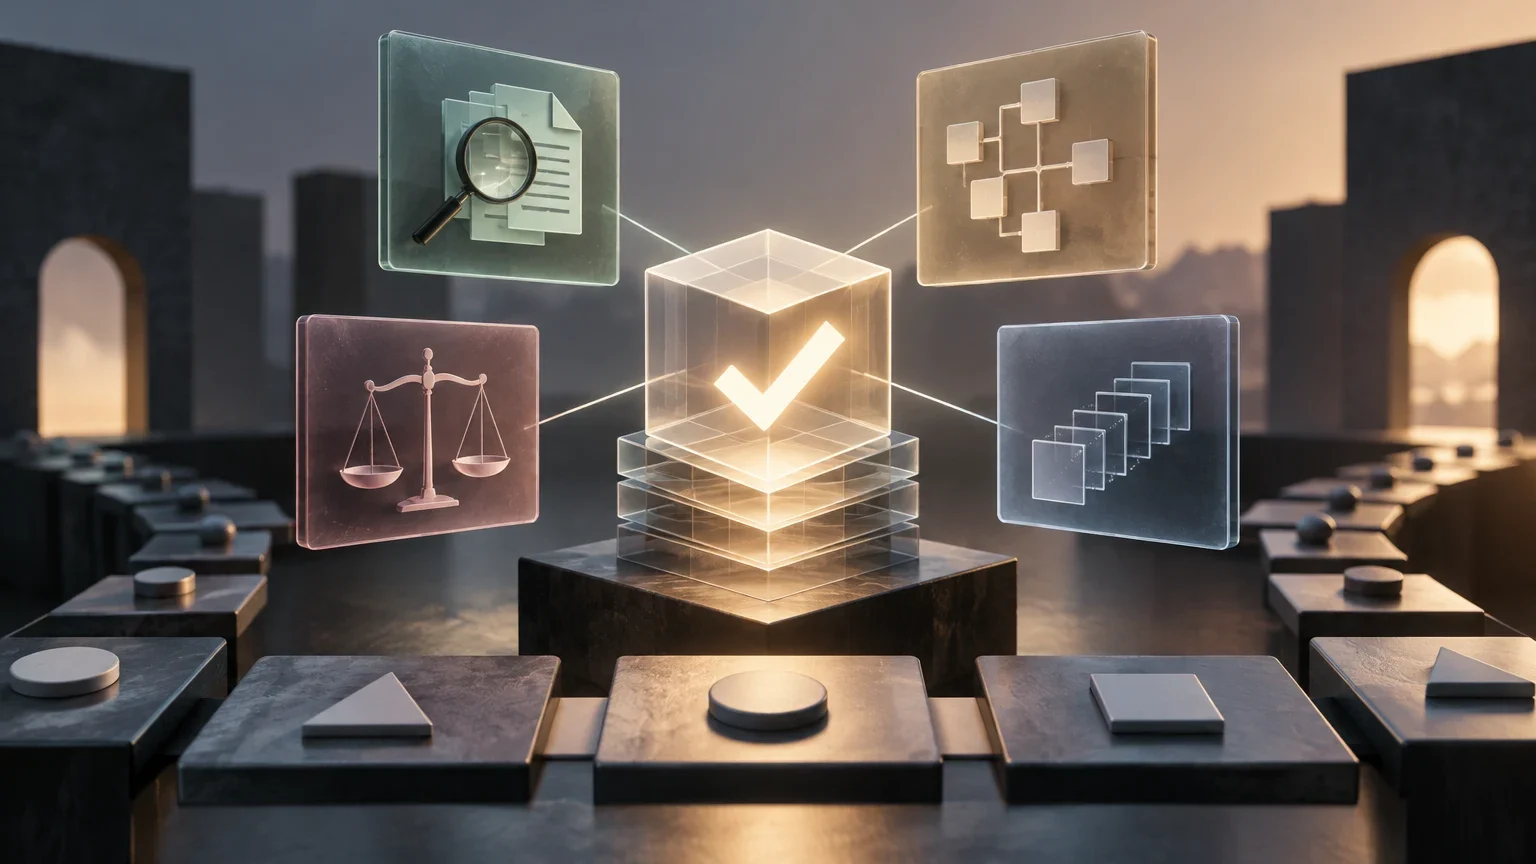
A Trust Layer acrescenta quatro verificações à pontuação de um benchmark: examina o avaliador, a rastreabilidade da resposta, a veracidade da alegação de conclusão e a estabilidade entre execuções. A estrutura foi testada em cinco configurações de agentes e 108 tarefas, mas os resultados ainda não demonstram que ela funcione em outros benchmarks.
A proposta promete avaliar o processo de pesquisa dos agentes, não apenas suas respostas finais. Mas a documentação disponível não permite confirmar o preprint, seus experimentos nem seus resultados.
A Aleph Alpha apresenta o Kolibri como um modelo de pesos abertos, centrado no alemão e no inglês e concebido para implementações soberanas. A informação disponível deixa por esclarecer questões importantes sobre licença, contexto, hardware e avaliação independente.
A Mercor divulgou um resultado de 100% para Claude Opus 5 em uma avaliação de tarefas contábeis semelhantes às do fechamento mensal, ante 37% dos participantes humanos, segundo uma cobertura secundária. As informações disponíveis não permitem verificar o tamanho do teste, a rubrica nem as condições de execução.
Uma análise de 22 benchmarks distingue a fiabilidade da comparação entre sistemas implementados da fiabilidade de atribuir diferenças aos modelos. Os resultados sugerem que mais tarefas não eliminam todas as incertezas.