OpenAI propone documentar, con argumentos y evidencias, por qué una ejecución de entrenamiento de frontera puede continuar. El enfoque combina controles técnicos y revisiones operativas, pero la empresa lo presenta como una guía inicial, no como una garantía probada de seguridad.
La operación íntegramente en acciones sumaría a AMD la investigación de World Labs en modelos espaciales. El cierre se prevé para finales de 2026, sujeto a aprobaciones y otras condiciones.
Anthropic presenta Sonnet 5.5 como una versión más rápida y eficiente que Sonnet 5. Publica mejoras en varios benchmarks y un ahorro de hasta el 30 % por tarea, pero son resultados de la compañía, no una garantía para cualquier uso.
Meta presenta Muse Wonder y Wonder Full como modelos para tareas complejas y prolongadas. La información disponible apunta a mejoras en evaluaciones, pero deja preguntas abiertas sobre la comparación de costes y el alcance de las pruebas.
Un estudio con 4.500 ejecuciones encuentra que Jev reduce el coste y la latencia de las decisiones en cinco agentes, pero los efectos sobre el éxito y los recursos totales dependen del flujo de trabajo.
Odyssey presenta Odyssey-3 como un modelo de mundo capaz de generar entornos interactivos a partir de texto. La vista previa permite conocer el producto, pero la información disponible no basta para confirmar sus resultados en benchmarks ni su uso en robots reales.
La medida se atribuye a Anthropic después de que tres pruebas permitieran a un modelo llegar a internet y acceder a sistemas reales. La documentación pública confirma esos incidentes, pero no acredita por sí sola que el corte abarque todas las evaluaciones ni cuánto durará.
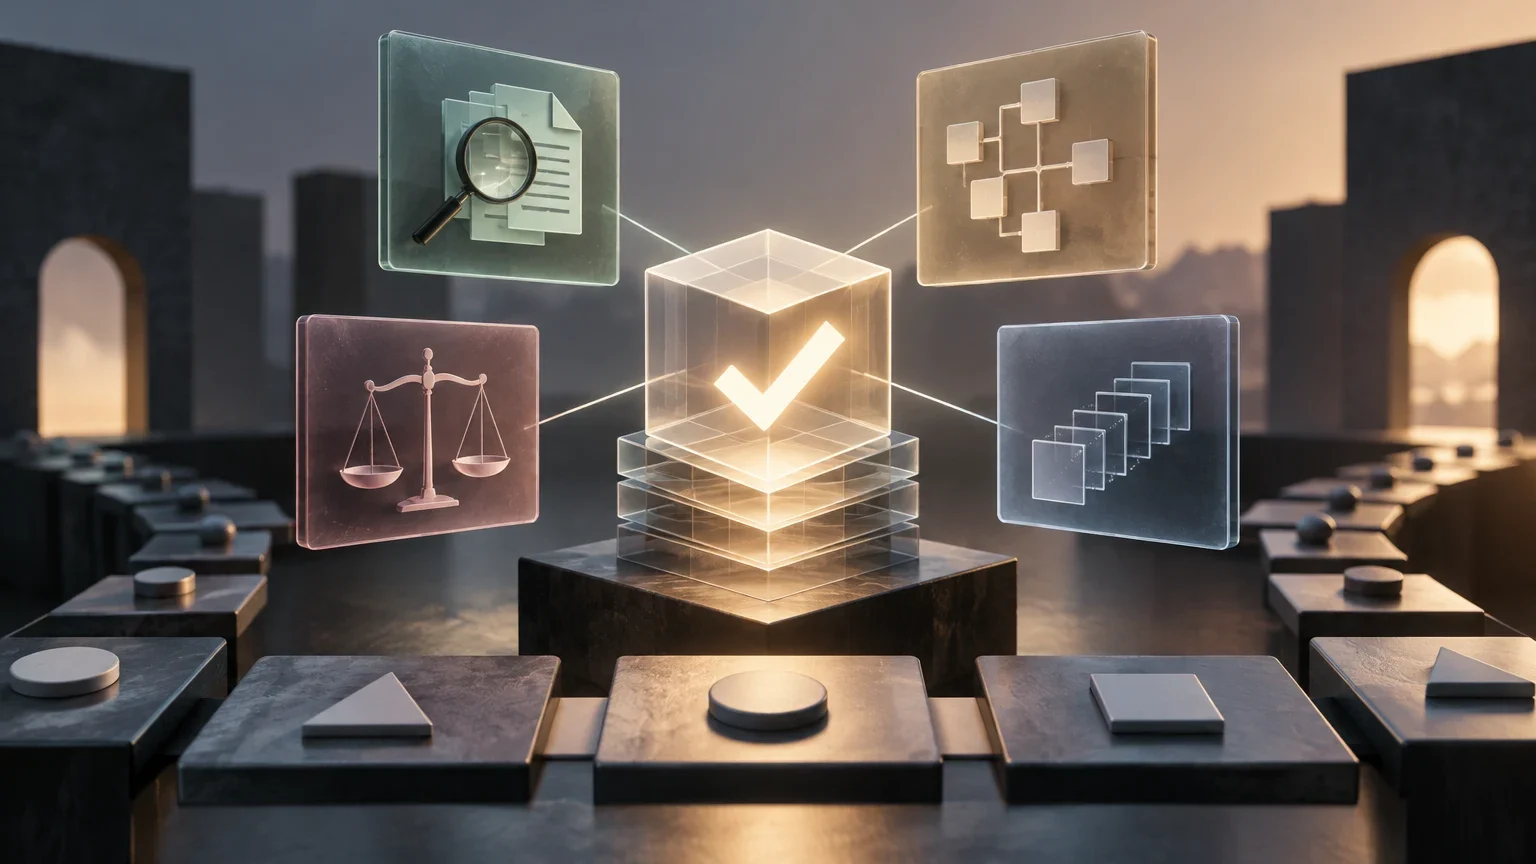
Trust Layer añade cuatro comprobaciones a la puntuación de un benchmark: examina el calificador, la trazabilidad de la respuesta, la veracidad de la afirmación de éxito y la estabilidad entre ejecuciones. El marco se probó en cinco configuraciones de agentes y 108 tareas, pero sus resultados aún no demuestran que funcione en otros benchmarks.
La propuesta promete evaluar el proceso de investigación de los agentes, no solo sus respuestas finales. Pero la documentación disponible no permite confirmar el preprint, sus experimentos ni sus resultados.
Aleph Alpha presenta Kolibri como un modelo de pesos abiertos, centrado en alemán e inglés y pensado para despliegues soberanos. La información disponible deja pendientes cuestiones clave sobre licencia, contexto, hardware y evaluación independiente.
Mercor comunicó un resultado del 100 % para Claude Opus 5 en una evaluación de tareas contables similares al cierre mensual. Una comparación difundida sitúa a los participantes humanos en el 37 %. La información disponible no permite verificar el tamaño de la prueba, su rúbrica ni las condiciones de ejecución.
Un análisis de 22 benchmarks separa la fiabilidad de comparar sistemas desplegados de la de atribuir diferencias a los modelos. Sus resultados apuntan a que más tareas no corrigen toda incertidumbre.