A Aleph Alpha apresenta o Kolibri como um modelo de pesos abertos, centrado no alemão e no inglês e concebido para implementações soberanas. A informação disponível deixa por esclarecer questões importantes sobre licença, contexto, hardware e avaliação independente.
Várias descrições de terceiros atribuem ao Claude Code um sistema chamado Mods, mas as evidências disponíveis não confirmam um anúncio oficial nem esclarecem suas permissões, disponibilidade ou capacidades. Veja o que convém verificar antes de adotá-lo.
A Mercor divulgou um resultado de 100% para Claude Opus 5 em uma avaliação de tarefas contábeis semelhantes às do fechamento mensal, ante 37% dos participantes humanos, segundo uma cobertura secundária. As informações disponíveis não permitem verificar o tamanho do teste, a rubrica nem as condições de execução.
A NVIDIA anunciou oficialmente o DGX Spark com 64 GB de memória unificada. O preço inicial é de 4.999 dólares e a disponibilidade está prevista a partir de 23 de outubro de 2026 através da Acer, ASUS, Dell, Gigabyte, HP e MSI.
A Apple documenta controles para o acesso de apps a arquivos e dados do Mac. As informações disponíveis aqui não confirmam novas permissões vinculadas a agentes de IA nem permitem verificar o caso do Muse.
Uma fonte jornalística noticia uma intimação relacionada a incidentes de cibersegurança envolvendo agentes de IA. O material disponível não permite confirmar o episódio do Hugging Face, o alcance do acesso nem se houve extração de dados ou danos.
Duas publicações descrevem modelos da Microsoft para transcrição em streaming e síntese de voz. A documentação fornecida confirma parte do contexto, mas não verifica de forma independente os números de latência nem o alcance dos 23 idiomas.
O trabalho afirma reduzir a taxa de sucesso de backdoors sem retreinar os parâmetros suspeitos e sem depender, segundo o resumo, de gatilhos conhecidos ou referências limpas. Os detalhes experimentais disponíveis não são suficientes para verificar essas afirmações de forma independente.
Uma análise de 22 benchmarks distingue a fiabilidade da comparação entre sistemas implementados da fiabilidade de atribuir diferenças aos modelos. Os resultados sugerem que mais tarefas não eliminam todas as incertezas.
Code to Control separa a geração da estrutura de um controlador do ajuste dos seus parâmetros. O preprint afirma que, depois de aprendido, o controlador pode atuar sem inferência do LLM nem planeamento em cada passo; as evidências disponíveis não bastam para avaliar os números, a reprodutibilidade ou a preparação para robôs reais.
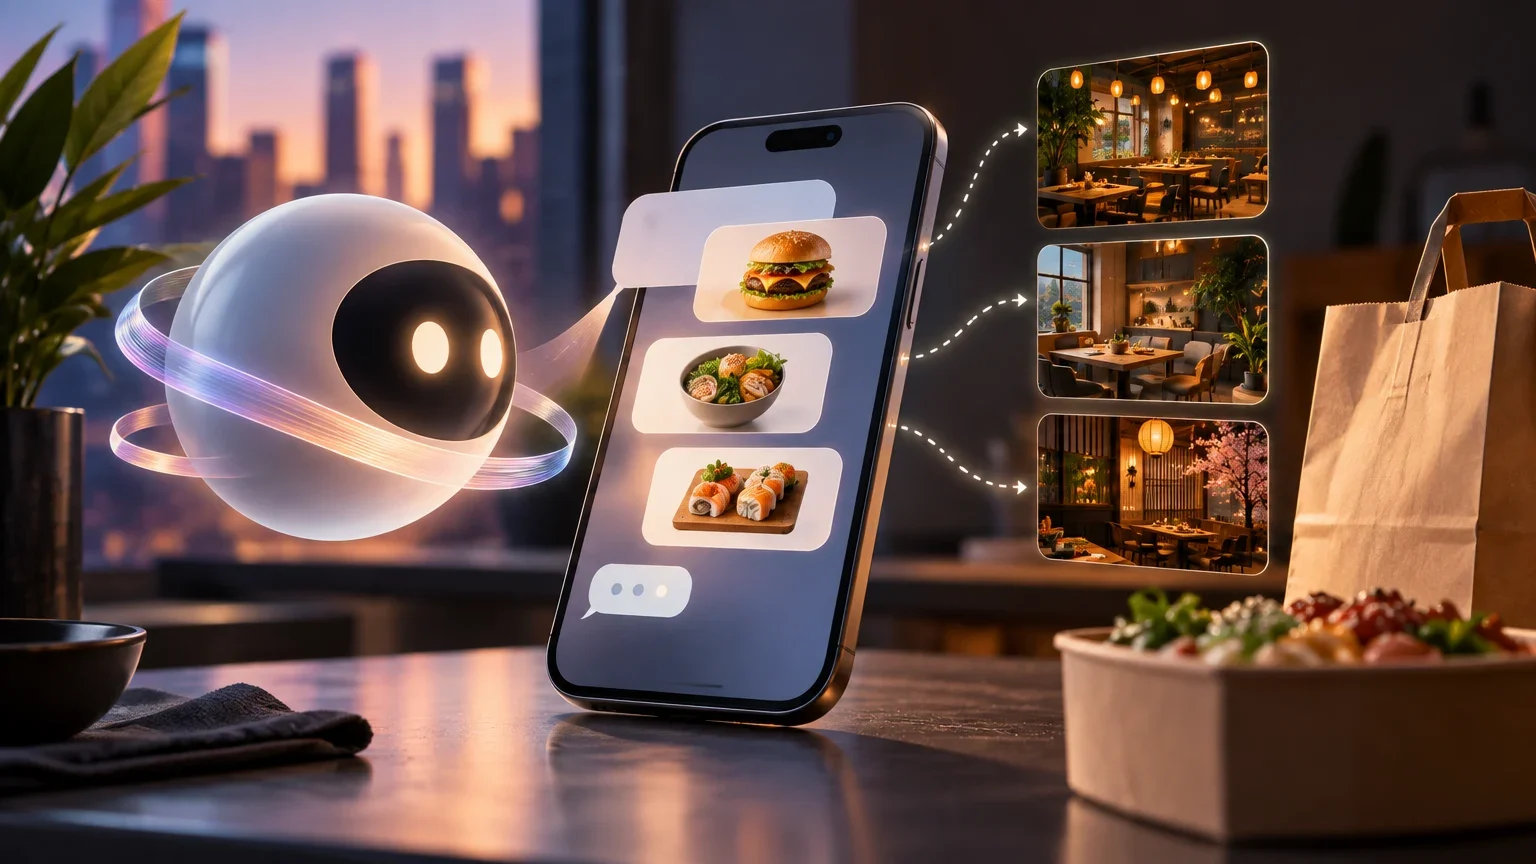
A empresa abriu listas de espera nos Estados Unidos para um agente integrado ao Apple Messages e uma API para pedidos em grandes quantidades. Ainda não foram esclarecidos aspetos importantes, como a confirmação do pagamento, os restaurantes disponíveis ou o tratamento das conversas.
CheatBench é apresentado em notícias secundárias como um benchmark para estudar comportamentos de reward hacking. As informações disponíveis permitem explicar a questão que ele propõe, mas não confirmar os detalhes experimentais nem extrapolar os resultados para sistemas em produção.