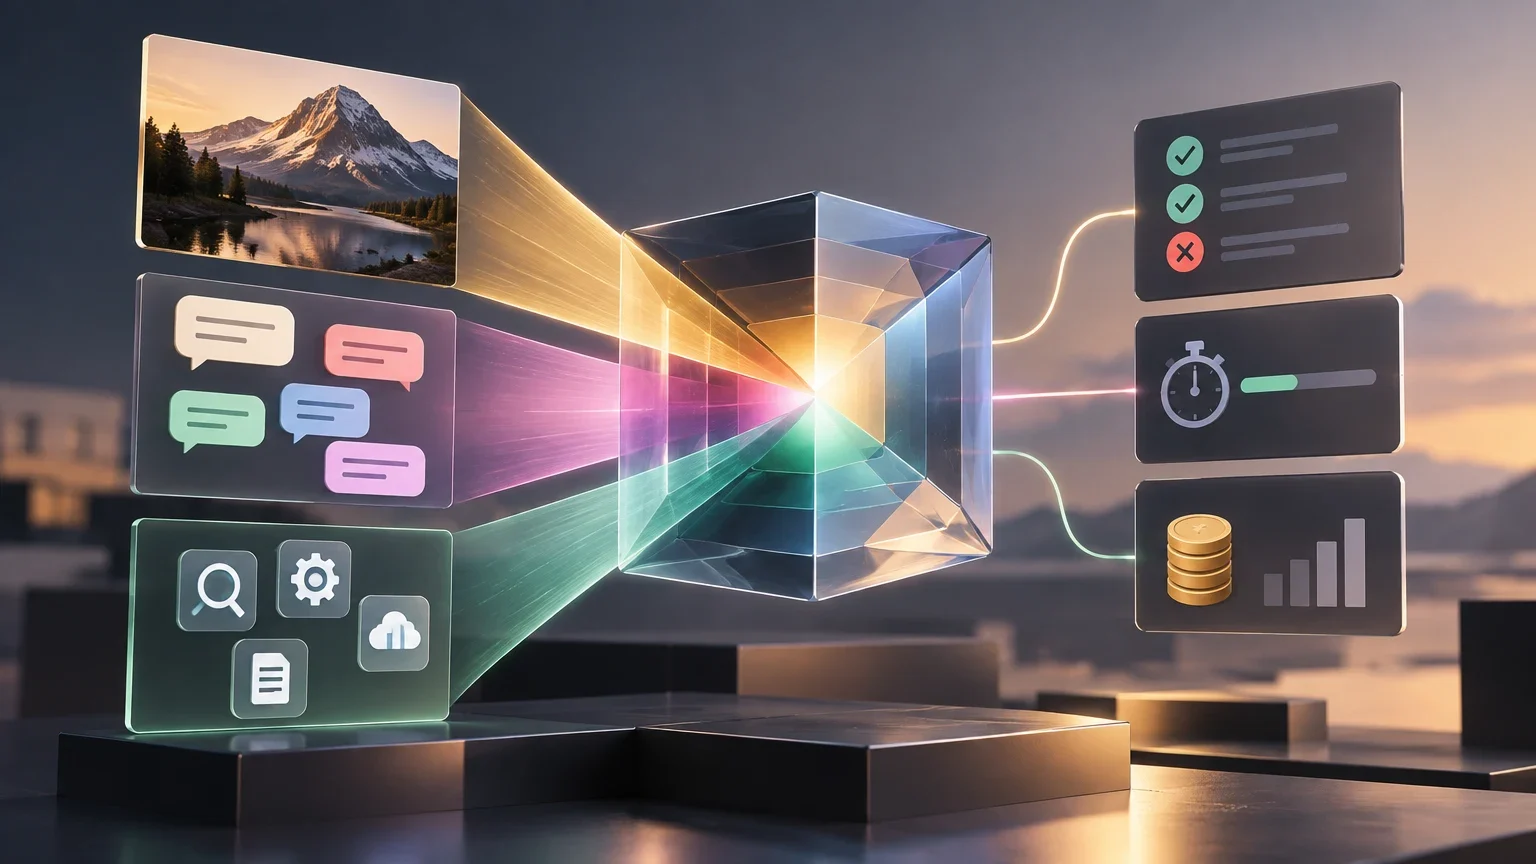
Eine deklarierte Fähigkeit belegt noch keinen vollständigen Workflow
Cohere führt Command A+ unter der Kennung command-a-plus-05-2026 und beschreibt Text- und Bildeingaben, Unterstützung für 48 Sprachen sowie agentische Fähigkeiten. Diese Angaben helfen dabei, festzulegen, was sich zu testen lohnt. Sie belegen jedoch nicht, dass das Modell eine Aufgabe, die all diese Aspekte kombiniert, zuverlässig löst. Ein Bild zu verstehen, eine Anfrage in einer anderen Sprache zu interpretieren und zu entscheiden, ob ein Tool aufgerufen werden soll, sind unterschiedliche Bestandteile einer Aufgabe. Ihre bloße Kombination garantiert kein korrektes Gesamtergebnis.
Die operative Frage lautet nicht, ob Command A+ grundsätzlich Bilder verarbeiten, verschiedene Sprachen unterstützen oder Tools nutzen kann. Entscheidend ist vielmehr, ob das Modell in dem konkreten Prozess, den eine Organisation einsetzen möchte, Hinweise in einem Bild finden, die Bitte der nutzenden Person verstehen und eine passende Aktion ausführen kann, ohne Angaben zu erfinden oder seine Berechtigungen zu überschreiten. Das lässt sich nur mit einer eigenen Evaluation anhand repräsentativer Aufgaben und beobachtbarer Ergebnisse beantworten.
Die Dokumentation des Anbieters dient dazu, das zu testende Modell, die Eingaben und die Testkonfiguration festzulegen. Cohere beschreibt in seinen Anleitungen die Verarbeitung von Bildern, die Tool-Nutzung und den Chat-Endpunkt. Diese Dokumentation sollte nicht mit einer unabhängigen Bewertung der kombinierten Leistung verwechselt werden. Ebenso können Benchmarks zu mehrsprachigem multimodalem Schlussfolgern oder visuellen Tool-Ketten bei der Versuchsplanung helfen, belegen aber nicht, wie sich Command A+ im Workflow eines Unternehmens verhält.
Dieser Ansatz unterscheidet sich von einem Vergleich zwischen Command A+ und einem anderen Modell für eine Aufgabe mit Retrieval-Augmented Generation. Hier geht es weder darum, einen Sieger zu küren, noch darum, eine Rangliste zu übertragen. Stattdessen wird ein einzelnes Modell unter kontrollierten Bedingungen evaluiert, um zu entscheiden, welche Aufgaben es übernehmen kann, welche eine menschliche Prüfung erfordern und welche Änderungen an Konfiguration oder Prozess nötig sind.
Eine Aufgabe definieren, die alle drei Fähigkeiten erfordert
Die Evaluationseinheit sollte eine vollständige Aufgabe sein und keine Sammlung einzelner Fragen. Ein Beispiel: Eine Person übermittelt einen Screenshot einer Benutzeroberfläche und bittet in ihrer Sprache darum, zu prüfen, ob ein Vorgang als abgeschlossen angezeigt wird, und das Ergebnis in einem Testsystem zu erfassen. Für eine korrekte Bearbeitung müsste das Modell die Anfrage verstehen, die relevanten Hinweise im Bild erkennen, entscheiden, ob ein Tool erforderlich ist, und gegebenenfalls Argumente übermitteln, die mit dem Tool-Schema übereinstimmen.
Der Test sollte klar trennen, was beobachtet werden kann und was das System tun soll. Die visuelle Antwort lässt sich mit einer menschlichen Annotation des Bildes abgleichen, die Interpretation der Anfrage mit einer erwarteten Absicht, der Tool-Aufruf mit dem vorgesehenen Tool-Namen und den erwarteten Argumenten und das Endergebnis mit der protokollierten Wirkung in der simulierten Umgebung. So wird verhindert, dass eine flüssig formulierte Antwort als Erfolg zählt, obwohl das Modell beispielsweise eine Zahl falsch gelesen oder eine Aktion mit einem falschen Wert ausgeführt hat.
Bevor Beispiele erstellt werden, muss der Handlungsspielraum festgelegt werden. Ein simuliertes Tool kann Informationen zurückgeben oder in einer Testumgebung eine reversible Operation ausführen. Diese ersten Tests sollten nicht mit produktiven Konten, Dokumenten oder Prozessen verbunden sein. Eine Simulation ermöglicht es, die Tool-Auswahl und die Argumente zu beobachten, ohne die Modellqualität mit Schäden oder realen Folgen zu vermischen.
Es sollte außerdem vorab festgelegt werden, was als angemessener Verzicht auf eine Aktion gilt. Ist das Bild unleserlich, fehlt eine wesentliche Angabe oder ist die Aktion nicht autorisiert, kann eine Rückfrage einer Ausführung vorzuziehen sein. Eine Enthaltung sollte nicht automatisch als Fehler gewertet werden: Ihr Wert hängt davon ab, ob genügend Hinweise vorlagen und welche Folgen eine Handlung unter Unsicherheit hätte.
Mindestvorbereitung für jeden Testfall
- 01Die Absicht, die erforderlichen sichtbaren Hinweise und die zulässige Aktion festlegen.
- 02Das Testbild speichern und annotieren, welche Bildbereiche die erwartete Antwort stützen.
- 03Festlegen, ob das Tool verwendet werden soll, nicht verwendet werden darf oder ob Informationen für eine Entscheidung fehlen.
- 04Das erwartete Ergebnis dokumentieren, einschließlich zulässiger Argumente und der Bedingungen, unter denen das Modell sich enthalten sollte.
Einen Datensatz aufbauen, der die tatsächliche Nutzung abbildet
Der Evaluationsdatensatz sollte Dokumente und Screenshots von Benutzeroberflächen enthalten, die die Organisation verwenden darf. Sinnvoll ist eine Bandbreite an Formaten und Bildqualitäten: scharfe und unscharfe Bilder, kleine Schrift, teilweise abgeschnittene Elemente, unterschiedliche Layouts sowie, falls relevant, tabellarische Daten oder ähnlich strukturierte Felder. Das sind Vorschläge für die Versuchsplanung und keine Fähigkeiten, die durch die Dokumentation garantiert wären.
Jedes Bild sollte eine von Menschen geprüfte Referenz haben: Welche Information ist tatsächlich vorhanden, wo erscheint sie und welche Unsicherheiten bleiben bestehen? Wenn sich eine Zahl auf zwei Arten lesen lässt oder ein Status nicht eindeutig erkennbar ist, sollte die Annotation das festhalten. Eine erzwungene „richtige Antwort“ für ein mehrdeutiges Bild würde die Messung verzerren und eine angemessene Enthaltung benachteiligen.
Die Auswahl der Sprachen sollte sich nach den vorgesehenen Nutzenden und Prozessen richten. Cohere gibt zwar Unterstützung für 48 Sprachen an, doch daraus folgt weder ein Nachweis für eine gleichmäßige Leistung in jeder Sprache noch für eine bestimmte geschäftliche Aufgabe. Für jeden Fall sollte festgehalten werden, in welcher Sprache die Anfrage gestellt wird, in welcher Sprache der Bildinhalt vorliegt und ob beide Sprachen gemischt sind. Wird der Datensatz übersetzt, sollte eine sprachkundige Person prüfen, ob die Anweisung ihre Bedeutung und ihren Grad an Mehrdeutigkeit beibehält.
Um eine Verunreinigung der Evaluation zu vermeiden, empfiehlt es sich, Testfälle zurückzuhalten, die weder zum Anpassen der Anweisungen noch der Schemas verwendet werden. Außerdem können auf Grundlage von Vorlagen kontrollierte Varianten erstellt werden, ohne diese Varianten als vollständig unabhängige Beobachtungen zu behandeln. Entscheidend ist, dass die Beispiele reale Entscheidungen abbilden: wann ein Tool erforderlich ist, wann es keinen Mehrwert bietet und wann die visuellen Hinweise nicht ausreichen.
Empfohlene Testmatrix
Nicht jede Dimension muss mit jeder anderen in allen Zellen kombiniert werden. Die Matrix hilft dabei, Vergleiche zu erkennen, mit denen sich Änderungen auf Bild, Sprache oder Tool zurückführen lassen.
| Dimension | Mögliche Bedingungen | Was sich damit beobachten lässt |
|---|---|---|
| Eingabe | Text; Text und Bild | Ob das Bild nützliche Hinweise liefert und ob seine Einbeziehung die Antwort verändert |
| Sprache | Übliche Sprache des Teams; weitere relevante Sprachen; Bildinhalt in einer anderen Sprache | Fehler beim Verstehen, Lesen und Übertragen zwischen Sprachen |
| Aktion | Antwort ohne Tool; zulässiger Tool-Aufruf; unnötiger Tool-Aufruf; Enthaltung | Tool-Auswahl, Entscheidung zu handeln und angemessene Nutzung der Hinweise |
| Qualität der Hinweise | Eindeutig; beeinträchtigt; unvollständig oder mehrdeutig | Robustheit und Verhalten bei Unsicherheit |
Simulierte Tools und eine reproduzierbare Konfiguration verwenden
Jedes Test-Tool sollte einen klar definierten Zweck, ein Argument-Schema und kontrollierte Rückgaben haben. Eine Abfragefunktion könnte beispielsweise anhand einer Kennung einen Teststatus zurückgeben; eine andere Funktion könnte einem simulierten Datensatz ein Tag hinzufügen. Die Rückgaben sollten vorhersehbar sein und im Ausführungsprotokoll gespeichert werden. So lässt sich ein Lesefehler des Modells von einem Infrastrukturfehler oder einer unerwarteten Tool-Antwort unterscheiden.
Cohere stellt mit der Anleitung zur Tool-Nutzung und der Chat-Referenz Ausgangspunkte für die Implementierung bereit. Vor der Durchführung sollte anhand der aktuellen Dokumentation geprüft werden, wie Tools deklariert werden, welche Felder die Anfrage erfordert und welche Eingabeformen mit der ausgewählten Modellkennung kompatibel sind. Es sollte nicht ungeprüft angenommen werden, dass sich alle Parameter, Formate oder Modi, die in einer Konfiguration verfügbar sind, auch in einer anderen kombinieren lassen.
Die Konfiguration sollte zwischen den Testbedingungen gleich bleiben, außer bei dem Faktor, dessen Einfluss gemessen werden soll. Zu protokollieren sind die genaue Modellkennung, das Datum, die API- oder Client-Version, die relevanten Anfragefelder, die verfügbaren Tools und deren Schemas. Ändern sich Nachrichten mit Anweisungen oder Tool-Definitionen zwischen Gruppen, können die Unterschiede auf diese Änderungen statt auf Sprache oder Bild zurückzuführen sein.
Die Tests sollten in einer isolierten Umgebung mit reversiblen Auswirkungen stattfinden. Auch bei simulierten Tools empfiehlt es sich, die Argumente vor der Ausführung zu validieren und sowohl die Anfrage als auch die Tool-Antwort aufzubewahren. Bei einem Workflow, der Daten verändern kann, sollte die Evaluation zusätzlich das Autorisierungsverhalten und den Umgang mit Anweisungen prüfen, die nicht zur Aufgabe gehören, und zwar über die reine Textantwort hinaus.
Bedingungen vergleichen, ohne die Ursachen zu vermischen
Das aussagekräftigste Design kombiniert isolierte Kontrollen mit integrierten Aufgaben. In einer Textkontrolle werden die notwendigen Informationen ohne Bild präsentiert; in einer weiteren wird das Extrahieren von Daten aus einem Bild ohne externe Aktion geprüft; in einer dritten wird ein Tool-Aufruf bewertet, bei dem die benötigten Informationen bereits angegeben sind. Die kombinierte Bedingung verlangt vom Modell, Hinweise aus dem Bild zu gewinnen, die Anfrage in der jeweiligen Sprache zu verstehen und zu entscheiden, was zu tun ist.
Die Kontrollen belegen für sich genommen nicht, dass das System einsatzbereit ist. Sie helfen dabei, die wahrscheinliche Ursache einer Leistungsverschlechterung einzugrenzen. Extrahiert das Modell ein Feld korrekt, wenn es als Text vorliegt, nicht aber aus einem Screenshot, deutet das auf ein Problem bei der visuellen Interpretation hin. Versteht es Feld und Absicht jeweils getrennt, scheitert aber, wenn eine Anfrage in einer anderen Sprache mit dem Screenshot kombiniert wird, sollte die Zusammensetzung der Fähigkeiten genauer untersucht werden. Ist die Entscheidung korrekt, aber die Argumente sind falsch, liegt der Fehler bei der Vorbereitung des Aufrufs oder an der Schnittstelle zum Tool.
Damit der Vergleich fair ist, sollte in allen Bedingungen dieselbe Aufgabe mit demselben Ziel verwendet werden. Die erwartete Antwort bleibt gleich; geändert wird nur die Modalität oder der jeweils relevante Sprachfaktor. Die Reihenfolge der Fälle sollte variiert und die Anweisungen nicht nach einer Prüfung des zurückgehaltenen Testdatensatzes nachträglich angepasst werden. Bei kleinen Stichproben sollten die Ergebnisse pro Fall und Kategorie berichtet werden, statt eine aggregierte Quote so darzustellen, als beschreibe sie die allgemeine Leistung.
Eine Wiederholung desselben Falls kann Schwankungen sichtbar machen, verwandelt einen kleinen Test aber nicht in einen universellen Leistungsnachweis. Die Ergebnisse jeder Ausführung sollten erhalten bleiben, einschließlich doppelter Aufrufe, unvollständiger Antworten und Fehlern in der Testumgebung. Die Erfolgsquote muss vorab definiert werden: Eine Aufgabe gilt beispielsweise nur dann als abgeschlossen, wenn die Hinweise korrekt erkannt, die autorisierte Aktion mit gültigen Argumenten ausgeführt und die abschließende Antwort mit dem beobachteten Ergebnis in Einklang gebracht wurden.
Ablauf der Evaluation
- 01Isolierte Kontrollen für visuelles Lesen, Sprachverständnis und Tool-Nutzung ausführen.
- 02Kombinierte Aufgaben mit denselben Referenzen und Handlungsspielräumen durchführen.
- 03Eingaben, endgültige Antwort, Aufrufe, Argumente, Tool-Ergebnisse und Zeitwerte speichern.
- 04Vor der Zusammenfassung der Quoten eine Stichprobe erfolgreicher Fälle, Fehler und Enthaltungen manuell prüfen.
- 05Betroffene Fälle nach einer Konfigurationskorrektur erneut ausführen, ohne den Anpassungsdatensatz mit dem Abnahmedatensatz zu vermischen.
End-to-End-Erfolg und Kosten messen
Eine einzelne Kennzahl beschreibt einen multimodalen Agenten nicht ausreichend. Die Evaluation sollte getrennt erfassen, ob die visuellen Hinweise korrekt extrahiert, die Anfrage verstanden, das passende Tool ausgewählt, gültige Argumente übermittelt, das erwartete Ergebnis ausgeführt und die abschließende Antwort mit diesem Ergebnis in Einklang gebracht wurden. Ein System kann eine Stufe bestehen und an der nächsten scheitern. Wenn diese Unterschiede erhalten bleiben, lassen sich gezieltere Korrekturen vornehmen.
Auch Enthaltungen brauchen eine eigene Kennzahl. Erfasst werden sollte, wann das Modell um Klärung bittet oder angibt, etwas nicht bestimmen zu können; anschließend ist dieses Verhalten mit der tatsächlichen Aussagekraft der Hinweise abzugleichen. Eine Enthaltung bei einem unleserlichen Bild kann angemessen sein. Bei einem eindeutigen Feld und einer autorisierten Bitte kann sie den Workflow dagegen blockieren. Ebenso kann ein unnötiger Tool-Aufruf ein Fehler sein, auch wenn das Tool eine harmlose Antwort liefert.
Neben dem Verbrauch, der sich mit der gewählten Konfiguration messen lässt, sollten Latenz und Kosten pro abgeschlossener Aufgabe protokolliert werden. Cohere erläutert das Abrechnungsmodell und die abrechenbaren Einheiten; die für den konkreten Fall geltenden Kosten müssen jedoch für den jeweiligen Zugangskanal und Tarif geprüft werden. Ein Durchschnitt pro Anfrage kann irreführend sein, wenn fehlgeschlagene Aufgaben Wiederholungen oder eine menschliche Prüfung erfordern. Daher sollten auch die Kosten korrekt abgeschlossener Aufgaben berechnet und nachgelagerter Arbeitsaufwand berücksichtigt werden.
Fasse nicht alle Sprachen, Bilder und Tool-Typen in einer einzigen Zahl zusammen, ohne die Ergebnisse aufzuschlüsseln. Ein hoher Durchschnitt kann eine Kategorie verbergen, in der das System Kennungen falsch liest oder ohne ausreichende Hinweise handelt. Berichte Ergebnisse nach Sprache, Bildtyp, Qualität der Hinweise, Tool-Entscheidung und Fehlerklasse. Reicht die Fallzahl nicht für stabile Schätzungen, beschreibe die Ergebnisse als Beobachtungen für den getesteten Datensatz und nicht als verlässliche Produktionsquote.
Metriken protokollieren
Lege jede Metrik vor dem Test fest und bewahre die Einzelfälle auf, damit ein Durchschnitt keine Fehler mit großen Auswirkungen verdeckt.
| Metrik | Erfassung | Welche Frage sie beantwortet |
|---|---|---|
| Visuelle Hinweise | Erwartetes Feld, extrahiertes Feld und annotierte Position oder Referenz | Hat das Modell den Wert gelesen, der die Antwort begründet? |
| Tool-Entscheidung | Ausgewähltes Tool, ausgelassener Aufruf oder unnötiger Aufruf | War die Aktion relevant und autorisiert? |
| Argumente und Ausführung | Übermittelte Argumente, Validierung und zurückgegebenes Ergebnis | Hat das Tool die richtigen Daten erhalten und die erwartete Wirkung erzielt? |
| Enthaltung | Fälle mit Rückfrage, Ablehnung oder unsicherer Antwort, abgeglichen mit den Hinweisen | Hat das Modell bei fehlenden Informationen vorsichtig gehandelt und bei ausreichenden Informationen fortgefahren? |
| Latenz und Kosten | Zeit und verfügbare Abrechnungseinheiten pro Ausführung und abgeschlossener Aufgabe | Ist der Workflow tragfähig, wenn Fehler, Wiederholungen und Prüfaufwand berücksichtigt werden? |
Fehler klassifizieren, bevor eine Entscheidung getroffen wird
Falsch gelesene Zahlen oder Statusangaben können durch geringe Auflösung, Zuschnitt, visuelles Design oder die Interpretation des Modells verursacht werden. Halte den relevanten Bildausschnitt und die Art der Bilddarstellung fest; schreibe nicht automatisch jeden Fehler einer allgemeinen Einschränkung des Bildverstehens zu. Gibt das Modell einen Wert an, der im Bild nicht vorkommt, sollte außerdem erfasst werden, ob es ihn erfunden, mit einem anderen Feld verwechselt oder aus unvollständigem Kontext abgeleitet hat.
Sprachfehler können bei der Interpretation der Bitte, beim Lesen des Bildinhalts oder in der abschließenden Antwort auftreten. Diese Schritte sollten getrennt erfasst werden. Eine Anfrage kann korrekt verstanden worden sein, obwohl das Modell ein Label im Screenshot falsch transkribiert; ebenso kann es den Text korrekt erkannt, aber die gewünschte Handlung falsch interpretiert haben. Die Sprache jeder Komponente zu protokollieren, hilft dabei, Muster in gemischten Aufgaben zu erkennen.
Bei der Tool-Nutzung sollte zwischen einem unnötigen Aufruf, dem falschen Tool, einem fehlerhaften Schema, gültigen, aber falschen Argumenten und einer abschließenden Antwort, die dem zurückgegebenen Ergebnis widerspricht, unterschieden werden. Diese Klassifizierung zeigt, ob das Tool-Design, die Anweisungen, Vorabprüfungen oder Autorisierungsregeln angepasst werden sollten. Ein passend ausgewähltes Tool macht falsche Argumente nicht wett.
Auch überzeugende Testergebnisse bescheinigen keine universelle Sicherheit. Der Datensatz deckt nur die darin enthaltenen Fälle und die getestete Konfiguration ab. Bei einem Einsatz mit relevanten Folgen sollten Verhaltenstests durch Zugriffsbeschränkungen, Argumentvalidierung, Nachvollziehbarkeit und eine dem Risiko angemessene menschliche Prüfung ergänzt werden. Das sind operative Empfehlungen und keine Garantie des Anbieters.
Abnahmekriterien und Grenzen der Schlussfolgerungen
Die Abnahmekriterien sollten sich nach den möglichen Auswirkungen der jeweiligen Aufgabe richten und festgelegt werden, bevor die Ergebnisse vorliegen. Bei einem Vorgang mit geringem Risiko kann eine Organisation eine Antwort zulassen, die geprüft wird, bevor ein Datensatz geändert wird. Bei einer irreversiblen Aktion oder externen Folgen kann ein nicht verifizierter Tool-Aufruf selbst dann unzulässig sein, wenn die Gesamtquote hoch erscheint. Das Protokoll gibt keinen universellen Schwellenwert vor: Jedes Team muss festlegen, welche Fehler tolerierbar sind und durch welche Kontrollen sie begrenzt werden.
Eine umsichtige Entscheidung kann Command A+ eng umrissene Aufgaben zuweisen, wenn der repräsentative Datensatz ausreichende Extraktion, gültige Argumente, angemessene Enthaltungen und mit dem Prozess vereinbare Kosten zeigt – und zwar nur unter den vorgesehenen Kontrollen. Treten Fehler bei bestimmten Sprachen, Formaten oder mehrdeutigen Statusangaben auf, können diese Fälle für eine menschliche Prüfung reserviert oder vom Anwendungsbereich ausgeschlossen werden. Die Schlussfolgerung sollte die freigegebenen Bedingungen benennen und nicht behaupten, das Modell sei allgemein zuverlässig.
Das Datenblatt von Cohere und die zugehörigen Anleitungen sollten zum Abschluss des Experiments erneut geprüft werden, um die aktuelle Modellkennung, verfügbare Zugangskanäle, geltenden Formate und Beschränkungen sowie die Konfiguration der Anfrage zu bestätigen. Wird ein anderer Zugangskanal evaluiert oder die Version geändert, lassen sich die Schlussfolgerungen nicht automatisch übertragen. Ein Repository mit veröffentlichten Gewichten kann lokale Tests unter den Bedingungen der jeweiligen Lizenz unterstützen; dadurch werden lokale Ergebnisse aber nicht mit API-Ergebnissen gleichwertig.
Der vorgeschlagene Test bestimmt auch nicht, wie sich das Modell mit Bildern, Sprachen, Tools oder Risikostufen verhält, die nicht einbezogen wurden. Forschungsarbeiten zu mehrsprachigem multimodalem Schlussfolgern und visuellen Tool-Ketten können die Gestaltung des Datensatzes anleiten, ersetzen aber keine aktuelle Evaluation des Modells in der Zielumgebung. Die belastbarste Schlussfolgerung ist begrenzt: Was hat mit welcher Konfiguration unter welchen Bedingungen funktioniert, und welche Fehler verhindern eine Ausweitung des Einsatzes?
Offene Fragen
- Die bereitgestellte Dokumentation nennt das Modell command-a-plus-05-2026. Die aktuelle Modellkennung und verfügbaren Zugangskanäle müssen zum Abschluss der Evaluation bestätigt werden.
- Die vollständige Liste der 48 Sprachen und öffentlich verfügbare, nach Sprache aufgeschlüsselte Leistungsnachweise von Command A+ für die beschriebenen Aufgaben sind hier nicht enthalten.
- Bildformate, Eingabebeschränkungen und die mit einer einzelnen Anfrage kompatiblen Parameter müssen anhand der aktuellen Dokumentation für den gewählten Zugangskanal und die konkrete Konfiguration geprüft werden.
- Die angegebenen Quellen belegen nicht die Leistung von Command A+ bei Aufgaben, die Bildverstehen, mehrere Sprachen und Tool-Nutzung kombinieren.
- Die konkreten Kosten hängen vom Zugangskanal und dem aktuellen Tarif ab. Sie müssen für den untersuchten Anwendungsfall geprüft werden und lassen sich nicht allein aus dem allgemeinen Abrechnungsmodell ableiten.
- Ergebnisse mit veröffentlichten Gewichten und Ergebnisse über eine API sollten nicht als gleichwertig behandelt werden, ohne Konfiguration, Hardware und Bedingungen zu prüfen.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen