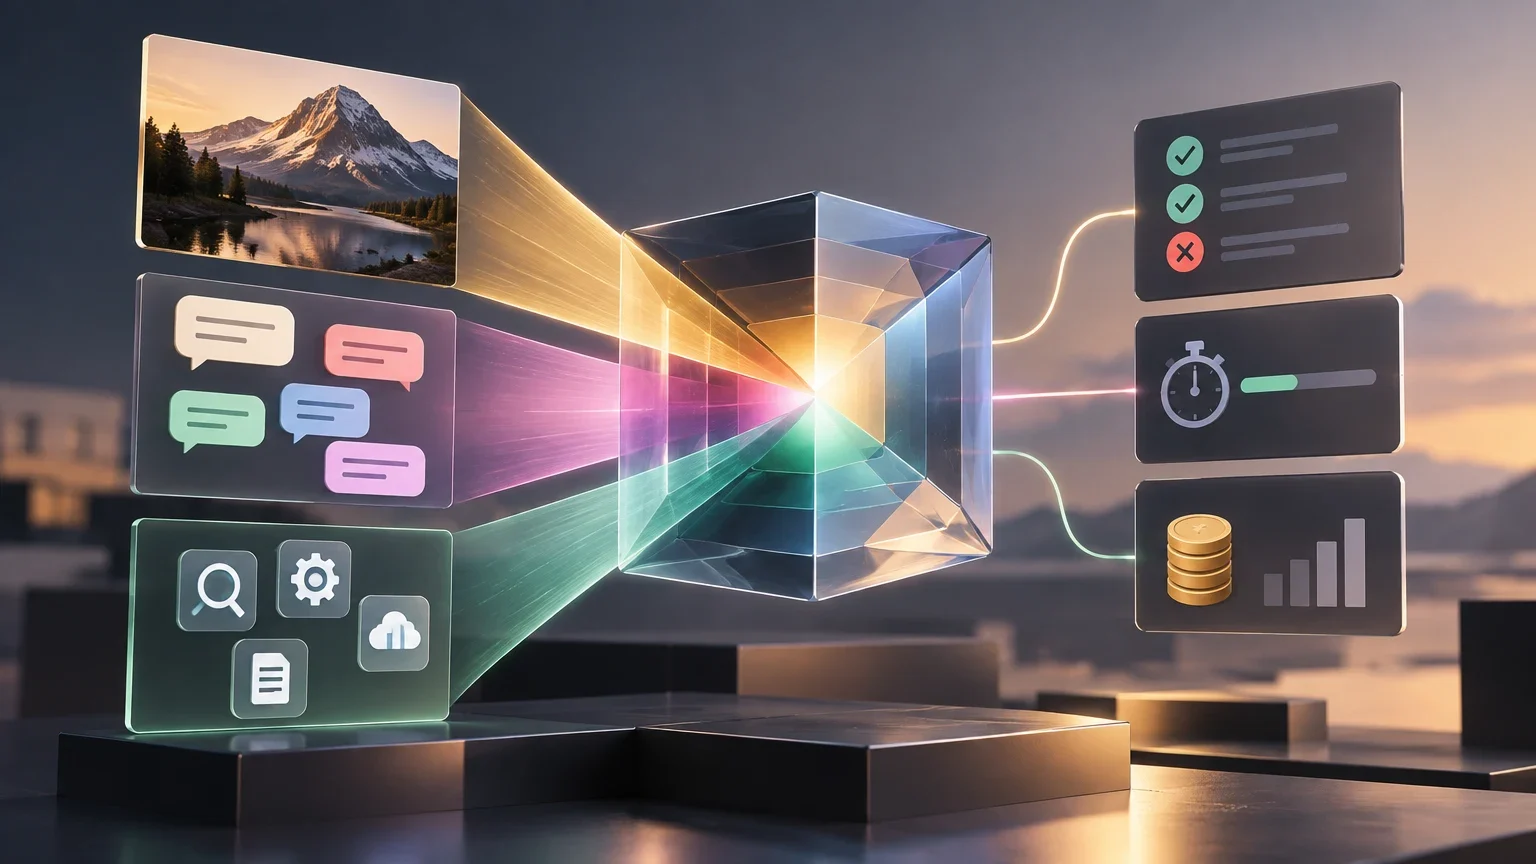
Una capacidad declarada no demuestra un flujo completo
Cohere identifica Command A+ con el identificador command-a-plus-05-2026 y describe entradas de texto e imagen, soporte para 48 idiomas y capacidades agentic. Esos datos permiten delimitar qué merece la pena probar, pero no demuestran que el modelo resuelva de forma fiable una tarea que combine las tres cosas. Entender una imagen, interpretar una solicitud en otro idioma y decidir si se debe llamar a una herramienta son partes distintas de una tarea; su suma no garantiza que el resultado integrado sea correcto.
La pregunta operativa no es si Command A+ tiene visión, admite distintos idiomas o puede usar herramientas en abstracto. Es si, en el proceso concreto que una organización quiere desplegar, puede localizar evidencia en una imagen, entender qué pide el usuario y ejecutar una acción apropiada sin inventar datos ni exceder sus permisos. La respuesta requiere una evaluación propia, con tareas representativas y resultados observables.
La documentación del proveedor sirve para fijar el modelo, las entradas y la configuración que se va a ensayar. Las guías de Cohere describen el trabajo con imágenes, el uso de herramientas y el endpoint Chat; no deben confundirse con una evaluación independiente del rendimiento conjunto. Del mismo modo, los benchmarks sobre razonamiento multimodal multilingüe o encadenamiento visual de herramientas aportan ideas de diseño, pero no prueban cómo se comporta Command A+ en el flujo de una empresa.
Este enfoque se diferencia de una comparación entre Command A+ y otro modelo para una tarea de recuperación aumentada. Aquí no se busca declarar un ganador ni extrapolar una clasificación. Se evalúa un solo modelo bajo condiciones controladas para decidir qué tareas puede abordar, cuáles requieren revisión humana y qué cambios de configuración o de proceso hacen falta.
Definir una tarea que exija las tres capacidades
La unidad de evaluación debe ser una tarea de principio a fin, no una colección de preguntas aisladas. Por ejemplo: una persona envía una captura de una interfaz y, en su idioma, pide comprobar si una operación aparece completada y registrar el resultado en un sistema de prueba. Para responder bien, el modelo tendría que comprender la solicitud, identificar en la imagen la evidencia pertinente, decidir si la herramienta es necesaria y, si lo es, enviar argumentos compatibles con su esquema.
La prueba debe separar lo que puede observarse de lo que se espera que haga el sistema. La respuesta visual puede contrastarse con una anotación humana sobre la imagen; la interpretación de la solicitud, con una intención esperada; la llamada, con el nombre de herramienta y los argumentos previstos; y el resultado final, con el efecto registrado por el entorno simulado. Así se evita etiquetar como acierto una respuesta fluida que, por ejemplo, leyó mal una cifra o ejecutó una acción con un dato equivocado.
Antes de generar ejemplos, hay que fijar el límite de actuación. Una herramienta simulada puede devolver información o realizar una operación reversible en un entorno de prueba. No se deben conectar estas primeras pruebas a cuentas, documentos o procesos productivos. La simulación permite observar la elección y los argumentos de la herramienta sin confundir la calidad del modelo con daños o consecuencias reales.
También conviene definir de antemano qué significa abstenerse correctamente. Si la imagen es ilegible, falta un dato esencial o la solicitud no autoriza una acción, una respuesta que pide aclaración puede ser preferible a una ejecución. La abstención no debe puntuarse como fallo automáticamente: su valor depende de si había evidencia suficiente y de qué consecuencias tendría actuar con incertidumbre.
Preparación mínima de cada caso
- 01Definir la intención, la evidencia visible necesaria y la acción permitida.
- 02Guardar la imagen de prueba y anotar qué fragmentos respaldan la respuesta esperada.
- 03Especificar si la herramienta debe usarse, no debe usarse o si falta información para decidir.
- 04Registrar el resultado esperado, incluidos los argumentos válidos y las condiciones de abstención.
Construir un corpus que represente el uso real
El conjunto de evaluación debería incluir documentos y capturas de interfaz que la organización esté autorizada a utilizar. Es útil cubrir formatos y calidades variados: imágenes nítidas y borrosas, texto pequeño, elementos parcialmente recortados, distribuciones diferentes y, cuando sea pertinente, datos tabulares o campos similares. Estas variaciones son propuestas de diseño, no capacidades que la documentación garantice.
Cada imagen debe tener una referencia revisada por personas: qué información está realmente presente, dónde aparece y qué incertidumbres conserva. Si una cifra se puede leer de dos formas o un estado no se distingue, la anotación debe reflejarlo. Una etiqueta forzada de “respuesta correcta” para una imagen ambigua distorsionaría la medición y penalizaría una abstención razonable.
El muestreo lingüístico debe basarse en los usuarios y procesos previstos. Aunque Cohere declara soporte para 48 idiomas, eso no equivale a evidencia pública de rendimiento uniforme en cada idioma ni en una tarea empresarial concreta. Se deben registrar el idioma de la solicitud, el idioma del contenido visual y cualquier mezcla entre ambos. Si el corpus se traduce, una persona competente debe revisar que la instrucción conserve el mismo significado y nivel de ambigüedad.
Para reducir la contaminación entre desarrollo y evaluación, es conveniente reservar casos que no se utilicen para ajustar instrucciones ni esquemas. También se pueden crear variaciones controladas a partir de plantillas, sin tratar esas variantes como observaciones completamente independientes. La prioridad es que los ejemplos representen decisiones reales: cuándo hace falta una herramienta, cuándo no aporta valor y cuándo la evidencia visual es insuficiente.
Matriz de condiciones recomendada
No es necesario combinar todas las dimensiones en todas las celdas. La matriz ayuda a detectar qué comparaciones permiten atribuir un cambio a la imagen, el idioma o la herramienta.
| Dimensión | Condiciones posibles | Qué permite observar |
|---|---|---|
| Entrada | Texto; texto e imagen | Si la imagen aporta evidencia útil y si su inclusión cambia la respuesta |
| Idioma | Idioma habitual del equipo; otros idiomas relevantes; contenido visual en otro idioma | Errores de comprensión, lectura y transferencia entre idiomas |
| Acción | Respuesta sin herramienta; llamada permitida; llamada innecesaria; abstención | Selección de herramienta, decisión de actuar y uso adecuado de la evidencia |
| Calidad de evidencia | Clara; degradada; incompleta o ambigua | Robustez y comportamiento ante incertidumbre |
Usar herramientas simuladas y una configuración reproducible
Cada herramienta de prueba debe tener una finalidad explícita, un esquema de argumentos y respuestas controladas. Por ejemplo, una función de consulta puede devolver un estado de prueba a partir de un identificador; otra puede añadir una etiqueta a un registro simulado. Las respuestas han de ser previsibles y quedar guardadas en el registro de ejecución. Así es posible distinguir un error de lectura del modelo de un fallo de infraestructura o de una respuesta inesperada de la herramienta.
La guía de Cohere sobre uso de herramientas y la referencia de Chat son puntos de partida para implementar esta parte. Antes de ejecutar el test hay que verificar en la documentación vigente cómo se declaran las herramientas, qué campos requiere la solicitud y qué formas de entrada son compatibles con el identificador elegido. No se debe presuponer, sin comprobarlo, que todos los parámetros, formatos o modos disponibles en una configuración pueden combinarse en otra.
La configuración se debe mantener constante entre condiciones salvo por el factor que se quiere medir. Registra el identificador exacto del modelo, la fecha, la versión de la API o del cliente, los campos relevantes de la solicitud, las herramientas disponibles y sus esquemas. Si cambian los mensajes de instrucción o la definición de herramientas entre grupos, las diferencias pueden deberse a esos cambios y no al idioma o a la imagen.
Las pruebas deben ejecutarse en un entorno aislado con efectos reversibles. Aunque la herramienta sea simulada, conviene validar los argumentos antes de aplicarlos y conservar tanto la solicitud como la respuesta de la herramienta. Para un flujo que pueda modificar datos, la evaluación debe comprobar el comportamiento de autorización y el tratamiento de instrucciones que no corresponden a la tarea, además de la respuesta textual.
Comparar condiciones sin confundir las causas
El diseño más informativo combina controles aislados y tareas integradas. En un control de texto, se presenta la información textual necesaria sin imagen; en otro, se solicita extraer datos de una imagen sin acción externa; en un tercero, se evalúa una llamada a herramienta con la información ya especificada. La condición combinada exige que el modelo obtenga la evidencia de la imagen, interprete la solicitud en el idioma correspondiente y decida qué hacer.
Los controles no demuestran por sí mismos que el sistema esté listo para operar. Sirven para localizar el origen probable de una degradación. Si el modelo extrae correctamente un campo cuando se le transcribe, pero no cuando aparece en una captura, el problema apunta a la interpretación visual. Si comprende el campo y la intención por separado pero falla al combinar una solicitud en otro idioma con la captura, la composición de capacidades merece atención. Si la decisión es correcta pero los argumentos no, el defecto está en la preparación de la llamada o en la interfaz entre el modelo y la herramienta.
Para que la comparación sea justa, usa la misma tarea y el mismo objetivo en todas las condiciones. Mantén constante la respuesta esperada y cambia sólo la modalidad o el factor lingüístico pertinente. Mezcla el orden de los casos y evita retocar las instrucciones después de revisar el conjunto reservado. En muestras pequeñas, informa los resultados por caso y por categoría en lugar de presentar una tasa agregada como si describiera un rendimiento general.
Una repetición del mismo caso puede revelar variabilidad, pero no convierte una prueba pequeña en evidencia universal. Hay que conservar los resultados de cada ejecución, incluyendo llamadas duplicadas, respuestas incompletas y fallos del entorno. La tasa de éxito debe definirse antes: por ejemplo, una tarea puede considerarse completa sólo si la evidencia es correcta, la acción autorizada se ejecutó con argumentos válidos y la respuesta final coincide con el resultado observado.
Secuencia de evaluación
- 01Ejecutar controles aislados de lectura, comprensión lingüística y uso de herramientas.
- 02Ejecutar tareas combinadas con las mismas referencias y límites de actuación.
- 03Guardar entradas, respuesta final, llamadas, argumentos, resultados de herramientas y tiempos.
- 04Revisar manualmente una muestra de aciertos, fallos y abstenciones antes de resumir las tasas.
- 05Repetir los casos afectados tras corregir la configuración, sin mezclar el conjunto de ajuste con el de aceptación.
Medir el éxito de extremo a extremo y el coste
Una sola métrica no describe suficientemente un agente multimodal. La evaluación debe registrar por separado si la evidencia visual se extrajo correctamente, si se entendió la solicitud, si se eligió la herramienta apropiada, si sus argumentos fueron válidos, si la ejecución produjo el resultado previsto y si la respuesta final se mantuvo fiel a ese resultado. Es posible acertar en una etapa y fallar en la siguiente; conservar esa distinción hace que las correcciones sean más concretas.
La abstención necesita su propia medida. Cuenta cuándo el modelo pide aclaración o indica que no puede determinar algo, y contrasta ese comportamiento con la suficiencia real de la evidencia. Una abstención ante una imagen ilegible puede ser adecuada; abstenerse ante un campo claro y una petición autorizada puede bloquear el flujo. Del mismo modo, una llamada innecesaria puede ser un fallo incluso si la herramienta devuelve una respuesta inocua.
Registra latencia y coste por tarea completada, además del consumo que la configuración permita observar. La documentación de Cohere explica el esquema de cobro y las unidades facturables, pero el coste aplicable debe verificarse para el canal y la tarifa vigentes. Un promedio por solicitud puede resultar engañoso si algunas tareas fallidas requieren reintentos o revisión humana. Por ello, conviene calcular también el coste de las tareas completadas correctamente y contabilizar el trabajo posterior.
No agregues todos los idiomas, imágenes y tipos de herramienta en una única cifra sin desgloses. Una media alta puede ocultar una categoría en la que el sistema lea mal identificadores o actúe sin evidencia. Presenta resultados por idioma, tipo de imagen, calidad de evidencia, decisión de herramienta y clase de error. Si el volumen no permite estimaciones estables, describe los resultados como observaciones del conjunto probado y no como una tasa fiable para producción.
Registro de métricas
Define cada métrica antes del ensayo y conserva los casos individuales para que un promedio no oculte errores de alto impacto.
| Métrica | Registro | Pregunta que responde |
|---|---|---|
| Evidencia visual | Campo esperado, campo extraído y ubicación o referencia anotada | ¿Leyó el dato que justifica la respuesta? |
| Decisión de herramienta | Herramienta elegida, llamada omitida o llamada innecesaria | ¿La acción era pertinente y estaba autorizada? |
| Argumentos y ejecución | Argumentos enviados, validación y resultado devuelto | ¿La herramienta recibió los datos correctos y produjo el efecto esperado? |
| Abstención | Casos de aclaración, rechazo o respuesta incierta, contrastados con la evidencia | ¿Actuó con cautela cuando faltaban datos y avanzó cuando sí los había? |
| Latencia y coste | Tiempo y unidades facturables disponibles por ejecución y tarea completada | ¿El flujo es viable al considerar fallos, reintentos y revisión? |
Clasificar fallos antes de decidir
Una lectura incorrecta de cifras o estados puede originarse en baja resolución, recorte, diseño visual o interpretación del modelo. Registra el fragmento relevante y la forma en que se presentó la imagen; no atribuyas automáticamente cada error a una limitación general de visión. Si el modelo responde con un dato que no aparece en la imagen, clasifica también si lo inventó, confundió con otro campo o dedujo de un contexto incompleto.
Los fallos lingüísticos pueden aparecer en la interpretación de la petición, en la lectura de contenido visual o en la respuesta final. Mantén separadas esas etapas. Una solicitud puede estar bien entendida aunque el modelo transcriba mal una etiqueta de la captura, y puede identificar correctamente el texto mientras interpreta mal qué acción pide la persona. Registrar el idioma de cada componente ayuda a encontrar patrones en tareas mezcladas.
En el uso de herramientas, distingue una elección innecesaria, una herramienta equivocada, un esquema mal formado, argumentos válidos pero incorrectos y una respuesta final que contradice el resultado devuelto. Esa clasificación señala si conviene modificar el diseño de la herramienta, las instrucciones, las comprobaciones previas o las reglas de autorización. Una herramienta bien seleccionada no compensa argumentos erróneos.
Un resultado convincente en las pruebas tampoco certifica seguridad universal. El corpus sólo cubre los casos que contiene y la configuración que se ensayó. Para un despliegue con consecuencias relevantes, las pruebas de comportamiento deben acompañarse de límites de acceso, validación de argumentos, trazabilidad y revisión humana adecuada al riesgo. Estas son recomendaciones operativas; no equivalen a una garantía del proveedor.
Criterios de aceptación y límites de la conclusión
Los criterios de aceptación deben ajustarse al impacto de cada tarea y fijarse antes de ver los resultados. Para una operación de bajo riesgo, una organización puede admitir una respuesta que pase por revisión antes de cambiar un registro. Para una acción irreversible o con efectos externos, una llamada no verificada puede ser inaceptable aunque la tasa global de acierto parezca elevada. El protocolo no prescribe un umbral universal: corresponde a cada equipo definir qué errores son tolerables y qué controles los contienen.
Una decisión prudente puede asignar a Command A+ tareas acotadas cuando el corpus representativo muestre extracción suficiente, argumentos válidos, abstenciones razonables y coste compatible con el proceso, siempre bajo los controles previstos. Si aparecen errores en ciertos idiomas, formatos o estados ambiguos, esos casos pueden reservarse para revisión humana o mantenerse fuera del alcance. La conclusión debe nombrar las condiciones aprobadas, no afirmar que el modelo es fiable en general.
La ficha de Cohere y sus guías deben revisarse de nuevo al cerrar el experimento para confirmar el identificador vigente, los canales disponibles, los formatos y límites aplicables, y la forma de configurar la solicitud. Si se evalúa un canal diferente o se modifica la versión, las conclusiones no se transfieren automáticamente. Un repositorio de pesos publicados puede ayudar a reproducir pruebas locales bajo las condiciones de su licencia, pero no hace que los resultados locales sean equivalentes a los obtenidos mediante una API.
La prueba propuesta tampoco determina por sí sola cómo se comportará el modelo con imágenes, idiomas, herramientas o niveles de riesgo que no se hayan incluido. Los trabajos de investigación sobre razonamiento multimodal multilingüe y encadenamiento visual pueden orientar el diseño del corpus, pero no reemplazan una evaluación actual del modelo en el entorno objetivo. La conclusión más sólida es acotada: qué funcionó, con qué configuración, en qué condiciones y qué errores impiden ampliar el uso.
Qué sigue abierto
- La documentación aportada identifica el modelo como command-a-plus-05-2026, pero el identificador vigente y los canales de acceso deben confirmarse al cierre de la evaluación.
- No se aporta aquí el listado completo de los 48 idiomas ni evidencia pública desglosada del rendimiento de Command A+ por idioma para las tareas descritas.
- Los formatos de imagen, límites de entrada y parámetros compatibles con una misma solicitud deben verificarse en la documentación vigente para el canal y la configuración elegidos.
- Las fuentes proporcionadas no demuestran el rendimiento de Command A+ en tareas que combinen visión, varios idiomas y uso de herramientas.
- El coste concreto depende del canal y de la tarifa vigente; debe verificarse para el caso medido y no inferirse sólo del esquema general de cobro.
- Los resultados con pesos publicados y los obtenidos mediante API no deben tratarse como equivalentes sin comprobar configuración, hardware y condiciones.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección