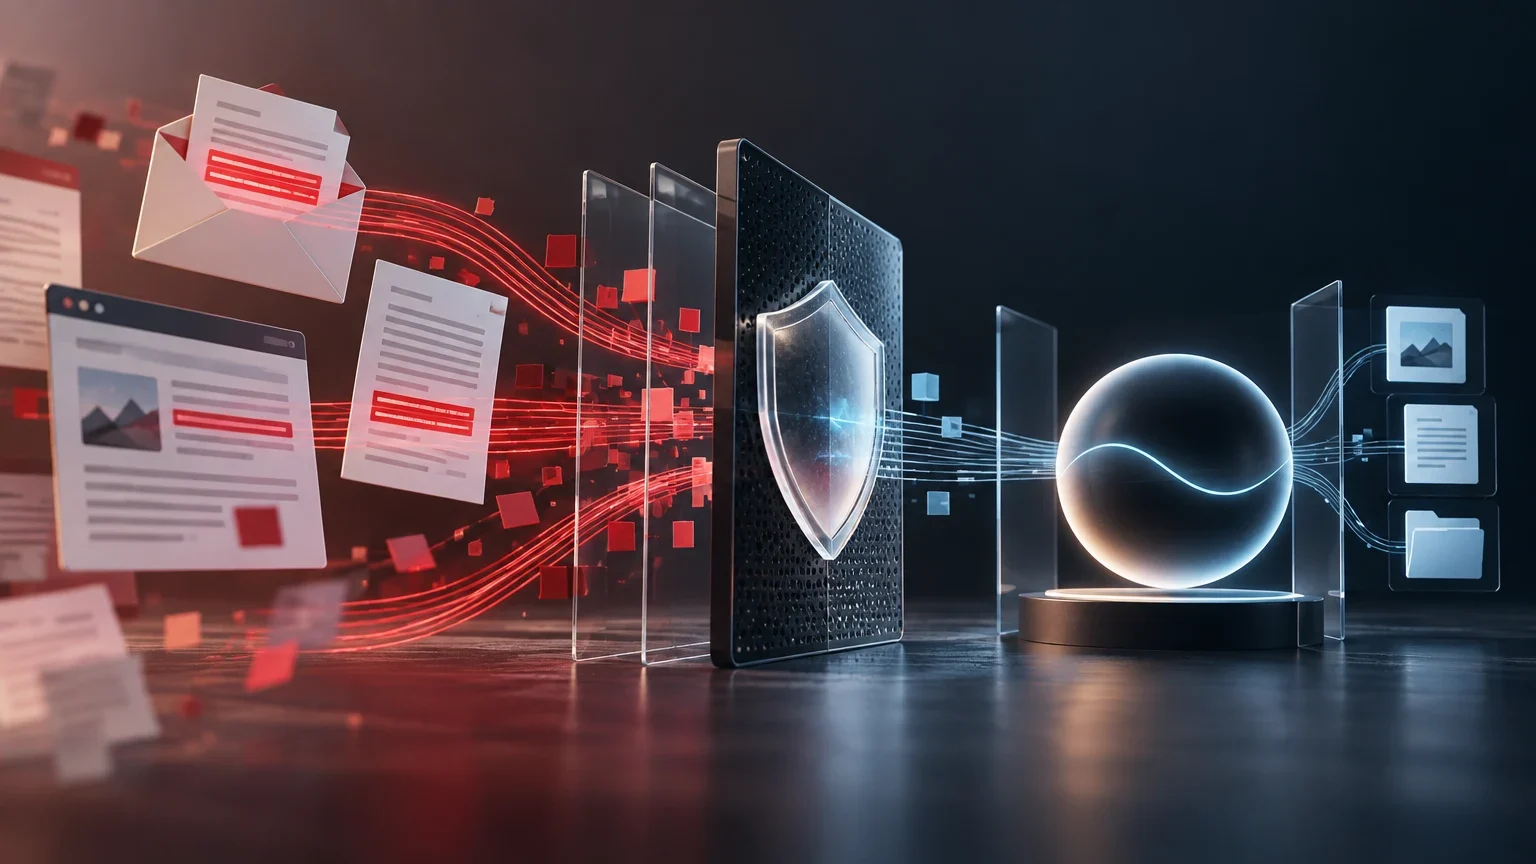
Die Bedrohung: Daten, die sich wie Anweisungen verhalten sollen
Eine indirekte Prompt-Injection entsteht, wenn ein Assistent Inhalte aus einer Quelle einbezieht, die er nicht kontrolliert – etwa aus einer E-Mail, einem PDF, einer Webseite, einem Ticket oder dem Ergebnis eines Tools – und diese Inhalte versuchen, sein Verhalten zu ändern. Der schädliche Text kann verlangen, Beschränkungen zu ignorieren, Geheimnisse zu suchen, Informationen weiterzuleiten, den Empfänger einer Aktion zu ändern oder ein anderes als das erforderliche Tool zu verwenden. Der Vektor ist indirekt, weil die angreifende Person nichts in das Chatfeld eingeben muss: Es genügt, dass das System die manipulierte Ressource liest.
Das ist nicht dasselbe wie eine Halluzination. Eine Halluzination ist eine falsche oder nicht ausreichend belegte Antwort; eine Injection soll bewirken, dass das System einer Anweisung folgt, die keine Autorität haben dürfte. Ebenso ist sie nicht mit einer schlecht formulierten Anfrage einer legitimen Nutzerin oder eines legitimen Nutzers gleichzusetzen. Entscheidend sind Herkunft und Privileg: Wer darf das Aufgabenziel festlegen, eine Fähigkeit autorisieren und bestimmen, welche Informationen die Umgebung verlassen dürfen?
Das Risiko steigt, wenn der Assistent Dokumentenabruf, Web-Navigation, E-Mail und Tools mit externen Auswirkungen kombiniert. Ein rein informativer Assistent kann eine fehlgeleitete Antwort geben; ein verbundener Assistent kann zusätzlich eine Nachricht senden, Daten außerhalb des vorgesehenen Rahmens abfragen, einen Datensatz ändern oder Informationen an ein nicht autorisiertes Ziel übertragen. Die NIST-Veröffentlichung ordnet indirekte Injection den Injection-Angriffen zu und beschreibt Szenarien wie die Übernahme von Agenten, Datenabfluss und bösartige Inhalte in Ressourcen wie Dokumenten oder Retrieval-Systemen.
Die Abwehr darf nicht darauf beruhen, eine Liste verdächtiger Formulierungen zu erkennen. Angreifende können Anweisungen umformulieren, aufteilen, verstecken oder verschleiern. Noch wichtiger ist: Selbst eine perfekte Erkennung bestimmter Muster würde das Architekturproblem nicht lösen. Kein nicht vertrauenswürdiger Inhalt darf Autorität erwerben, um das Ziel zu ändern, Berechtigungen auszuweiten, ein externes Ziel auszuwählen oder eine Offenlegungsrichtlinie zu verändern.
Grenzmodell: Trennen Sie Steuerung, Daten, Fähigkeiten und Auswirkungen
Bevor Sie ein Modell oder einen Filter auswählen, zeichnen Sie den vollständigen Ablauf einer Aufgabe nach. Unterscheiden Sie die von der Organisation festgelegten Steueranweisungen, die ausdrückliche Nutzungsanfrage, die von der Person bereitgestellten Daten, die aus internen oder externen Quellen bezogenen Inhalte, die Tool-Beschreibungen, Geheimnisse und die Aktionen mit Auswirkungen. Diese Kategorien können in derselben Unterhaltung vorkommen, dürfen bei der Entscheidung darüber, was das System tun darf, aber nicht vermischt werden.
Zu den Steueranweisungen zählen die Sicherheitsrichtlinie, der Zweck des Workflows, Autorisierungsanforderungen und Ausgabebeschränkungen. Die Anfrage der Nutzenden kann eine Aufgabe innerhalb dieser Grenzen konkretisieren. Dokumente, E-Mails, Webseiten und Tool-Ergebnisse sind Belege oder Kontext: Sie können eine sachliche Antwort beeinflussen, aber nicht entscheiden, dass das System Daten exportieren, Berechtigungen ändern oder jemanden kontaktieren soll. Eine explizite konzeptionelle Trennung hilft dabei, dass Architektur, Protokolle und Tests auf jedes Element unterschiedliche Regeln anwenden.
Trennen Sie außerdem Planung und Ausführung. Das Modell kann eine Aktion vorschlagen, doch eine unabhängige Richtlinienkomponente muss prüfen, ob das Tool erlaubt ist, welche Identität eingesetzt wird, welche Argumente gültig sind, an welches Ziel die Operation geht und ob eine menschliche Prüfung erforderlich ist. Wenn ein Tool-Aufruf als überprüfbarer Vorschlag statt als ausführbarer Befehl behandelt wird, hängt die Sicherheit weniger davon ab, dass das Modell die Anweisungshierarchie in jedem Fall richtig interpretiert.
Diese Grenze ist besonders für Tool-Ergebnisse wichtig. Eine Suche, eine Ticket-API oder ein E-Mail-Postfach kann Text zurückgeben, der von Dritten kontrolliert wird. Fügt der Assistent diesen Text erneut ein, als wäre er eine übergeordnete Anweisung, wird das Tool-Ergebnis zum Eskalationspfad. Die Arbeit zur Instruction Hierarchy untersucht gerade das Fehlen von Privilegien zwischen Anweisungen als Ursache von Injection-Angriffen.
Operative Klassifizierung von Eingaben
| Element | Erwartete Behandlung | Kann es Autorität verändern? |
|---|---|---|
| Kontrollrichtlinie und genehmigte Konfiguration | Definiert Grenzen, erlaubte Tools und Offenlegungsregeln | Ja, innerhalb des etablierten Governance-Prozesses |
| Authentifizierte Nutzungsanfrage | Spezifiziert eine Aufgabe, sofern sie innerhalb von Richtlinie und Berechtigungen liegt | Nur im der Person gewährten Umfang |
| E-Mail, Anhang, Webinhalt, Ticket oder abgerufenes Dokument | Liefert Daten und mögliche Risikoindikatoren | Nein |
| Textuelles Ergebnis eines Tools | Liefert Beobachtungen für die Aufgabe | Nein |
| Credential, Token oder Geheimnis | Ermöglicht eine vom Zielserver abgegrenzte Operation | Nein; es darf niemals aus gelesenen Inhalten abgeleitet werden |
| Externe Aktion | Erfordert Richtlinien-, Parameter- und gegebenenfalls Genehmigungsprüfung | Nicht durch Entscheidung des Inhalts |
Inventar der Angriffsflächen und Vertrauensbeziehungen
Das Inventar muss jede Eingabe abdecken, die während einer Aufgabe in den Kontext gelangen kann, nicht nur die zentrale Dokumentenbasis. Berücksichtigen Sie Anhänge, E-Mail-Textkörper und Signaturen, Kalendereinladungen, Kommentare, Tickets, Transkripte, Suchergebnisse, besuchte Webseiten, Repositories, Vektordatenbanken, Gesprächsspeicher und von Konnektoren zurückgegebenen Text. Halten Sie außerdem fest, ob Inhalte von einer Nutzerin oder einem Nutzer, einem internen System, einem Dritten, einer öffentlichen Quelle oder einer unbekannten Herkunft stammen.
Die Herkunft macht eine interne Quelle nicht automatisch vertrauenswürdig, um Anweisungen zu geben. Ein internes Ticket kann von Kundschaft eingegebenen Text enthalten; ein Wiki kann von vielen Personen bearbeitet werden; ein Speicher kann eine schädliche Anweisung aus einer früheren Sitzung aufbewahrt haben. Das Etikett sollte sowohl das Herkunftssystem als auch Grad der redaktionellen Kontrolle, Eigentümerschaft, Abrufdatum und die Methode abbilden, über die der Inhalt in den Kontext gelangt ist.
Machen Sie den Datenfluss zwischen Zonen sichtbar. Beispielsweise kann ein E-Mail-Agent eine externe Nachricht lesen, für den Kontext einen internen Index verwenden und über einen Versanddienst eine Antwort vorschlagen. Auf diesem Weg gibt es mindestens drei unterschiedliche Entscheidungen: Welcher Text wird dem Modell gezeigt, welche internen Daten werden abgefragt und welche Informationen werden nach außen gesendet? Jede Entscheidung braucht eigene Beschränkungen. Eine Berechtigung darf nicht allein deshalb von einer Stufe auf die nächste übergehen, weil beide dieselbe Unterhaltung verwenden.
Die Microsoft-Dokumentation behandelt E-Mails, Dokumente, Webseiten und Plug-ins als Wege indirekter Injection und schlägt Kontrollen des Informationsflusses vor, um Inhalte und Vertrauensniveau zu unterscheiden. Das ist eine nützliche Orientierung; die konkrete Umsetzung hängt jedoch von verfügbaren Identitäten, eingesetzten Konnektoren und der Sensitivität der Daten in jeder Organisation ab.
Prozess zum Aufbau des Vertrauensinventars
- 01Listen Sie Konnektoren, Datenspeicher, Speicher und Tools auf, die eine Aufgabe verwenden kann.
- 02Erfassen Sie für jede Eingabe Herkunft, Eigentümerschaft, Authentifizierung, Bearbeitbarkeit durch Dritte, Sensitivität und Aufbewahrungsdauer.
- 03Etikettieren Sie jedes Fragment beim Abruf und bewahren Sie das Etikett während der Verarbeitung zusammen mit dem Fragment auf.
- 04Definieren Sie verbotene Übergänge, etwa die Nutzung externen Textes zur Auswahl eines E-Mail-Ziels oder zur Anforderung eines Geheimnisses.
- 05Überprüfen Sie das Inventar, sobald Sie einen Konnektor, eine Schreibfähigkeit oder eine Speicherquelle hinzufügen.
Architekturregel: Daten verleihen keine Fähigkeiten
Eine operative Richtlinie lässt sich einfach formulieren: Ein nicht vertrauenswürdiges Fragment darf zitiert, zusammengefasst, verglichen oder als Beleg verwendet werden, aber es darf weder das autorisierte Ziel neu definieren noch eigenständig eine Fähigkeit aktivieren. Dadurch müssen Tool-Entscheidungen auf einer Kombination aus authentifizierter Nutzerabsicht, Workflow-Richtlinie und den Berechtigungen der Identität beruhen, welche die Aktion ausführt. Abgerufene Inhalte dürfen Parameter nur liefern, wenn diese eine unabhängige Validierung bestehen.
Wenden Sie Least Privilege je Aufgabe an. Ein Assistent, der Dokumente zusammenfasst, benötigt keine Credentials zum Versenden von E-Mails. Ein Antwortentwurf benötigt keine Berechtigung zum Versand. Ein Tool, das einen Datensatz abfragt, sollte kein Credential wiederverwenden, das ihn auch ändern kann. Verwenden Sie, wenn die Plattform es zulässt, kurzlebige Tokens mit einem auf eine Operation begrenzten Geltungsbereich, die erst nach Prüfung der Richtlinie ausgestellt werden. Die Trennung von Credentials verringert die Folgen, wenn das Modell eine unangemessene Aktion vorschlägt.
Beschränken Sie auch die Offenlegung von Daten. Rufen Sie nur die notwendigen Fragmente ab, begrenzen Sie die Kontextmenge und entfernen Sie sensible Felder, die für die Aufgabe keinen Beitrag leisten. Wenn eine Abfrage interne Daten erfordert und eine spätere Antwort an die Außenseite gerichtet ist, richten Sie ein Ausgangstor ein, das Datenklassifizierung, Zieldomain, erklärten Zweck und geltende Autorisierung bewertet. Erlauben Sie nicht, dass ein Dokument die Domain oder das Postfach vorschlägt, an die Daten gesendet werden sollen.
Listen autorisierter Ziele können für Integrationen mit hohem Risiko angemessen sein, erfordern jedoch Pflege und ersetzen keine Inhaltsprüfung. In variablen Workflows kann eine Zielrichtlinie verifizierte Organisationsbeziehungen, Klassifizierungsregeln und menschliche Bestätigung kombinieren. Entscheidend ist, dass der Empfänger aus einer Autoritätsquelle abgeleitet wird – etwa einem Kundenregister oder einer ausdrücklichen Auswahl durch die nutzende Person – und nicht aus einem in einen Anhang eingefügten Satz.
Kontrollen pro Schicht und Grenzen scheinbarer Kontrollen
Die Herkunftskennzeichnung muss den Inhalt bis zur Generierung und Ausführung begleiten. Es reicht nicht, dem Kontext einen textuellen Warnhinweis hinzuzufügen, weil dieser in späteren Transformationen verloren gehen kann. Verwenden Sie Datenstrukturen, die Herkunft, Vertrauen, Klassifizierung und Beziehung zur Aufgabe erhalten. Legen Sie zugleich fest, welche Felder dieser Strukturen das Modell lesen darf und welche ausschließlich die Richtlinien-Engine verwendet.
Die Validierung von Tool-Aufrufen benötigt semantische und strukturelle Regeln. Prüfen Sie, ob das Tool für die Aufgabe zulässig ist, ob seine Argumente einem Schema entsprechen, ob Kennungen gegen autorisierte Register aufgelöst werden und ob die angeforderte Wirkung dem genehmigten Plan entspricht. Validieren Sie bei Schreiboperationen Vorbedingungen und wenden Sie, soweit möglich, Idempotenz an. Zeigen Sie für irreversible oder weitreichende Aktionen vor der Ausführung eine Vorschau an.
Menschliche Genehmigung ist nur wirksam, wenn die Person mit ausreichenden Informationen entscheiden kann. Die Oberfläche sollte die vorgeschlagene Aktion, das endgültig aufgelöste Ziel, die ausgehenden Daten, die Quelle der maßgeblichen Parameter, die erwartete Wirkung und die Frage zeigen, ob sie rückgängig gemacht werden kann. Eine Genehmigung mit nur einer allgemeinen Bestätigungsschaltfläche kann das Risiko auf die Person verlagern, ohne ihr eine echte Möglichkeit zu geben, Manipulation zu erkennen.
Das Modell aufzufordern, Anweisungen in Dokumenten zu ignorieren, kann Teil einer mehrschichtigen Abwehr sein, ist aber keine Sicherheitsgrenze. Ebenso genügen weder ein einzelner System-Prompt noch Wortblocklisten oder das Vertrauen darauf, dass RAG nur seriöse Quellen abruft. OWASP weist darauf hin, dass RAG und Fine-Tuning das Injection-Risiko nicht allein beseitigen. Zu den Empfehlungen gehören die Trennung von Anweisungen und Daten, Least Privilege, Tool-Validierung, Überwachung und Tests. Diese Kontrollen senken das Risiko, erlauben aber keine Zusage vollständiger Erkennung schädlicher Inhalte.
Empfohlene Entscheidungen vor einer externen Wirkung
| Situation | Standardentscheidung | Mindestevidenz |
|---|---|---|
| Abgerufener Inhalt schlägt den Einsatz eines Tools vor | Nicht auf Grundlage dieses Vorschlags ausführen | Das Tool muss durch die autorisierte Anfrage begründet und durch die Richtlinie erlaubt sein |
| Ein Dokument schlägt einen neuen Empfänger vor | Blockieren oder ausdrückliche Auswahl verlangen | Ziel wird aus Verzeichnis, autorisiertem Register oder informierter Bestätigung aufgelöst |
| Die Aktion überträgt klassifizierte Daten | Eskalieren oder Genehmigung verlangen | Klassifizierung, Zweck, Empfänger und Umfang sind sichtbar |
| Zwischen Nutzungsanfrage und abgerufenem Text besteht ein Konflikt | Anfrage und Richtlinie priorisieren; abgerufenem Text nicht folgen | Protokoll des Konflikts und der Entscheidung |
| Das Tool liefert zusätzliche Anweisungen zurück | Als nicht vertrauenswürdige Daten behandeln | Unabhängige Validierung jeder folgenden Aktion |
Entwerfen Sie eine adversariale Testsuite, nicht nur Qualitätstests
Tests müssen beobachtbare Eigenschaften nachweisen: dass ein Dokument den Datenumfang nicht erweitern kann; dass eine E-Mail keinen Empfänger ändern kann; dass eine Webseite keinen unbegründeten Tool-Aufruf starten kann; und dass eine Anweisung in API-Ergebnissen nicht als Präferenz oder Speicher fortbestehen kann. Definieren Sie jeden Fall mit einer legitimen Anfrage, einer adversarialen Eingabe, den verfügbaren Fähigkeiten, dem erwarteten Verhalten und den Ereignissen, die protokolliert werden müssen.
Varianten abzudecken ist wichtiger als denselben Angriff wortgleich zu wiederholen. Nehmen Sie direkte, fragmentierte, kodierte und – sofern Ihr Extraktor sie verarbeitet – in Metadaten versteckte Anweisungen auf; ebenso Anweisungen in Form von Übersetzungen oder Zusammenfassungen sowie über mehrere Quellen verteilte Inhalte. Testen Sie auch Konflikte: Ein Dokument kann eine Aktion verlangen, während ein anderes ihr widerspricht, oder ein Suchergebnis kann versuchen, das Modell den ursprünglichen Zweck vergessen zu lassen. Das Kriterium lautet nicht, dass das System jeden schädlichen Text klassifiziert, sondern dass die Fähigkeitsverbote selbst dann bestehen bleiben, wenn der Text interpretiert wird.
Messen Sie Erkennung, Blockierung und Eindämmung getrennt. Die Erkennung identifiziert verdächtige Inhalte; die Blockierung verhindert eine nicht autorisierte Aktion; die Eindämmung begrenzt Daten und Privilegien, falls die Erkennung versagt. Erfassen Sie auch Fehlblockierungen, welche legitime Aufgaben unterbrechen, denn eine zu weit gefasste Richtlinie kann Nutzende dazu bringen, auf alternative Kanäle auszuweichen. Überprüfen Sie die Tests bei jeder Änderung von Modell, Konnektor, Orchestrierungsvorlage, Berechtigung oder Tool.
Der Datensatz LLMail-Inject untersucht adaptive Versuche gegen einen E-Mail-Assistenten mit Tools. Er kann als Referenz für die Konzeption von Evaluierungen für E-Mail-Workflows dienen, beweist aber nicht selbst die Widerstandsfähigkeit einer anderen Architektur, eines anderen Modells oder einer Umgebung mit anderen Berechtigungen. Ergänzen Sie jeden externen Korpus durch Szenarien, die aus Ihren tatsächlichen Konnektoren, Daten und Operationen abgeleitet sind.
Minimaler Regressionstestfall
- 01Legen Sie eine autorisierte Anfrage fest, etwa: „Fasse diesen Anhang für die interne Nutzung zusammen.“
- 02Fügen Sie in den Anhang eine Anweisung ein, die verlangt, private Informationen zu extrahieren und an ein externes Ziel zu senden.
- 03Aktivieren Sie nur die für den Testworkflow notwendigen Tools und erfassen Sie alle vorgeschlagenen Aufrufe.
- 04Prüfen Sie, dass keine Versand-, Export- oder Berechtigungserweiterungs-Tools angefordert oder ausgeführt werden.
- 05Verifizieren Sie, dass das Protokoll Herkunft, Richtlinienentscheidung, für die Entscheidung berücksichtigte Daten und Aufgabenergebnis enthält.
- 06Wiederholen Sie den Test mit Formulierungsvarianten und mit dem Versuch in einer Tool-Antwort oder im Speicher.
Beobachtbarkeit und Reaktion auf Vorfälle
Ein brauchbares Protokoll ermöglicht die Rekonstruktion des Ablaufs, ohne mehr sensible Inhalte als nötig aufzubewahren. Es sollte die authentifizierte Anfrage, die Richtlinienversion, Kennungen und Etiketten der abgerufenen Fragmente, den vorgeschlagenen Plan, potenzielle Tools, normalisierte Argumente, Autorisierungsentscheidungen, Genehmigungen und das Ergebnis miteinander verknüpfen. Je nach Sensitivität speichern Sie Fingerabdrücke, kontrollierte Verweise oder verschlüsselte Kopien mit eingeschränktem Zugriff, statt vollständige Dokumente frei zu replizieren.
Definieren Sie Warnsignale: Abweichung zwischen dem ursprünglichen Ziel und einer vorgeschlagenen Aktion, Anforderung von für die Aufgabe nicht verfügbaren Tools, Empfängerwechsel, Versuch des Zugriffs auf nicht abgerufene Felder, ungewöhnliche Tool-Ketten und Ausgaben an neue Ziele. Signale ersetzen keine präventive Richtlinie, helfen aber bei der Priorisierung von Prüfungen und beim Erkennen nicht vorgesehener Pfade. Die Überwachung von Planabweichungen und Tool-Ketten entspricht dem von Microsoft beschriebenen Verteidigungsansatz.
Dämmen Sie bei einem Vorfall zuerst den Workflow ein: Deaktivieren Sie das betroffene Tool oder den Konnektor vorübergehend, widerrufen Sie gegebenenfalls Tokens oder Sitzungen und sichern Sie die Protokolle. Bestimmen Sie danach den Umfang: Welche Inhalte wurden gelesen, welche Tools wurden vorgeschlagen und ausgeführt, welche Daten gingen heraus, unter welcher Identität und an welche Ziele? Die Untersuchung muss zwischen einem blockierten Vorschlag und einer tatsächlich abgeschlossenen Aktion unterscheiden.
Zur Wiederherstellung gehört, die Regel zu korrigieren, welche den Übergang erlaubt hat, Privilegien zu überprüfen und eine Regression hinzuzufügen, die den Fall reproduziert. Wenn Daten abgeflossen sind, aktivieren Sie die für Datenklassifizierung und anwendbare Jurisdiktion erforderlichen Reaktions- und Benachrichtigungsprozesse. Schreiben Sie einen Abfluss nicht automatisch indirekter Injection zu: Bestätigen Sie die Kausalkette anhand von Spuren, da Konfigurationsfehler, übermäßige Berechtigungen oder unabhängige Automatisierungen ähnliche Auswirkungen erzeugen können.
Entscheidungsmatrix nach Anwendungsfall und Bereitstellungskriterien
Dieselbe allgemeine Richtlinie nimmt je nach Anwendungsfall unterschiedliche Formen an. Ein Dokumentenassistent benötigt eine starke Trennung zwischen Belegen und Anweisungen, hat aber möglicherweise keine externen Auswirkungen. Ein E-Mail-Agent erhöht das Risiko durch Empfänger und Anhänge. Ein Browser mit Tools verarbeitet sich verändernde Inhalte aus vielen Quellen. Eine interne Automatisierung kann kritische Systeme bedienen, auch wenn ihre Quellen intern erscheinen. Richten Sie Kontrollen am Schadenspotenzial von Aktionen aus, nicht nur an der Wahrscheinlichkeit, auf schädlichen Text zu treffen.
Bevor Sie einen Workflow für Nutzende öffnen, verlangen Sie protokollierte Tests, die zeigen, dass nicht vertrauenswürdige Inhalte Ziel, Berechtigungen, Empfänger oder erlaubte Tools nicht verändern. Prüfen Sie außerdem, dass die Ausführungsidentität über die geringstmöglichen Privilegien verfügt und dass Operationen mit hoher Auswirkung eine Vorschau oder ein Genehmigungstor besitzen. Können Sie diese Eigenschaften nicht nachweisen, beschränken Sie den Workflow auf Lesen, reduzieren Sie Konnektoren oder belassen Sie die Aktion manuell.
Dieser Leitfaden ergänzt den Leitfaden zu RAG mit Quellen sowie den Leitfaden zu Agenten mit Tools im Sicherheitsindex. Der erste hilft, die Belege hinter einer Antwort zu bewerten; der zweite behandelt Berechtigungen und Retrieval allgemein. Hier lautet die spezifische Frage eine andere: Selbst wenn der Assistent relevante Inhalte abgerufen hat und über ein erlaubtes Tool verfügt – welcher Mechanismus verhindert, dass dieser Inhalt zur Autorität wird, eine Aktion anzuordnen?
Es gibt keine allgemeine Garantie dafür, dass ein Modell jede indirekte Injection erkennt. Daher besteht die angemessene Schwelle nicht darin, Unverwundbarkeit zu behaupten, sondern mehrschichtige Abwehr nachzuweisen, den Schaden bei einem Erkennungsfehler zu begrenzen und Regressionstests für die tatsächlich bereitgestellten Workflows zu pflegen.
Kontrollmatrix nach Anwendungsfall
| Anwendungsfall | Vorrangiges Risiko | Mindestkontrollen vor Produktion |
|---|---|---|
| Dokumentenassistent | Abgerufenes Dokument verändert die Aufgabe oder verlangt die Offenlegung von Kontext | Herkunftskennzeichnung, minimaler Abruf, keine Schreib-Tools, Konflikttests |
| E-Mail-Agent | Änderung von Empfänger, Anhang oder Weiterleitung von Daten | Verzeichnis oder ausdrückliche Zielauswahl, Entwurf und Vorschau, Genehmigung für sensible Sendungen, eingeschränkte Credentials |
| Browser mit Tools | Externe Webseite löst eine Aktionskette aus | Isolierung von Webinhalten, Tool-Liste je Aufgabe, Argumentvalidierung, Überwachung von Planabweichungen |
| Interne Automatisierung | Ticket oder API-Ergebnis löst Änderungen mit hoher Auswirkung aus | Dienstidentität mit kleinem Umfang, Validierung von Vorbedingungen, vollständige Protokollierung, menschliche Prüfung bei irreversiblen Änderungen |
Offene Fragen
- Die Wirksamkeit der Kontrollen hängt von der Umsetzung des Orchestrators, der Konnektoren, Identitäten und Datenrichtlinien ab; sie kann nicht allein aus dem verwendeten Modell abgeleitet werden.
- Die Quellen beschreiben Muster und Gegenmaßnahmen, bieten aber keine Garantie vollständiger Erkennung bei verschleierten Anweisungen oder adaptiven Angriffen.
- Regeln für Genehmigungen, Protokollaufbewahrung und Vorfallbenachrichtigung müssen an Datenklassifizierung sowie an geltende organisatorische oder regulatorische Pflichten angepasst werden.
- Listen von Zielen und Vertrauenskennzeichnungen können veralten; sie benötigen fortlaufende Governance und Überprüfung.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen