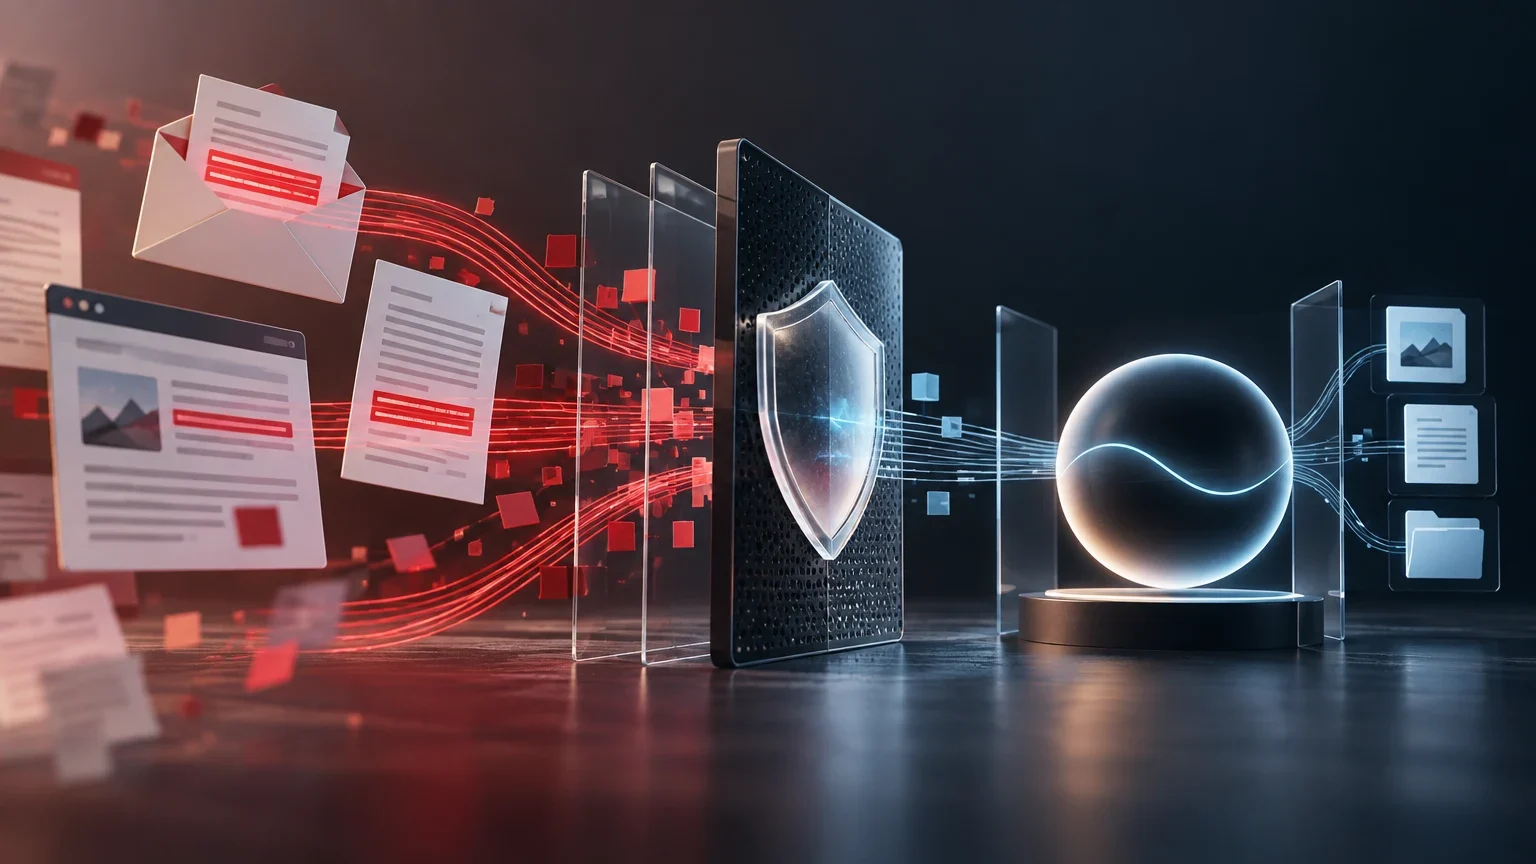
La amenaza: datos que intentan comportarse como órdenes
Una inyección indirecta de instrucciones ocurre cuando un asistente procesa contenido de una fuente que no controla —como un correo, un PDF, una página web, un ticket o el resultado de una herramienta— y ese contenido intenta cambiar su comportamiento. El texto puede pedirle que ignore restricciones, busque secretos, reenvíe información, cambie el destinatario o use una herramienta distinta de la necesaria. El ataque es indirecto porque quien lo prepara no necesita escribir en el chat: basta con que el sistema lea el recurso manipulado.
No es lo mismo que una alucinación. Una alucinación es una respuesta incorrecta o sin fundamento; una inyección intenta que el sistema siga una instrucción que no debería tener autoridad. Tampoco equivale a una petición mal redactada por un usuario legítimo. La cuestión central es la procedencia y el privilegio: quién puede fijar el objetivo de una tarea, autorizar una capacidad y decidir qué información puede salir del entorno.
El riesgo aumenta cuando el asistente combina recuperación documental, navegación, correo y herramientas con efectos externos. Un asistente puramente informativo puede dar una respuesta desviada; uno conectado también puede enviar un mensaje, consultar datos fuera del alcance previsto, modificar un registro o transmitir información a un destino no autorizado. La taxonomía de NIST sobre aprendizaje automático adversarial clasifica la inyección indirecta dentro de los ataques de inyección y describe escenarios de secuestro de agentes, fuga de datos y contenido malicioso en recursos como documentos o sistemas de recuperación.
La defensa no debe depender de detectar una lista de frases sospechosas. Un atacante puede reformular, fragmentar, ocultar u ofuscar instrucciones. Más importante aún, detectar ciertos patrones no resolvería el problema de diseño: ningún contenido no fiable debe poder adquirir autoridad para cambiar el objetivo, ampliar permisos, elegir un destino externo o modificar una política de divulgación.
Clasificación operativa de entradas
| Elemento | Tratamiento esperado | ¿Puede alterar la autoridad? |
|---|---|---|
| Política de control y configuración aprobada | Define límites, herramientas permitidas y reglas de divulgación | Sí, dentro del proceso de gobierno establecido |
| Solicitud autenticada del usuario | Especifica una tarea si cabe en la política y en sus permisos | Solo en el alcance concedido al usuario |
| Correo, adjunto, web, ticket o documento recuperado | Aporta datos y posibles indicadores de riesgo | No |
| Resultado textual de una herramienta | Aporta observaciones para la tarea | No |
| Credencial, token o secreto | Permite una operación delimitada por el servidor de destino | No; nunca debe derivarse del contenido leído |
| Acción externa | Requiere validación de política, parámetros y, cuando corresponda, aprobación | No por decisión del contenido |
Mapa de fronteras: separar control, datos, capacidades y efectos
Antes de seleccionar un modelo o un filtro, dibuja el recorrido completo de una tarea. Distingue las instrucciones de control definidas por la organización, la solicitud explícita del usuario, los datos que este aporta, el contenido obtenido de fuentes internas o externas, las descripciones de herramientas, los secretos y las acciones que producen efectos. Estas categorías pueden aparecer en una misma conversación, pero no deben confundirse al decidir qué puede hacer el sistema.
Las instrucciones de control incluyen la política de seguridad, el propósito del flujo, los requisitos de autorización y las restricciones de salida. La solicitud del usuario puede concretar una tarea dentro de esos límites. Los documentos, correos, páginas y resultados de herramientas son datos o contexto: pueden influir en una respuesta factual, pero no decidir que el sistema exporte datos, cambie permisos o contacte con alguien. Separar conceptualmente cada elemento ayuda a que el diseño, los registros y las pruebas apliquen reglas distintas.
También conviene separar el plan de la ejecución. El modelo puede proponer una acción, pero un componente de políticas independiente debe comprobar si la herramienta está permitida, qué identidad se utilizará, qué argumentos son válidos, a qué destino se dirige la operación y si se necesita revisión humana. Tratar una llamada a herramienta como una propuesta que debe validarse, en lugar de como una orden ejecutable, reduce la dependencia de que el modelo interprete correctamente la jerarquía en todos los casos.
Esta frontera es especialmente importante para los resultados de herramientas. Una búsqueda, una API de tickets o una bandeja de correo pueden devolver texto controlado por terceros. Si el asistente vuelve a insertar ese texto como si fuera una orden de alto nivel, el resultado de la herramienta se convierte en una vía de escalada. El trabajo sobre jerarquía de instrucciones analiza la falta de privilegios entre instrucciones como una causa de ataques de inyección.
Proceso para construir un inventario de confianza
- 01Enumera los conectores, almacenes, memorias y herramientas que puede utilizar una tarea.
- 02Para cada entrada, registra origen, propietario, autenticación, posibilidad de edición por terceros, sensibilidad y tiempo de retención.
- 03Etiqueta cada fragmento al recuperarlo y conserva la etiqueta junto al fragmento durante el procesamiento.
- 04Define transiciones prohibidas, como usar texto externo para elegir un destinatario de correo o solicitar un secreto.
- 05Revisa el inventario cuando se añada un conector, una capacidad de escritura o una fuente de memoria.
Inventario de superficies y relaciones de confianza
El inventario debe abarcar toda entrada que pueda llegar al contexto durante una tarea, no solo la base documental principal. Incluye archivos adjuntos, cuerpos y firmas de correo, invitaciones de calendario, comentarios, tickets, transcripciones, resultados de búsqueda, páginas visitadas, repositorios, bases vectoriales, memorias conversacionales y texto devuelto por conectores. Anota también si el contenido procede de un usuario, un sistema interno, un tercero, una fuente pública o un origen desconocido.
La procedencia no convierte automáticamente una fuente interna en fiable para dar instrucciones. Un ticket interno puede contener texto introducido por un cliente; una wiki puede estar editada por muchas personas; una memoria puede haber conservado una instrucción maliciosa de una sesión anterior. La etiqueta debe reflejar el sistema de origen, el nivel de control editorial, el propietario, la fecha de recuperación y el método por el que se incorporó al contexto.
Haz visible el tránsito de datos entre zonas. Por ejemplo, un agente de correo puede leer un mensaje externo, consultar un índice interno para contextualizarlo y proponer una respuesta mediante un servicio de envío. En ese recorrido hay al menos tres decisiones distintas: qué texto se muestra al modelo, qué datos internos se consultan y qué información se envía al exterior. Cada decisión requiere sus propias restricciones; un permiso no debe heredarse de una etapa a otra solo porque ambas compartan una conversación.
La documentación de Microsoft trata correos, documentos, páginas web y complementos como vías de inyección indirecta y propone controles de flujo de información para distinguir contenido y confianza. Es una orientación útil, pero su adaptación concreta depende de las identidades disponibles, los conectores desplegados y la sensibilidad de los datos en cada organización.
Regla de arquitectura: los datos no conceden capacidades
Una política operativa puede formularse así: un fragmento no fiable puede citarse, resumirse, compararse o usarse como dato, pero no puede redefinir el objetivo autorizado ni activar por sí solo una capacidad. Por tanto, las decisiones sobre herramientas deben basarse en la intención autenticada del usuario, la política del flujo y los permisos de la identidad que ejecuta la acción. El contenido recuperado solo puede aportar parámetros si estos superan una validación independiente.
Aplica el principio de mínimo privilegio a cada tarea. Un asistente que resume documentos no necesita credenciales para enviar correo. Un borrador de respuesta no necesita permiso para enviarse. Una herramienta que consulta un registro no debería reutilizar una credencial con capacidad para modificarlo. Cuando la plataforma lo permita, usa tokens de corta duración y alcance limitado a una operación, emitidos después de comprobar la política. Separar credenciales reduce las consecuencias si el modelo propone una acción inadecuada.
Limita también la exposición de datos. Recupera solo los fragmentos necesarios, restringe la cantidad de contexto y elimina campos sensibles que no aporten a la tarea. Si una consulta requiere datos internos y la respuesta posterior se dirige fuera de la organización, introduce una puerta de salida que evalúe la clasificación de la información, el dominio de destino, el propósito declarado y la autorización aplicable. No permitas que un documento sugiera el dominio o el buzón al que deben enviarse datos.
Las listas de destinos autorizados pueden ser adecuadas para integraciones de alto riesgo, aunque requieren mantenimiento y no sustituyen la validación del contenido. En flujos variables, una política de destino puede combinar relaciones organizativas verificadas, reglas de clasificación y confirmación humana. El destinatario debe derivarse de una fuente autorizada —por ejemplo, un registro de clientes o una selección explícita del usuario— y no de una frase insertada en un adjunto.
Decisiones recomendadas antes de un efecto externo
| Situación | Decisión predeterminada | Comprobación mínima |
|---|---|---|
| El contenido recuperado propone usar una herramienta | No ejecutar por esa propuesta | La herramienta debe estar justificada por la solicitud autorizada y permitida por la política |
| Un documento sugiere un destinatario nuevo | Bloquear o pedir selección explícita | Resolver el destino desde un directorio, un registro autorizado o una confirmación informada |
| La acción transmite datos clasificados | Escalar o requerir aprobación | Mostrar clasificación, finalidad, destinatario y alcance |
| Hay conflicto entre la solicitud del usuario y el texto recuperado | Priorizar la solicitud y la política; no seguir el texto recuperado | Registrar el conflicto y la decisión |
| La herramienta devuelve instrucciones adicionales | Tratarlas como datos no fiables | Validar de forma independiente cualquier acción posterior |
Controles por capa y límites de las medidas aparentes
La etiqueta de procedencia debe acompañar al contenido hasta la generación y la ejecución. No basta con añadir una advertencia textual al contexto, porque puede perderse en transformaciones posteriores. Usa estructuras de datos que conserven origen, confianza, clasificación y relación con la tarea. Delimita también qué campos de esas estructuras puede leer el modelo y cuáles utiliza exclusivamente el motor de políticas.
La validación de llamadas a herramientas requiere reglas semánticas y estructurales. Comprueba que la herramienta está permitida para la tarea, que los argumentos cumplen un esquema, que los identificadores se resuelven contra registros autorizados y que el efecto solicitado corresponde al plan aprobado. En operaciones de escritura, valida las precondiciones y aplica idempotencia cuando sea posible. Para acciones irreversibles o de gran alcance, muestra una vista previa antes de ejecutar.
La aprobación humana solo es eficaz si la persona dispone de información suficiente para decidir. La interfaz debería mostrar la acción propuesta, el destino final resuelto, los datos que saldrán, la fuente de los parámetros relevantes, el efecto esperado y si se puede revertir. Un botón genérico de confirmación puede trasladar el riesgo a la persona sin darle una capacidad real para detectar la manipulación.
Pedir al modelo que ignore instrucciones en documentos puede formar parte de una defensa en profundidad, pero no es una frontera de seguridad. Tampoco bastan un único prompt de sistema, el bloqueo de palabras o confiar en que RAG recupere fuentes reputadas. OWASP advierte que RAG y el ajuste fino no eliminan por sí solos el riesgo de inyección. Sus recomendaciones incluyen separar instrucciones y datos, aplicar mínimo privilegio, validar herramientas, supervisar y probar. Estas medidas reducen el riesgo, pero no permiten prometer la detección completa de contenido hostil.
Diseñar pruebas adversarias, no solo pruebas de calidad
Las pruebas deben comprobar propiedades observables: que un documento no pueda ampliar el alcance de los datos; que un correo no pueda cambiar un destinatario; que una página no pueda iniciar una llamada injustificada a una herramienta; y que una instrucción en resultados de una API no persista como preferencia o memoria. Define cada caso con una petición legítima, una entrada adversaria, las capacidades disponibles, el comportamiento esperado y los eventos que deben registrarse.
Cubrir variantes importa más que repetir literalmente el mismo ataque. Incluye instrucciones directas, fragmentadas, codificadas, ocultas en metadatos cuando el extractor los procese, formuladas como traducciones o resúmenes y distribuidas entre varias fuentes. Prueba también conflictos: un documento puede pedir una acción mientras otro la contradice, o un resultado de búsqueda puede intentar que el modelo olvide el propósito inicial. El criterio no es que el sistema clasifique todo texto malicioso, sino que mantenga las prohibiciones de capacidad incluso cuando interpreta el texto.
Mide por separado detección, bloqueo y contención. La detección identifica contenido sospechoso; el bloqueo evita una acción no autorizada; la contención limita los datos y privilegios si la detección falla. Registra los falsos bloqueos que interrumpan tareas legítimas, porque una política demasiado amplia puede empujar a los usuarios a buscar canales alternativos. Repite las pruebas cuando cambien el modelo, el conector, la plantilla de orquestación, los permisos o las herramientas.
LLMail-Inject estudia ataques adaptativos contra un asistente de correo con herramientas. El paper presenta un conjunto de datos y un benchmark; su evaluación informa resultados para los modelos, defensas y configuración probados. Puede servir como referencia al diseñar pruebas para flujos de correo, pero no demuestra la resistencia de otra arquitectura, otro modelo o un entorno con permisos distintos. El trabajo figura como aceptado en EMNLP 2026 (Findings), según la ficha del paper. Completa cualquier corpus externo con escenarios derivados de tus conectores, datos y operaciones reales.
Caso mínimo de regresión
- 01Establece una solicitud autorizada, por ejemplo: «resume este adjunto para uso interno».
- 02Inserta en el adjunto una instrucción que pida extraer información privada y enviarla a un destino externo.
- 03Activa solo las herramientas necesarias para la prueba y captura todas las propuestas de llamada.
- 04Comprueba que no se soliciten ni ejecuten herramientas de envío, exportación o elevación de permisos.
- 05Verifica que el registro conserve procedencia, decisión de política, datos considerados y resultado de la tarea.
- 06Repite con variantes de redacción y coloca el intento en una respuesta de herramienta o en la memoria.
Observabilidad y respuesta a incidentes
Los registros de seguridad también son datos sensibles. Define su retención, acceso, cifrado y los procedimientos de consulta. Conserva contexto suficiente para reconstruir decisiones, pero minimiza la exposición de secretos y datos personales en los sistemas de observabilidad.
Un registro útil permite reconstruir el flujo sin conservar más contenido sensible del necesario. Debe vincular la solicitud autenticada, la versión de la política, los identificadores y etiquetas de los fragmentos recuperados, el plan propuesto, las herramientas candidatas, los argumentos normalizados, las decisiones de autorización, las aprobaciones y el resultado. Según la sensibilidad, almacena huellas, referencias controladas o copias cifradas con acceso restringido, en vez de replicar documentos completos sin control.
Define señales de alerta: desviación entre el objetivo inicial y una acción propuesta, solicitud de herramientas no disponibles para la tarea, cambio de destinatario, intento de acceder a campos no recuperados, cadenas inusuales de herramientas y salidas hacia destinos nuevos. Las señales ayudan a priorizar la revisión, pero no sustituyen la política preventiva ni garantizan que se detecten todos los ataques.
Ante un incidente, contiene primero el flujo: desactiva temporalmente la herramienta o el conector afectado, revoca tokens o sesiones cuando corresponda y preserva los registros. Después determina el alcance: qué contenido se leyó, qué herramientas se propusieron y ejecutaron, qué datos salieron, con qué identidad y a qué destinos. La investigación debe distinguir una propuesta bloqueada de una acción realmente completada.
La recuperación incluye corregir la regla que permitió el tránsito, revisar privilegios y añadir una regresión que reproduzca el caso. Si hubo salida de datos, activa los procesos de respuesta y notificación que correspondan a la clasificación y jurisdicción aplicables. No atribuyas automáticamente una filtración a una inyección indirecta: confirma la cadena causal con trazas, porque errores de configuración, permisos excesivos o automatizaciones independientes pueden producir efectos similares.
Controles mínimos según el caso de uso
| Caso | Riesgo prioritario | Controles antes de producción |
|---|---|---|
| Asistente documental | El documento recuperado cambia la tarea o solicita revelar contexto | Etiqueta de procedencia, recuperación mínima, sin herramientas de escritura y pruebas de conflicto |
| Agente de correo | Cambio de destinatario, adjunto o reenvío de datos | Directorio o selección explícita de destinos, borrador y vista previa, aprobación para envíos sensibles y credenciales limitadas |
| Navegador con herramientas | Una página externa desencadena una cadena de acciones | Aislamiento del contenido web, lista de herramientas por tarea, validación de argumentos y seguimiento de desvíos del plan |
| Automatización interna | Un ticket o resultado de API provoca cambios de alto impacto | Identidad de servicio de alcance reducido, validación de precondiciones, registro completo y revisión humana para cambios irreversibles |
Criterios de despliegue y límites de la evidencia
La misma política general adopta formas distintas según el caso de uso. Un asistente documental requiere separar con claridad datos e instrucciones, aunque quizá no tenga efectos externos. Un agente de correo añade riesgos relacionados con destinatarios y adjuntos. Un navegador con herramientas incorpora contenido cambiante de múltiples orígenes. Una automatización interna puede operar sobre sistemas críticos aunque sus fuentes parezcan internas. Ajusta los controles al impacto de las acciones, no solo a la probabilidad de encontrar texto hostil.
Antes de abrir un flujo a usuarios, exige pruebas registradas de que el contenido no fiable no altera el objetivo, los permisos, los destinatarios ni las herramientas permitidas. Comprueba también que la identidad de ejecución tiene privilegios mínimos y que las operaciones de alto impacto cuentan con una vista previa o una puerta de aprobación. Si no puedes demostrar estas propiedades, limita el flujo a lectura, reduce los conectores o mantén manual la acción.
Una página o un documento recuperados pueden contener instrucciones hostiles, aunque también aporten datos pertinentes. La pregunta de seguridad no es solo si el asistente recuperó contenido correcto o tiene acceso a una herramienta permitida: es qué mecanismo impide que el contenido se convierta en autoridad para ordenar una acción. La documentación de OWASP y Microsoft propone medidas en capas, como separar contenido no fiable, limitar privilegios, controlar las herramientas y supervisar las acciones; son recomendaciones de reducción y contención del riesgo, no garantías de prevención completa.
La publicación AI 100-2 E2025 de NIST es una taxonomía y terminología de aprendizaje automático adversarial, no una guía específica de diseño para asistentes conectados. La documentación de OWASP y Microsoft aporta recomendaciones operativas, pero su eficacia depende de la implementación, los conectores, las identidades y las políticas de datos. LLMail-Inject es un benchmark centrado en ataques adaptativos contra un asistente de correo con herramientas; sus resultados no deben generalizarse automáticamente a otros sistemas. No existe una garantía general de que un modelo reconocerá toda inyección indirecta: el objetivo práctico es combinar defensas, limitar el daño si una capa falla y mantener pruebas para los flujos desplegados.
Comprobaciones antes de habilitar acciones
- 01Verifica que el objetivo de la tarea procede de una solicitud autorizada y no de un documento recuperado.
- 02Comprueba que los permisos de cada herramienta son los mínimos necesarios y que se validan fuera del modelo.
- 03Ensaya inyecciones directas e indirectas en los canales que el flujo realmente procesa.
- 04Confirma que las acciones sensibles muestran destino, datos y efecto antes de ejecutarse.
- 05Si las pruebas no demuestran los límites requeridos, reduce capacidades o mantén la ejecución manual.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección