Was sich mit Agent Lightning ändert
Microsoft Research stellt Agent Lightning v1.0 als Framework vor, mit dem sich KI-Agenten durch Reinforcement Learning trainieren lassen, ohne ihre Logik im Trainingssystem neu aufzubauen. Die Idee: Der Agent, der bereits Aufgaben ausführt, bleibt bestehen – einschließlich seiner Abläufe, Werkzeuge und Kontextverwaltung. Über einen Proxy für Modellaufrufe wird er an die Trainingsinfrastruktur angebunden.
Das Framework soll eine häufige Trennung zwischen Entwicklung und Training überwinden: Agenten-Frameworks organisieren Interaktionen mit Werkzeugen und anderen Agenten, während Reinforcement-Learning-Systeme das Modell optimieren. Muss ein Agent für das Training neu implementiert werden, kann sich diese Version anders verhalten als der später eingesetzte Agent. Agent Lightning soll das Training stattdessen am Verhalten des Agenten in seinem eigenen Ablauf ausrichten.
Version 1.0 wurde gegenüber früheren Projektversionen grundlegend überarbeitet. Das Repository beschreibt sie als schlanke Implementierung und veröffentlicht den Code unter der MIT-Lizenz. Die ungefähre Angabe von 3.500 Codezeilen und die damit verbundenen Aussagen zur Einfachheit stammen vom Projektteam. Sie sind keine unabhängige Messung des Bedienkomforts oder des gesamten Einführungsaufwands.
Wie Agenten und Training verbunden werden
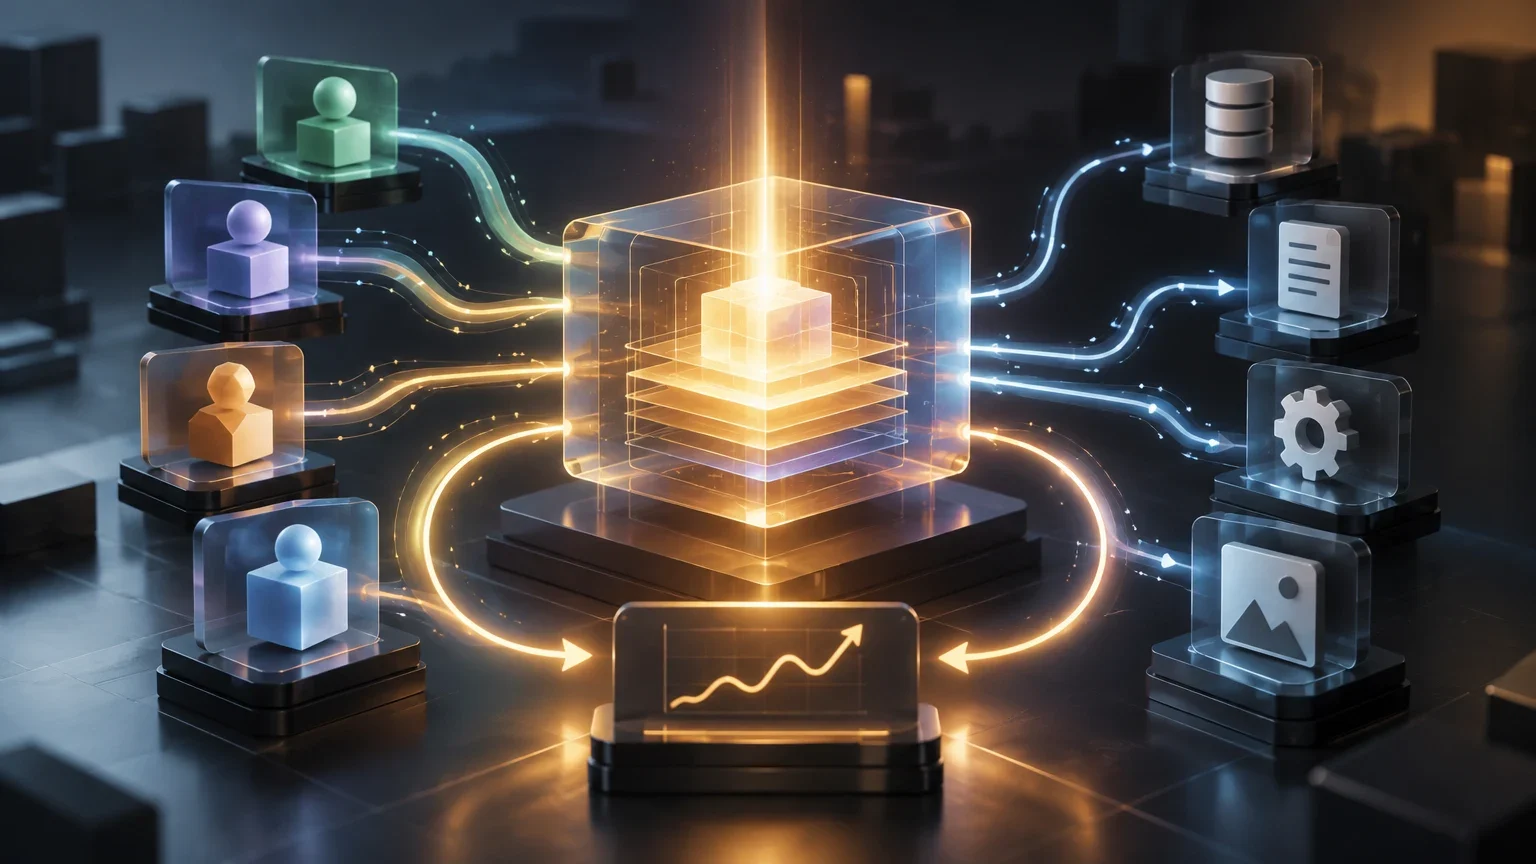
In der beschriebenen Architektur vermitteln ein Agent-Lightning-Server und ein Client zwischen Agent und Trainingssystem. Für Version 1.0 nennt das Repository drei zentrale Komponenten: einen auf verl aufbauenden Trainer, ein API-Gateway als OpenAI-kompatiblen Proxy zur Datenerfassung und einen Rollout-Controller, der Agenten lokal oder als Kubernetes-Jobs startet.
Der Agent sendet seine Modellanfragen über das Gateway. Dieses ordnet die Aufrufe dem jeweiligen Durchlauf zu und erfasst Informationen, die für Trainingsdaten benötigt werden, darunter Anfragen, Antworten und die zugehörigen Wahrscheinlichkeiten der Generierung. Der Controller verwaltet die Agentenausführung; der Trainer bereitet die Stichproben auf und aktualisiert die Modellpolitik. So bleiben Agentenlogik und Trainingslogik getrennte Komponenten.
Der beschriebene Ablauf beginnt mit Aufgaben und Agentendurchläufen. Dabei werden Interaktionen, Fehler und Belohnungssignale erfasst. Nutzer können diese Signale so konfigurieren, dass sie den Erfolg oder Misserfolg einer Aufgabe abbilden. Anschließend werden die aufgezeichneten Abläufe in Daten umgewandelt, die das Trainingssystem verarbeiten kann. Microsoft Research beschreibt Reinforcement-Learning-Algorithmen, darunter GRPO im verl-basierten Ablauf. Daraus folgt nicht, dass sämtliche Algorithmen oder Konfigurationen standardmäßig enthalten sind.
Das Projekt nennt OpenAI Agents SDK, LangChain und AutoGen als derzeit unterstützte Frameworks. Diese Liste beschreibt die vom Projekt dokumentierte Kompatibilität, ist aber keine Garantie, dass sich jeder damit erstellte Agent ohne Anpassungen anschließen lässt. Änderungen am Endpunkt, die Verwaltung von Zugangsdaten, das Format der Aufrufe und Agentenabhängigkeiten können Integrationsarbeit erfordern.
Beschriebener Trainingsablauf
- 01Der Controller startet eine Aufgabe und führt den Agenten mit seinem üblichen Ablauf aus.
- 02Der Agent leitet seine Modellanfragen über das Agent-Lightning-Gateway weiter.
- 03Das Gateway erfasst Interaktionen und konfigurierte Signale; das System bereitet die Ablaufdaten als Trainingsstichproben auf.
- 04Der Trainer aktualisiert das Modell. Anschließend kann der Agent mit der aktualisierten Modellpolitik erneut ausgeführt werden.
Was Training mit dem echten Agenten-Framework bedeutet
Das Agenten-Framework – oft auch Harness genannt – koordiniert das Verhalten des Agenten rund um das Modell. Es kann Kontext, Gesprächsverlauf, Speicher, Werkzeuge, die Reihenfolge der Schritte sowie die Interaktion mit anderen Agenten oder einer Umgebung verwalten. Agent Lightning soll dieses Framework auch während des Trainings einsetzen, statt es durch eine vereinfachte Schleife zu ersetzen, die vollständig vom Reinforcement-Learning-System gesteuert wird.
Praktisch werden die Modellanfragen des Agenten über den Proxy geleitet. So kann er seine Werkzeuge, Kontrolllogik und Umgebungen beibehalten, während die für das Training relevanten Interaktionen erfasst werden. Microsoft Research erklärt, dass sich der Agent bei den von der Architektur abgedeckten Fällen ohne Änderungen am Agentencode trainieren lässt. Auch das Repository verspricht eine Ausführung ohne Codeänderungen. Das sind Beschreibungen des Designs, kein Nachweis dafür, dass jede reale Integration buchstäblich ohne Anpassungen auskommt.
Der Erhalt des Agenten-Frameworks bringt zugleich technische Herausforderungen mit sich. Eine Aufgabe kann mehrere Modellaufrufe erzeugen, und jeder Aufruf kann als eigene Trainingsstichprobe behandelt werden. Das Agenten-Framework verwaltet Kontext als Text; für das Training können jedoch die ursprünglich erzeugten Token-IDs benötigt werden. Eine erneute Tokenisierung kann die Token-Grenzen verändern. Außerdem können Kontextzusammenfassungen oder delegierte Aufgaben an Unteragenten einen Ablauf unterschiedlich aufteilen. Das Team verweist auch auf Herausforderungen bei der Berechnung von Vorteilen, der Normalisierung des Verlusts nach Ablauf und der Zuordnung variabler Arbeitslasten zu vorab festgelegten GPU-Ressourcen.
Version 1.0 beschreibt einen asynchronen Trainingsmodus, bei dem Ressourcen gemeinsam genutzt werden: Zunächst werden Durchläufe gesammelt. Dann werden vorübergehend keine neuen Anfragen angenommen, bis die laufenden abgeschlossen sind. Es folgt die Modellaktualisierung; anschließend werden die Durchläufe fortgesetzt. Microsoft Research berichtet aus eigenen Experimenten von einer ungefähr doppelt so hohen Geschwindigkeit wie bei einer synchronen Konfiguration. Dieser Wert gilt für die getesteten Bedingungen und erlaubt keine Vorhersage für andere Agenten, Hardware oder Arbeitslasten.
Verfügbarer Code, Kompatibilität und Inbetriebnahme
Das offizielle Repository veröffentlicht Agent Lightning v1.0 unter der MIT-Lizenz und stellt Dokumentation, Beispiele und Skripte bereit. Zu den aufgeführten Beispielen gehören mathematische Aufgaben mit AutoGen und MCP-Werkzeugen, GSM8K, ScienceWorld, Suche und Schlussfolgern, Codeausführung in einer isolierten Umgebung sowie ein Programmieragent. Ein dokumentiertes Beispiel bedeutet nicht, dass das Projekt jede Konfiguration der jeweiligen Umgebung garantiert unterstützt.
Als Installationsbeispiel nennt das Repository eine Maschine mit CUDA 13.0. Die Abhängigkeiten werden mit uv synchronisiert; anschließend richtet ein Skript verl in der angegebenen Version und CUDA-Variante ein. Das ist weder als universelle Installation noch als Beleg dafür zu verstehen, dass der gesamte Ablauf auf einem Rechner ohne kompatible GPU funktioniert. Vor einer Reproduktion sollten die aktuelle Installationsanleitung, Abhängigkeitsversionen, verfügbare Beschleuniger und die Anforderungen des jeweiligen Beispiels geprüft werden.
Die Ausführung von Agenten als reguläre Kubernetes-Jobs zählt zu den hervorgehobenen Funktionen von Version 1.0. Lokale Ausführung ist ebenfalls vorgesehen. Kubernetes kann die Nutzung eigener Infrastruktur oder kompatibler Dienste ermöglichen, erfordert aber die Verwaltung des Clusters, der Ressourcen, der Images und der Sicherheit der Jobs. Die Aussage, dass diese Möglichkeit eine Abhängigkeit von kommerziellen Sandbox-Diensten vermeiden kann, beschreibt eine Architekturentscheidung. Sie bedeutet nicht, dass Trainingsläufe im großen Maßstab ohne Betriebskosten auskommen.
Die ungefähre Angabe von 3.500 Codezeilen findet sich sowohl in der Projektbeschreibung als auch in der institutionellen Veröffentlichung. Die vorliegenden Informationen nennen keine unabhängige Zählmethode – etwa dazu, welche Verzeichnisse, generierten Dateien oder Abhängigkeiten berücksichtigt werden. Die Zahl sollte daher als Näherungswert des Teams gelesen werden, nicht als objektiver Komplexitätsvergleich mit anderen Frameworks.
Was vor der Wahl einer Konfiguration zu prüfen ist
| Anforderung | Dokumentierter Stand | In der Praxis zu prüfen |
|---|---|---|
| Bestehenden Agenten anbinden | OpenAI-API-kompatibler Proxy; das Projekt nennt OpenAI Agents SDK, LangChain und AutoGen als kompatibel. | Endpunkt, Authentifizierung, Aufrufformat, Abhängigkeiten und nötige Agentenänderungen. |
| Mit verl trainieren | Der Trainer von Version 1.0 basiert auf verl; das Projekt beschreibt Abläufe mit Reinforcement-Learning-Algorithmen. | Kompatible Versionen, konkreter Algorithmus, GPU-Konfiguration und Definition der Belohnungen. |
| Auf Kubernetes ausführen | Der Controller kann Agenten als reguläre Kubernetes-Jobs starten. | Berechtigungen, Ressourcen je Job, Image-Verwaltung, Isolation und Clusterkosten. |
| Lokal testen | Das Repository enthält Beispiele und einen Installationsweg für CUDA 13.0. | Hardwarekompatibilität, Softwareversionen und spezifische Anforderungen der Beispiele. |
Veröffentlichte Ergebnisse und offene Prüfungen
Microsoft Research stellt ein Programmieragenten-Beispiel mit Qwen3.5-9B, mini-SWE-agent und SWE-smith vor. Nach Angaben des Teams stieg das Ergebnis auf SWE-bench Verified nach Reinforcement Learning mit ungefähr 6.000 Trainingsbeispielen bei Pass@1 von 41,8 auf 56,4 Prozent. Das entspricht einem Zuwachs von 14,6 Prozentpunkten. Der Wert bezieht sich auf dieses Experiment und seine Konfiguration. Er belegt nicht, dass Agent Lightning bei anderen Modellen, Agenten oder Aufgaben dieselbe Verbesserung erzielt.
Das Repository berichtet außerdem von einem späteren Beispiel mit Qwen3.5-35B-A3B: Auf SWE-bench Verified sei der Wert laut Projekt nach dem Training mit 1.800 Beispielen von 47,8 auf 61,6 Prozent gestiegen. Diese Ergebnisse werden von den Autoren des Systems berichtet und sollten als solche gekennzeichnet werden. Die vorliegenden Quellen enthalten weder eine unabhängige Reproduktion dieser Zahlen noch einen kontrollierten Vergleich, der den Beitrag des Frameworks von anderen Faktoren des Trainings trennt.
Für eine Einschätzung des allgemeinen Nutzens wären Reproduktionen mit ausreichenden Angaben zu Versionen, Daten, Rechenbudget, Modellkonfiguration, Belohnungen und Evaluierungsverfahren nötig. Hinzukommen sollten Vergleiche mit untrainierten Agenten und anderen Methoden sowie Tests mit weiteren Aufgaben und Umgebungen. Sinnvoll wären auch Messungen des Integrationsaufwands, der Kosten und Laufzeit, der Stabilität zwischen Durchläufen, der Agentenfehler und der Empfindlichkeit gegenüber fehlerhaften Belohnungen. Das technische Material räumt selbst Schwierigkeiten bei der Zuweisung von Beiträgen über mehrere Schritte und beim Umgang mit unterschiedlich langen Ablaufstichproben ein.
Die belegbare Schlussfolgerung ist enger als ein Versprechen universeller Verbesserungen: Agent Lightning v1.0 bietet eine offene Architektur, die bestehende Agenten unter Beibehaltung ihres Agenten-Frameworks mit Reinforcement Learning verbinden soll. Dazu veröffentlicht das Projekt Beispiele und eigene Ergebnisse. Ob der Ansatz den Integrationsaufwand verringert oder einen bestimmten Agenten verbessert, muss für den jeweiligen Anwendungsfall anhand einer dokumentierten Ausgangsbasis überprüft werden.
Praktische Kriterien für eine erste Bewertung
Ein aussagekräftiger Test beginnt mit einer klar abgegrenzten Aufgabe und einem Agenten, der mit seinem gewohnten Framework bereits funktioniert. Vor dem Training sollten eine Erfolgsmetrik, eine Ausgangsbasis ohne Training und ein Evaluierungssatz festgelegt werden, der von den zur Optimierung verwendeten Daten getrennt ist. Beruht die Belohnung auf automatisierten Tests, muss geprüft werden, ob diese das gewünschte Ergebnis messen und sich nicht durch Abkürzungen umgehen lassen.
Anschließend lässt sich messen, wie viel Aufwand der Anschluss des Agenten an den Proxy verursacht, welche Änderungen nötig sind und ob die aufgezeichneten Abläufe die relevanten Entscheidungen erfassen. Auch Ausführungsfehler, GPU- und CPU-Verbrauch, Dauer der Iterationen und Stabilität möglicher Verbesserungen sollten protokolliert werden. Ein Ergebnis, das nur bei Trainingsbeispielen auftritt oder von einer fragilen Konfiguration abhängt, braucht zusätzliche Validierung.
Die MIT-Lizenz erleichtert die Prüfung und Anpassung des Codes, ersetzt aber weder eine Sicherheits- und Abhängigkeitsprüfung noch die Klärung der Bedingungen für verwendete Modelle und Daten. Die Entscheidung für das Framework sollte sich an der konkreten Kompatibilität, der Fähigkeit zum Betrieb der Infrastruktur und einem reproduzierbaren Vergleich orientieren – nicht allein an der Zeilenzahl oder an den vom Team veröffentlichten Verbesserungen.
Kurze Prüfliste
- 01Einen Agenten und eine Aufgabe mit reproduzierbarer Ausgangsbasis auswählen.
- 02Kompatibilität von Endpunkt, Abhängigkeiten, Hardware und Ausführungsart bestätigen.
- 03Belohnungen und eine getrennte Evaluierung festlegen, bevor das Training beginnt.
- 04Integrationsänderungen, Kosten, Fehler und Ergebnisse aus mehreren Durchläufen protokollieren.
- 05Mit Alternativen vergleichen und unabhängig nicht reproduzierte Verbesserungen als vorläufig kennzeichnen.
Offene Fragen
- Die ungefähre Angabe von 3.500 Codezeilen stammt vom Projekt; eine unabhängige Zählmethode wird nicht genannt.
- Die Ergebnisse auf SWE-bench Verified sind Versuchsangaben von Microsoft Research und dem Projekt-Repository. Die vorliegenden Quellen enthalten keine unabhängige Reproduktion.
- Die dokumentierte Kompatibilität mit bestimmten Frameworks garantiert keine Integration aller Agenten oder Versionen ohne Anpassungen.
- Das Installationsbeispiel verwendet CUDA 13.0 und eine bestimmte verl-Konfiguration. Die Anforderungen können je nach Hardware, Abhängigkeiten und Beispiel variieren.
- Die ungefähr doppelte Geschwindigkeit gegenüber synchronem Training bezieht sich auf die vom Team beschriebenen Versuchsbedingungen. Daraus lässt sich die Leistung bei anderen Arbeitslasten nicht ableiten.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen