Qué cambia con Agent Lightning
Microsoft Research presenta Agent Lightning v1.0 como un marco para entrenar agentes de inteligencia artificial mediante aprendizaje por refuerzo sin reconstruir su lógica dentro del sistema de entrenamiento. La idea es mantener el agente que ya ejecuta tareas —incluidos sus pasos, herramientas y gestión del contexto— y conectarlo a la infraestructura de entrenamiento mediante un proxy para las llamadas al modelo.
El problema que intenta resolver es una separación habitual entre desarrollo y entrenamiento: los marcos de agentes organizan interacciones con herramientas y otros agentes, mientras que los sistemas de aprendizaje por refuerzo gestionan la optimización del modelo. Si el agente debe reimplementarse para entrenarlo, esa versión puede comportarse de forma distinta a la utilizada en producción. Agent Lightning busca que el entrenamiento observe el comportamiento del agente dentro de su propio flujo.
La versión 1.0 supone una reconstrucción del proyecto respecto a entregas anteriores. El repositorio la describe como una implementación ligera y publica el código bajo licencia MIT. La cifra aproximada de 3.500 líneas y los beneficios atribuidos a esa sencillez son datos declarados por el equipo del proyecto, no una medida independiente de facilidad de uso o coste total de adopción.
Cómo conecta agentes y entrenamiento
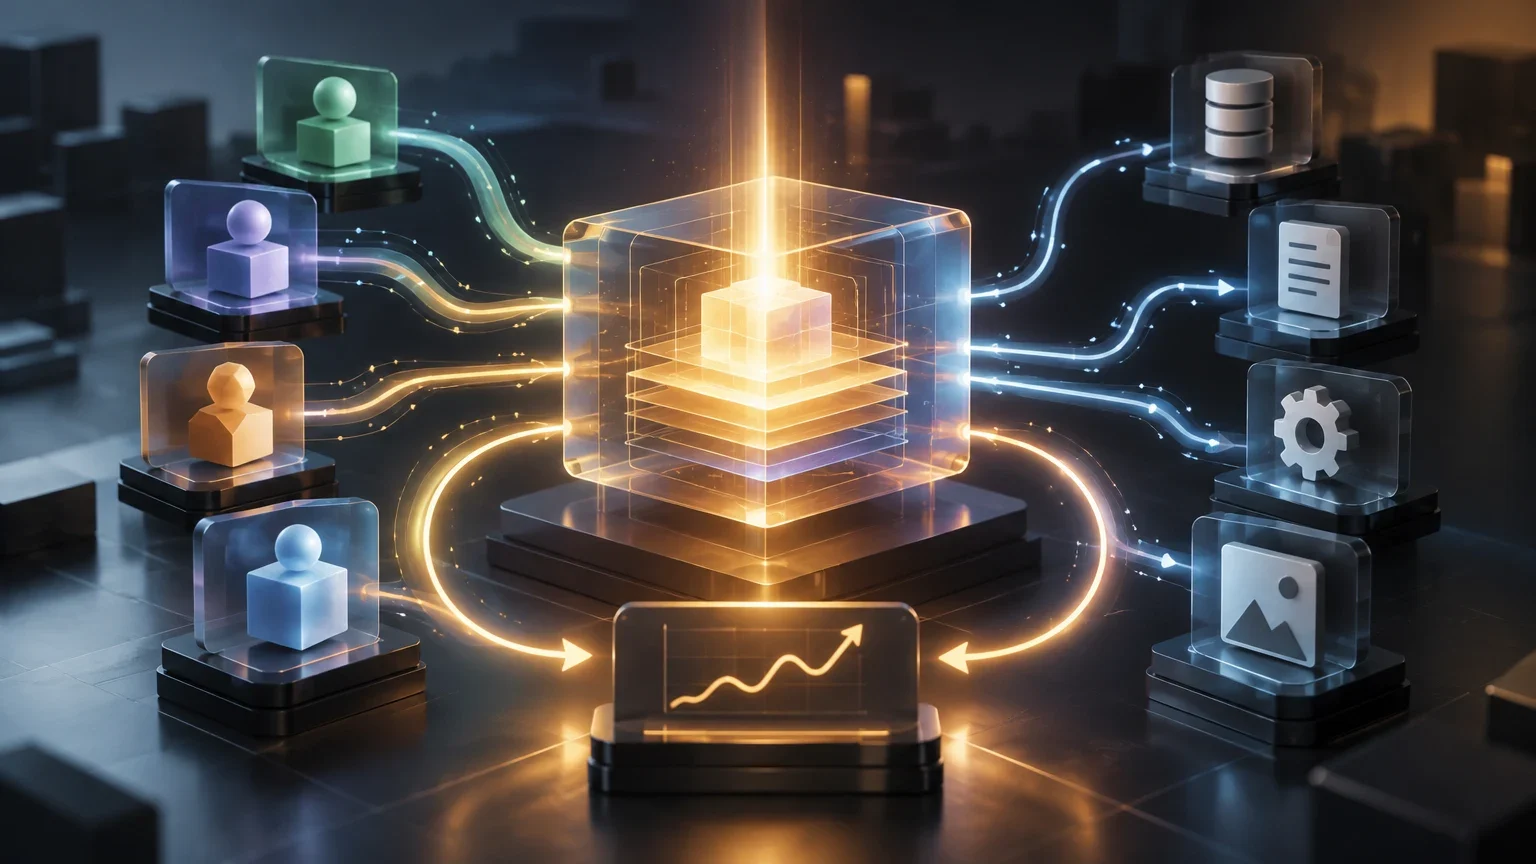
En la arquitectura descrita, un servidor y un cliente de Agent Lightning median entre el agente y el sistema de entrenamiento. En la versión 1.0, el repositorio presenta tres componentes principales: un entrenador basado en verl, una pasarela de API que actúa como proxy compatible con la API de OpenAI y recoge datos, y un controlador de ejecuciones que inicia los agentes localmente o como trabajos de Kubernetes.
El agente envía sus solicitudes al modelo a través de la pasarela. Esta vincula las llamadas con la ejecución correspondiente y registra información necesaria para formar datos de entrenamiento, como solicitudes, respuestas y probabilidades asociadas a la generación. El controlador administra la ejecución del agente, mientras el entrenador organiza las muestras y actualiza la política del modelo. La separación permite que la lógica del agente y la del entrenamiento evolucionen como componentes distintos.
El flujo descrito parte de tareas y ejecuciones del agente. Durante estas, se registran interacciones, errores y señales de recompensa, que pueden configurarse para reflejar el éxito o fracaso de una tarea. Después, las trazas se convierten en datos utilizables por el sistema de entrenamiento. Microsoft Research describe el uso de algoritmos de aprendizaje por refuerzo, incluido GRPO en el flujo basado en verl; esto no significa que todos los algoritmos o configuraciones estén incorporados de forma predeterminada.
El proyecto declara compatibilidad actual con OpenAI Agents SDK, LangChain y AutoGen. Esa lista debe entenderse como compatibilidad documentada por el propio proyecto, no como garantía de que cualquier agente construido con esos marcos pueda conectarse sin ajustes. Los cambios de endpoint, la gestión de credenciales, el formato de las llamadas y las dependencias del agente pueden exigir trabajo de integración.
Flujo de entrenamiento descrito
- 01El controlador inicia una tarea y ejecuta el agente con su flujo habitual.
- 02El agente dirige las solicitudes al modelo a través de la pasarela de Agent Lightning.
- 03La pasarela registra interacciones y señales configuradas; el sistema organiza las trazas como muestras de entrenamiento.
- 04El entrenador aplica la actualización del modelo y el agente puede volver a ejecutarse con la política actualizada.
Qué significa entrenar con el arnés real
El arnés es la capa que coordina el comportamiento del agente alrededor del modelo: puede gestionar el contexto, el historial, la memoria, las herramientas, el orden de los pasos y la interacción con otros agentes o con un entorno. La propuesta de Agent Lightning es que ese arnés siga participando durante el entrenamiento, en lugar de sustituirse por un bucle simplificado controlado enteramente por el sistema de aprendizaje por refuerzo.
En términos prácticos, las solicitudes que el agente ya envía al modelo pasan por el proxy. Así, el agente puede conservar sus herramientas, su lógica de control y sus entornos mientras se recogen las interacciones pertinentes para entrenar. Microsoft Research sostiene que este diseño evita modificar el código del agente en los casos contemplados por su arquitectura; el repositorio formula también la promesa de ejecutar agentes con cambios nulos. Son descripciones del diseño, no evidencia de que todas las integraciones reales sean literalmente cero cambios.
Mantener el arnés también introduce problemas técnicos. Una misma tarea puede producir varias llamadas al modelo, y cada llamada puede convertirse en una muestra distinta. El agente conserva el contexto como texto, mientras el entrenamiento puede necesitar los identificadores de tokens generados originalmente. Volver a tokenizar el texto puede alterar los límites entre tokens; además, resumir contexto o delegar en subagentes puede dividir una trayectoria de formas distintas. El equipo señala asimismo retos para calcular ventajas y normalizar pérdidas por trayectoria, y para adaptar cargas variables a recursos de GPU configurados de antemano.
La versión 1.0 describe un modo de entrenamiento asíncrono compartiendo recursos: se recogen ejecuciones, se pausa temporalmente la entrada de solicitudes nuevas mientras terminan las que ya están en curso, se actualiza el modelo y luego se reanudan las ejecuciones. Microsoft Research comunica una aceleración aproximada de dos veces frente a una configuración síncrona en sus experimentos. Ese dato corresponde a las condiciones probadas por el equipo; no permite anticipar la velocidad en cualquier agente, hardware o carga de trabajo.
Código disponible, compatibilidad y puesta en marcha
El repositorio oficial publica Agent Lightning v1.0 con licencia MIT y ofrece documentación, ejemplos y scripts. Entre los ejemplos enumerados figuran tareas matemáticas con AutoGen y herramientas MCP, GSM8K, ScienceWorld, búsqueda y razonamiento, ejecución de código en un entorno aislado y un agente de programación. La presencia de un ejemplo documentado no implica que el proyecto garantice soporte para cualquier configuración de ese entorno.
La instalación de referencia indicada en el repositorio usa una máquina con CUDA 13.0, sincroniza las dependencias con uv y ejecuta un script para configurar verl en la versión y variante de CUDA especificadas. Por tanto, no debe interpretarse como una instalación universal ni como prueba de que el flujo completo funcione en un ordenador sin GPU compatible. Antes de reproducir resultados hay que comprobar la guía de instalación vigente, las versiones de dependencias, la disponibilidad de aceleradores y los requisitos de cada ejemplo.
La ejecución de agentes como trabajos estándar de Kubernetes es una capacidad destacada de v1.0. También se contempla ejecutarlos localmente. Kubernetes permite usar infraestructura propia o servicios compatibles, pero exige administrar el clúster, los recursos, las imágenes y la seguridad de los trabajos. La afirmación de que esta opción evita depender de servicios comerciales de sandbox describe una posibilidad arquitectónica; no significa que ejecutar entrenamientos a escala carezca de costes operativos.
La cifra de unas 3.500 líneas aparece tanto en la descripción del proyecto como en la comunicación institucional. No se aporta en el material disponible una metodología independiente para calcularla —por ejemplo, qué directorios, archivos generados o dependencias se incluyen—, así que conviene leerla como una cifra aproximada del equipo y no como una comparación objetiva de complejidad entre marcos.
Qué revisar antes de elegir una configuración
| Necesidad | Lo documentado | Qué verificar en la práctica |
|---|---|---|
| Conectar un agente existente | Proxy compatible con API de OpenAI; compatibilidad declarada con OpenAI Agents SDK, LangChain y AutoGen. | Endpoint, autenticación, formato de llamadas, dependencias y cambios necesarios en el agente. |
| Entrenar con verl | El entrenador de v1.0 se basa en verl y el proyecto describe flujos con algoritmos de aprendizaje por refuerzo. | Versiones compatibles, algoritmo concreto, configuración de GPU y forma de definir recompensas. |
| Ejecutar en Kubernetes | El controlador puede iniciar agentes como trabajos estándar de Kubernetes. | Permisos, recursos por trabajo, gestión de imágenes, aislamiento y coste del clúster. |
| Probar localmente | El repositorio incluye ejemplos y una ruta de instalación para CUDA 13.0. | Compatibilidad de hardware, versiones de software y requisitos particulares de cada ejemplo. |
Qué resultados se han publicado y qué falta por probar
Microsoft Research presenta un ejemplo de programación con Qwen3.5-9B, mini-SWE-agent y SWE-smith. El equipo comunica que, tras entrenamiento por refuerzo con aproximadamente 6.000 muestras, el resultado en SWE-bench Verified pasó del 41,8 % al 56,4 % en Pass@1: una diferencia de 14,6 puntos porcentuales. La cifra describe ese experimento y configuración; no demuestra que Agent Lightning produzca la misma mejora con otros modelos, agentes o conjuntos de tareas.
El repositorio también informa de un ejemplo posterior con Qwen3.5-35B-A3B: de 47,8 % a 61,6 % en SWE-bench Verified después de entrenar con 1.800 ejemplos, según el proyecto. Son resultados comunicados por los autores del sistema y deben atribuirse como tales. Las fuentes aportadas no incluyen una evaluación independiente que reproduzca esas cifras ni una comparación controlada que aísle la contribución del marco frente a otros factores del entrenamiento.
Para valorar la utilidad general harían falta reproducciones con detalles suficientes sobre versiones, datos, presupuesto de cómputo, configuración del modelo, recompensas y protocolo de evaluación; comparaciones con agentes sin entrenamiento y con otros métodos; y pruebas en más tareas y entornos. También sería útil medir el coste y el tiempo de integración, la estabilidad entre ejecuciones, los fallos del agente y la sensibilidad a recompensas incorrectas. El propio material técnico reconoce dificultades como el reparto de crédito entre pasos y el tratamiento de muestras de trayectorias de diferente longitud.
La conclusión verificable es más acotada que una promesa de mejora universal: Agent Lightning v1.0 ofrece una arquitectura abierta que intenta conectar agentes existentes con entrenamiento por refuerzo conservando su arnés, y publica ejemplos y resultados propios. Que el enfoque reduzca el trabajo de integración o mejore un agente concreto debe evaluarse en cada caso con una línea base y condiciones documentadas.
Criterios prácticos para una evaluación inicial
Una prueba útil comienza con una tarea acotada y un agente que ya funcione con su arnés habitual. Conviene fijar antes del entrenamiento una métrica de éxito, una línea base sin entrenamiento y un conjunto de evaluación separado de los datos usados para optimizar. Si la recompensa depende de pruebas automatizadas, hay que comprobar que estas miden el resultado deseado y no puedan superarse mediante atajos.
Después, se puede medir cuánto cuesta conectar el agente al proxy, qué modificaciones resultan necesarias y si las trazas capturan las decisiones relevantes. También hay que registrar fallos de ejecución, consumo de GPU y CPU, duración de las iteraciones y estabilidad de las mejoras. Un resultado que solo aparece en los ejemplos de entrenamiento o depende de una configuración frágil requiere más validación.
La licencia MIT facilita examinar y adaptar el código, pero no sustituye la revisión de seguridad, de dependencias ni de las condiciones aplicables a los modelos y datos utilizados. La decisión de adoptar el marco debería basarse en la compatibilidad concreta, la capacidad de operar la infraestructura y una comparación reproducible, no únicamente en la cifra de líneas o en las mejoras publicadas por el equipo.
Lista breve de comprobación
- 01Elegir un agente y una tarea que ya tengan una línea base reproducible.
- 02Confirmar compatibilidad de endpoint, dependencias, hardware y método de ejecución.
- 03Definir recompensas y una evaluación separada antes de iniciar el entrenamiento.
- 04Registrar cambios de integración, costes, fallos y resultados en varias ejecuciones.
- 05Comparar con alternativas y comunicar como provisionales las mejoras no reproducidas independientemente.
Qué sigue abierto
- La cifra de unas 3.500 líneas es aproximada y procede del proyecto; no se especifica una metodología independiente de recuento.
- Los resultados de SWE-bench Verified son afirmaciones experimentales de Microsoft Research y del repositorio; no hay en las fuentes aportadas una reproducción independiente.
- La compatibilidad declarada con determinados marcos no garantiza integración sin modificaciones en todos los agentes o versiones.
- La instalación de referencia usa CUDA 13.0 y una configuración concreta de verl; los requisitos pueden variar según el hardware, las dependencias y los ejemplos.
- La aceleración aproximada de dos veces frente al entrenamiento síncrono corresponde a las condiciones experimentales comunicadas y no permite inferir el rendimiento en otras cargas.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección