Das Unternehmen hat in den USA Wartelisten für einen in Apple Messages integrierten Agenten und eine API für Großbestellungen eröffnet. Wichtige Fragen sind noch offen, etwa zur Zahlungsbestätigung, zu den verfügbaren Restaurants und zum Umgang mit Unterhaltungen.
Eine Quelle berichtet über eine Ankündigung für Indien. Die vorliegenden Dokumentationen reichen jedoch nicht aus, um verfügbare Modelle, Zeitpunkte oder Konfigurationen dort zu bestätigen oder eine entsprechende Ausweitung auf Südkorea und Singapur zu belegen.
Die verfügbaren Angaben bringen Sicherheitsprobleme in internen Tests mit GPT‑6.1 Astra in Verbindung. Öffentlich zugängliche Testergebnisse oder eine direkte Bestätigung von OpenAI liegen jedoch nicht vor. Die offiziellen Seiten beziehen sich auf GPT‑6 Astra.
Ein Vergleich von drei Modellen bei Aufgaben auf Basis von Adult, COMPAS und Credit kommt zu dem Ergebnis, dass Reasoning einige kontrafaktische Änderungen behebt, aber häufiger neue erzeugt. Daraus folgt nicht, dass derselbe Effekt bei allen Modellen oder Anwendungen auftritt.
Das Preprint stellt ein evolutionäres Suchverfahren vor, das bestehende Evaluierungsfälle verändert. In drei Benchmarks und mit drei Qwen3.5-Modellgrößen berichten die Autoren einen durchschnittlichen Genauigkeitsrückgang von 22,7 Prozent. Die Zusammenfassung reicht jedoch nicht aus, um die Berechnung nachzuvollziehen oder festzustellen, wie realitätsnah die erzeugten Fälle sind.
Auf der Apsara stellte Alibaba den Zhenwu V900 vor, erläuterte den Trainingsstand von Qwen 4 und gab einen Ausblick auf künftige Modelle mit größerem Umfang. Der geplante Marktstart des Chips und der Leistungsvergleich sind Unternehmensangaben, keine unabhängigen Ergebnisse.
Ein Bericht von Google, Google DeepMind und MIT FutureTech kombiniert Interaktionen mit Gemini, ein Verzeichnis spezialisierter Modelle und eine Befragung von Wissenschaftlerinnen und Wissenschaftlern. Die Ergebnisse geben Hinweise auf die Nutzung von KI. Die angegebene Zeitersparnis von fast sieben Stunden pro Woche ist jedoch keine objektive Produktivitätsmessung.
Die Entscheidung des D.C. Circuit stützt eine Maßnahme des Pentagon gegen Anthropic. Sie bedeutet für sich genommen weder ein allgemeines Verbot von Claude noch den Nachweis, dass sämtliche öffentlichen Aufträge des Unternehmens betroffen sind.
Eine theoretische und computergestützte Studie legt nahe, dass ein Agent beeinflussen kann, was die Aufsichtsperson aus einer Debatte lernt, indem er wahre Argumente auswählt und ordnet. Das Ergebnis ist ein Machbarkeitsnachweis – keine Demonstration mit eingesetzten Modellen oder menschlichen Aufsichtspersonen.
Das Preprint führt bereits aufgelöste Ereignisse und datierte Nachrichten zusammen, um Agenten zu verschiedenen historischen Zeitpunkten zu bewerten. Laut Abstract verbessern Recherchewerkzeuge den Brier-Score bei 12 Modellen, doch alle bleiben hinter den historischen Marktprognosen zurück.
Ein Preprint beschreibt ein System, das während der Inferenz domänenspezifische Definitionen sensibler Informationen abruft. Erste Ergebnisse sprechen dafür, dass es in den meisten getesteten Kombinationen mehr relevante Informationen erkennt als ein Vergleichsklassifikator. Die verfügbaren Angaben reichen jedoch nicht aus, um sämtliche Fehler oder die Eignung für den praktischen Einsatz zu beurteilen.
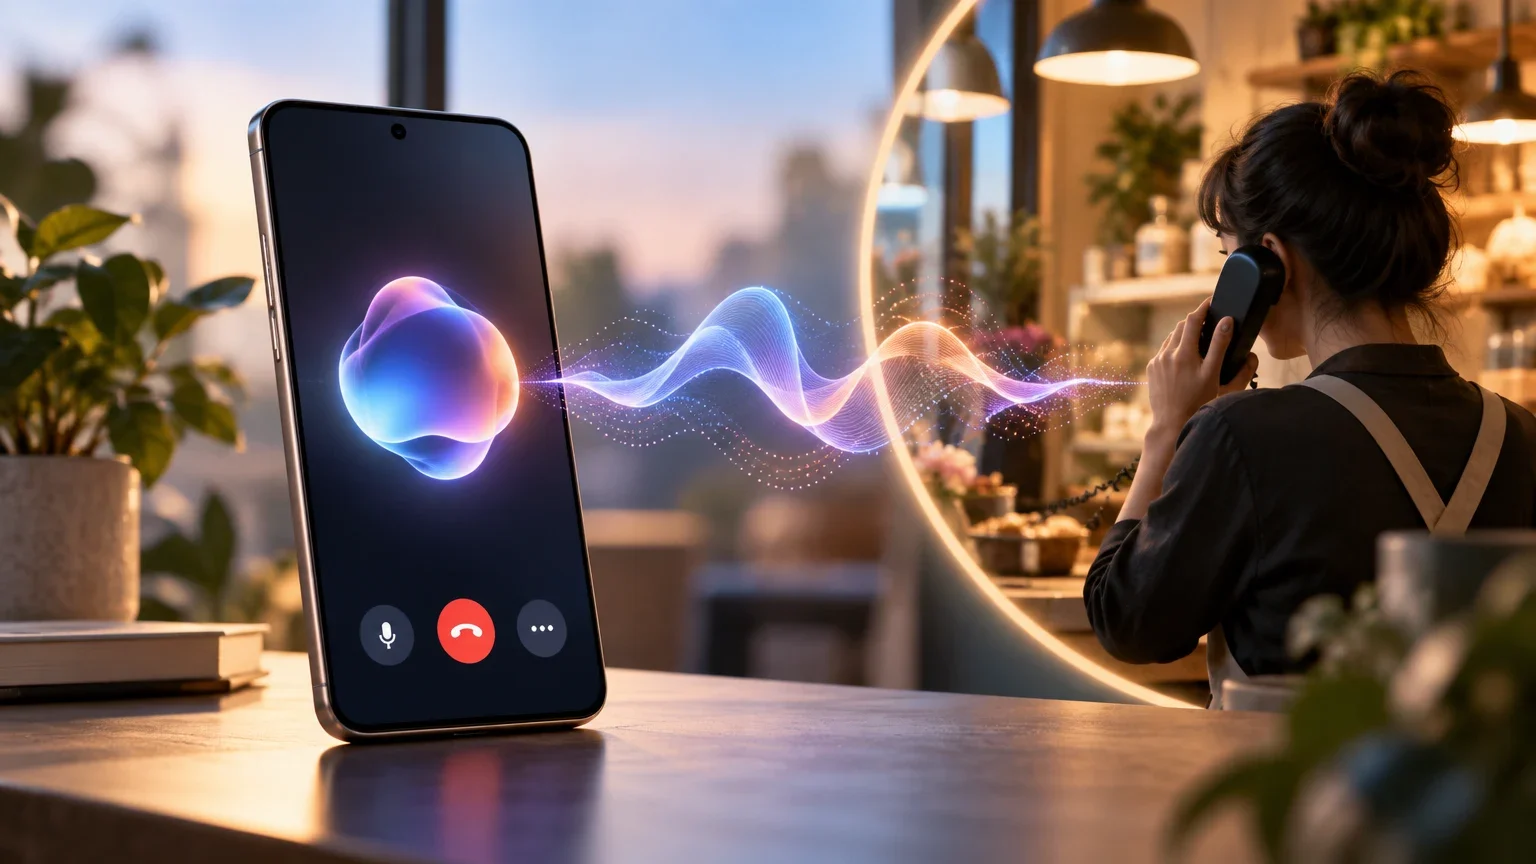
Mit Googles Pilotprojekt kann Gemini einige einfache Anrufe im Namen der Nutzerinnen und Nutzer erledigen. Derzeit ist die Funktion auf Pixel-11-Besitzer in den USA beschränkt, die ein kostenpflichtiges Gemini-Abo haben. Während des Anrufs kann die Person den Vorgang überwachen und selbst übernehmen.