L’azienda ha aperto negli Stati Uniti liste d’attesa per un agente integrato in Apple Messages e per un’API dedicata agli ordini all’ingrosso. Restano da chiarire aspetti fondamentali, come la conferma del pagamento, i ristoranti disponibili e il trattamento delle conversazioni.
Una fonte riferisce un annuncio per l’India, ma la documentazione disponibile non consente di confermare quali modelli, date o configurazioni siano disponibili nel Paese, né di verificare un’espansione equivalente in Corea del Sud e a Singapore.
Le informazioni disponibili collegano a test interni problemi di sicurezza relativi a GPT‑6.1 Astra. Tuttavia, non includono risultati pubblici né una conferma diretta di OpenAI, e le pagine ufficiali citate riguardano GPT‑6 Astra.
Un confronto tra tre modelli su compiti basati su Adult, COMPAS e Credit riferisce che il ragionamento ha risolto alcuni cambiamenti controfattuali, ma ne ha creati altri più spesso. Il risultato non dimostra che lo stesso effetto si verifichi con tutti i modelli o in ogni contesto d’uso.
Il preprint presenta un metodo di ricerca evolutiva che modifica casi di valutazione esistenti. Su tre benchmark e tre dimensioni di Qwen3.5, gli autori riferiscono una riduzione media della precisione del 22,7%, ma l’abstract non consente di verificare il calcolo né di stabilire quanto i casi generati rappresentino situazioni reali.
All’Apsara, Alibaba ha presentato Zhenwu V900, descritto lo stato di addestramento di Qwen 4 e anticipato modelli futuri di maggiori dimensioni. La data di commercializzazione del chip e il confronto sulle prestazioni sono annunci dell’azienda, non risultati indipendenti.
Un rapporto di Google, Google DeepMind e MIT FutureTech combina interazioni con Gemini, un inventario di modelli specializzati e un sondaggio tra scienziati. I risultati offrono indicazioni sull’uso dell’IA, ma le quasi sette ore settimanali dichiarate non equivalgono a una misurazione oggettiva della produttività.
La decisione della Corte d’appello del Circuito di Washington D.C. avalla una misura del Pentagono contro Anthropic. Da sola, però, non equivale a un divieto generale di Claude né consente di concludere che siano interessati tutti i contratti pubblici dell’azienda.
Uno studio teorico e computazionale ipotizza che un agente possa influenzare ciò che apprende chi supervisiona un dibattito selezionando e ordinando argomenti veri. È una prova di concetto, non una dimostrazione condotta con modelli distribuiti o supervisori umani.
Il preprint riunisce eventi risolti e notizie datate per valutare gli agenti in diversi momenti storici. L’abstract segnala miglioramenti con gli strumenti di ricerca in 12 modelli, anche se tutti restano indietro rispetto alle previsioni storiche del mercato.
Un preprint descrive un sistema che consulta definizioni di informazioni sensibili specifiche per dominio durante l’inferenza. I risultati iniziali indicano una capacità di rilevamento superiore a quella di un classificatore di riferimento nella maggior parte delle combinazioni esaminate, ma le informazioni disponibili non consentono di valutare tutti gli errori né la preparazione del sistema per un impiego reale.
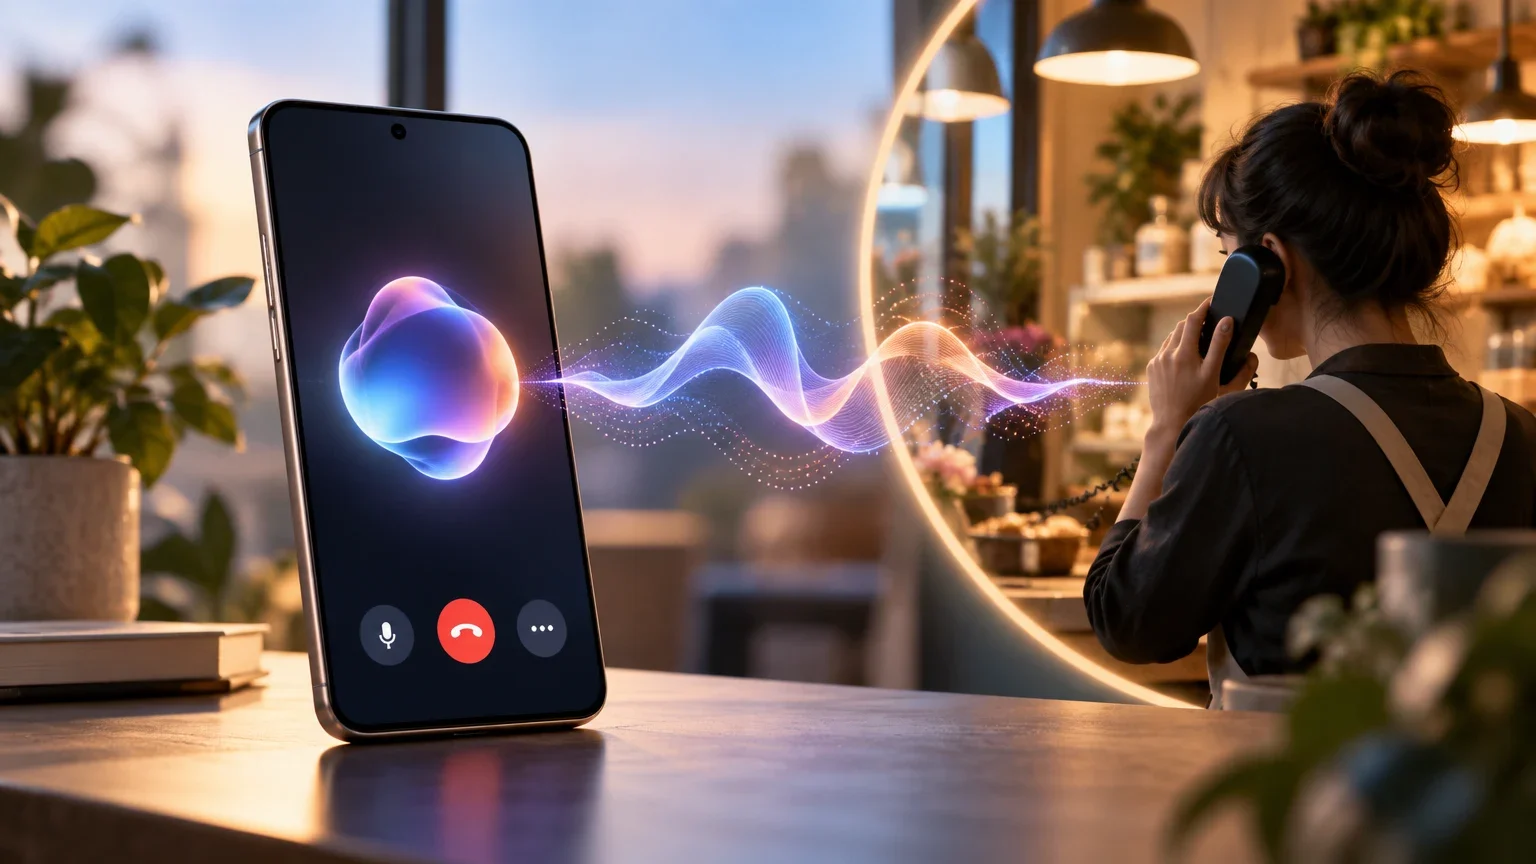
Il test di Google consente a Gemini di gestire alcune semplici telefonate per conto dell’utente. Per ora è limitato ai proprietari di Pixel 11 negli Stati Uniti che hanno un abbonamento a Gemini. La persona può seguire la chiamata e prenderne il controllo.