Un problema di valutazione, non un nuovo test di capacità
HARDEN è un metodo presentato in un preprint per rendere più impegnativi alcuni casi di valutazione dei modelli linguistici. Invece di creare attività da zero, parte da casi già esistenti e cerca di modificarne gli input per produrre varianti più difficili, mantenendo invariato l’output atteso dal sistema. Questa è la proposta centrale descritta dagli autori; non equivale a dimostrare che un modello abbia perso capacità generali, né che un nuovo test misuri da solo e meglio le prestazioni in tutti gli usi.
Il lavoro muove da una preoccupazione relativa ai benchmark curati: secondo l’abstract del preprint, potrebbero rappresentare in modo insufficiente la complessità delle implementazioni aziendali. Questa formulazione spiega la motivazione della ricerca, ma il materiale disponibile non offre una misurazione indipendente di quanto sia diffusa tale carenza di rappresentatività, né definisce quali tipi di implementazione siano coperti. È quindi opportuno considerarla una premessa degli autori, non un risultato dimostrato dalla cifra sulla precisione.
Come cerca di aumentare la difficoltà
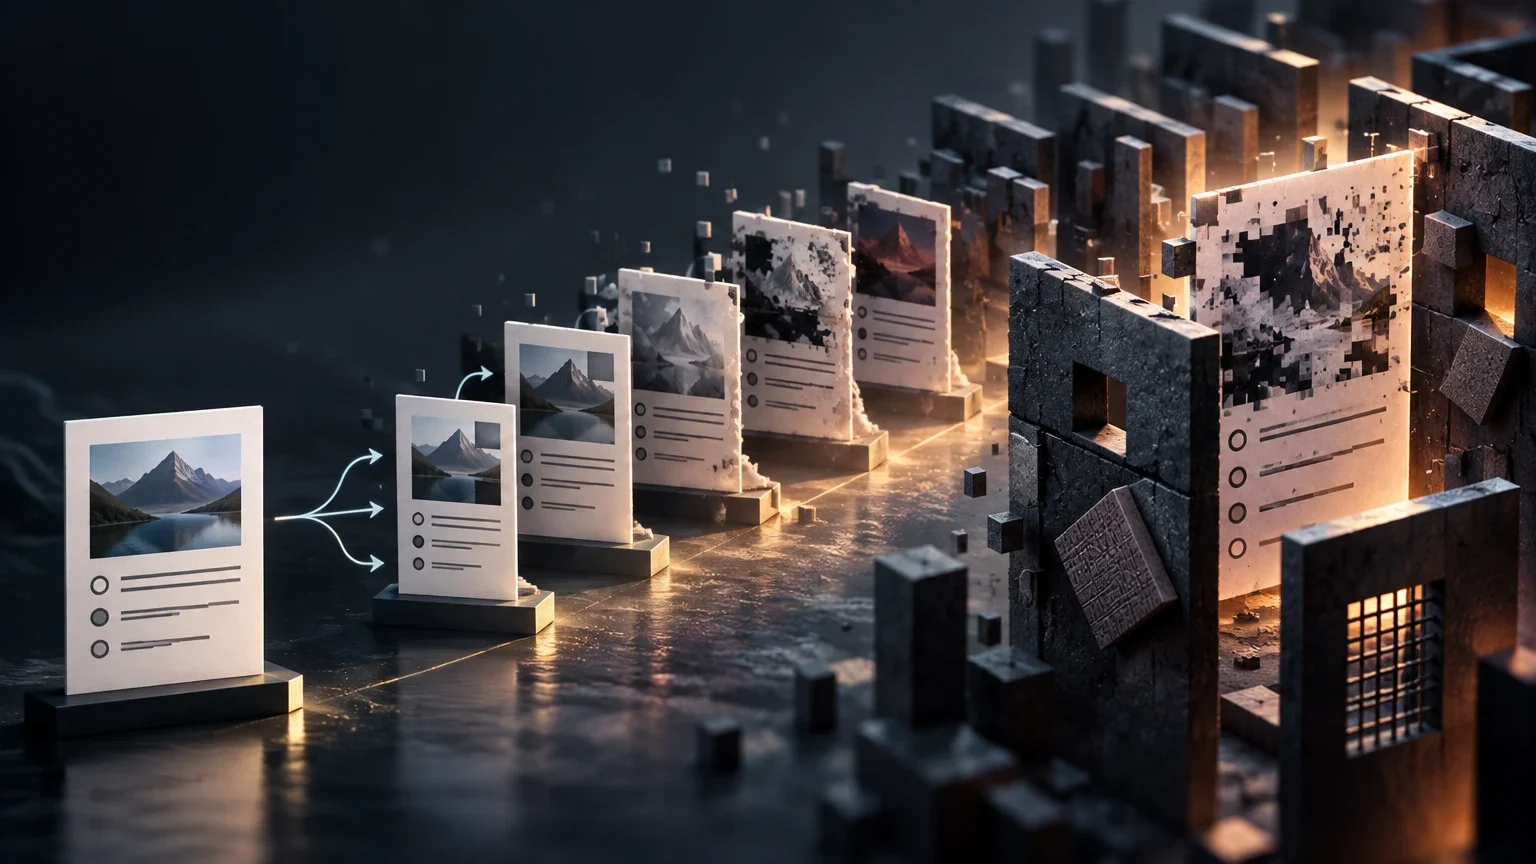
L’abstract descrive HARDEN come un metodo di ricerca evolutiva vincolata. Il sistema esplora variazioni di un input lungo assi di complessità specifici del dominio e applica condizioni di fattibilità. Tra quelle menzionate figurano la conservazione della semantica dell’attività, del realismo e della validità di esecuzione. Anche la risposta attesa per il caso deve rimanere invariata.
In pratica, l’approccio non consiste semplicemente nell’aggiungere parole o dati a una domanda. L’obiettivo è individuare modifiche che rendano più difficile risolverla senza trasformarla in un’altra attività o invalidarne la risposta di riferimento. Tuttavia, l’abstract non specifica gli assi di complessità utilizzati per ciascun benchmark, il funzionamento della ricerca, il modo in cui viene verificata ogni condizione o il tasso di varianti scartate. Non è possibile ricostruire questi aspetti sulla base delle informazioni disponibili.
Il flusso descritto nell’abstract
- 01Partire da un caso di valutazione esistente e dal relativo output atteso.
- 02Cercare varianti dell’input utilizzando assi di complessità definiti per il dominio.
- 03Applicare vincoli di fattibilità: conservare semantica, realismo e validità di esecuzione.
- 04Valutare i modelli sulle varianti che soddisfano tali condizioni.
Che cosa è stato valutato e quali cifre riporta il preprint
L’abstract riferisce test su tre benchmark: FinQA, PubMedQA e ContractNLI. Indica inoltre che sono state valutate tre dimensioni di Qwen3.5: 35B-A3B, 122B-A10B e 397B-A17B. La varietà delle attività permette di osservare il metodo in più di un tipo di valutazione, ma i dati forniti non specificano qui quanti casi siano stati generati, quali versioni precise dei benchmark siano state utilizzate o come si distribuiscano i risultati per attività e modello.
La cifra principale riportata dagli autori è una riduzione media del 22,7% della precisione task-modello. Riferiscono inoltre una riduzione fino al 49,9% rispetto a baseline a singolo passaggio che utilizzano gli stessi controlli di fattibilità. L’abstract non chiarisce con sufficiente dettaglio se la media del 22,7% sia calcolata come variazione relativa o come differenza in punti percentuali, né presenta il dettaglio necessario per ricalcolarla. Non è quindi opportuno tradurre quel dato in un calo uniforme di 22,7 punti percentuali in ogni test.
Ambito dichiarato nell’abstract
| Elemento | Informazioni riportate | Limiti delle informazioni disponibili |
|---|---|---|
| Benchmark | FinQA, PubMedQA e ContractNLI | L’abstract non include i risultati suddivisi per benchmark. |
| Modelli | Qwen3.5 35B-A3B, 122B-A10B e 397B-A17B | Qui non vengono forniti risultati individuali per dimensione. |
| Risultato medio | Riduzione del 22,7% della precisione task-modello | L’abstract non permette di verificare la formula utilizzata per la media. |
| Confronto massimo | Fino al 49,9% rispetto a baseline a singolo passaggio con gli stessi controlli | Qui non sono incluse la tabella comparativa né la suddivisione per attività. |
Come interpretare il calo della precisione
Un test più difficile può ridurre la precisione senza che cambino le capacità sottostanti del modello: è sufficiente che gli input richiedano di risolvere casi più complessi. È proprio questo l’effetto che HARDEN cerca. Secondo il preprint, la cifra indica che i modelli hanno ottenuto una precisione inferiore sulle varianti generate rispetto al quadro di confronto indicato dagli autori. Da sola, però, non dimostra che tali varianti siano più simili a situazioni reali, né che un sistema fallirebbe con la stessa frequenza in un ambiente di lavoro.
Conta anche il riferimento usato per il confronto. L’abstract attribuisce il massimo del 49,9% a un confronto con metodi a singolo passaggio che applicano gli stessi controlli di fattibilità; non afferma che questo massimo si osservi su tutti i benchmark o per tutti i modelli. Per valutare la portata di ciascun risultato servono i dati per attività, la definizione precisa della metrica e il metodo di aggregazione. Senza questi dettagli, è più corretto mantenere la formulazione riportata e non trasformare una media o un massimo in una conclusione universale.
La validità delle varianti resta una questione centrale
Conservare una risposta di riferimento mentre si trasforma un input pone una difficoltà metodologica: una variante può sembrare più complessa e, allo stesso tempo, modificare inavvertitamente l’attività, introdurre ambiguità o cessare di rappresentare un caso plausibile. HARDEN dichiara di applicare vincoli per evitare alcuni di questi problemi, tra cui la conservazione della semantica, del realismo e della validità di esecuzione. È un’informazione rilevante, ma non sostituisce le prove su come siano stati applicati i controlli e sulla loro affidabilità.
L’abstract disponibile non specifica chi o che cosa convalidi il realismo, se vi sia stata una revisione umana indipendente, quali criteri siano stati adottati per stabilire che la risposta attesa resti corretta o quanti esempi siano stati scartati. Non fornisce neppure prove che i casi risultanti somiglino a input osservati in implementazioni reali. Perciò, l’affermazione che il metodo produca casi validi va intesa entro le condizioni e le valutazioni descritte nello studio, in attesa di un esame più approfondito.
Questioni aperte per valutare le prove
| Aspetto | Che cosa riporta l’abstract | Che cosa sarebbe opportuno verificare |
|---|---|---|
| Semantica e risposta | Sono citate come vincoli di fattibilità. | La procedura di verifica e gli esempi sottoposti a revisione. |
| Realismo | È incluso tra le condizioni da preservare. | Criteri, valutatori e confronto con input reali. |
| Esecuzione | Viene menzionata la validità di esecuzione. | Quali attività richiedono esecuzione e come vengono registrati gli errori. |
| Riproducibilità | L’abstract non specifica la disponibilità degli artefatti. | Accesso a casi, codice, configurazioni e risultati completi. |
Che cosa manca per giudicare la portata del metodo
Le informazioni riassunte permettono di identificare la proposta, i tre benchmark, le tre dimensioni di Qwen3.5 e i risultati aggregati riportati dagli autori. Non bastano, invece, per rispondere con precisione a come sia stata calcolata la media del 22,7%, quali risultati siano stati ottenuti per ciascuna combinazione di attività e modello o quanto incida ogni singolo vincolo. Non consentono neppure di stabilire se HARDEN superi in modo consistente altri metodi per la generazione di casi difficili: l’unico confronto specificato nell’abstract è con baseline a singolo passaggio che utilizzano gli stessi controlli di fattibilità.
Per giudicare la riproducibilità sarebbe necessario esaminare il testo completo e verificare se siano pubblicati i casi generati, il codice, le istruzioni di esecuzione e le tabelle dettagliate. Per valutare la rappresentatività, sarebbe utile sapere in che modo le varianti siano state confrontate con input d’uso reale e quale valutazione abbiano ricevuto da esperti o utenti del dominio. L’abstract fornito non conferma questi elementi: non bisogna quindi considerarli disponibili o assenti senza esaminare il materiale completo.
Come leggere i risultati con prudenza
- 01Separare i risultati osservati sui benchmark da qualsiasi previsione sulla produzione.
- 02Interpretare la media e il valore massimo tenendo conto dei rispettivi comparatori e delle metriche.
- 03Cercare i dati suddivisi per benchmark, modello e attività prima di generalizzare.
- 04Verificare in modo indipendente la conservazione della semantica, del realismo e della risposta obiettivo.
- 05Controllare la disponibilità di dati e codice prima di valutare la riproducibilità.
Uno strumento per rendere più impegnativi i test, ancora da caratterizzare
HARDEN propone un metodo sistematico per cercare casi di valutazione più impegnativi partendo da esempi esistenti, con vincoli pensati per preservare ciò che rende valido ciascun caso. I risultati riportati suggeriscono che il metodo sia riuscito a ridurre la precisione dei modelli esaminati su FinQA, PubMedQA e ContractNLI. Il contributo che si può attribuire con sicurezza all’abstract è questa dimostrazione entro l’ambito dell’esperimento, non una convalida definitiva della qualità dei benchmark o della capacità di prevedere gli errori in ambienti aziendali.
La questione successiva non è soltanto se le varianti mettano maggiormente in difficoltà i modelli, ma se lo facciano per ragioni pertinenti e riproducibili. Una valutazione più impegnativa è utile quando conserva l’attività, mantiene una risposta verificabile e rappresenta difficoltà rilevanti anche al di fuori del benchmark. L’abstract afferma che sono stati applicati vincoli orientati a questi obiettivi, ma le informazioni disponibili non permettono di verificare in modo indipendente come siano stati controllati. Finché non saranno disponibili risultati dettagliati e prove sul realismo, il 22,7% va letto come una cifra riportata per i test del preprint, non come una misura generale delle prestazioni dell’IA.
Questioni aperte
- L’abstract non precisa se il 22,7% esprima una riduzione relativa o una differenza in punti percentuali.
- Non sono inclusi risultati suddivisi per benchmark, modello e attività, né informazioni sufficienti per ricalcolare la media.
- Non è dettagliato come siano stati verificati la conservazione semantica, il realismo, la risposta attesa e la validità di esecuzione.
- L’abstract non conferma se siano stati pubblicati i casi generati, il codice e tutti i risultati necessari a riprodurre lo studio.
- Il confronto descritto non basta a determinare le prestazioni relative rispetto a metodi diversi dalle baseline a singolo passaggio menzionate.
- Le informazioni fornite non dimostrano che le varianti somiglino a input osservati in implementazioni reali.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione