Una dificultad de evaluación, no una nueva prueba de capacidad
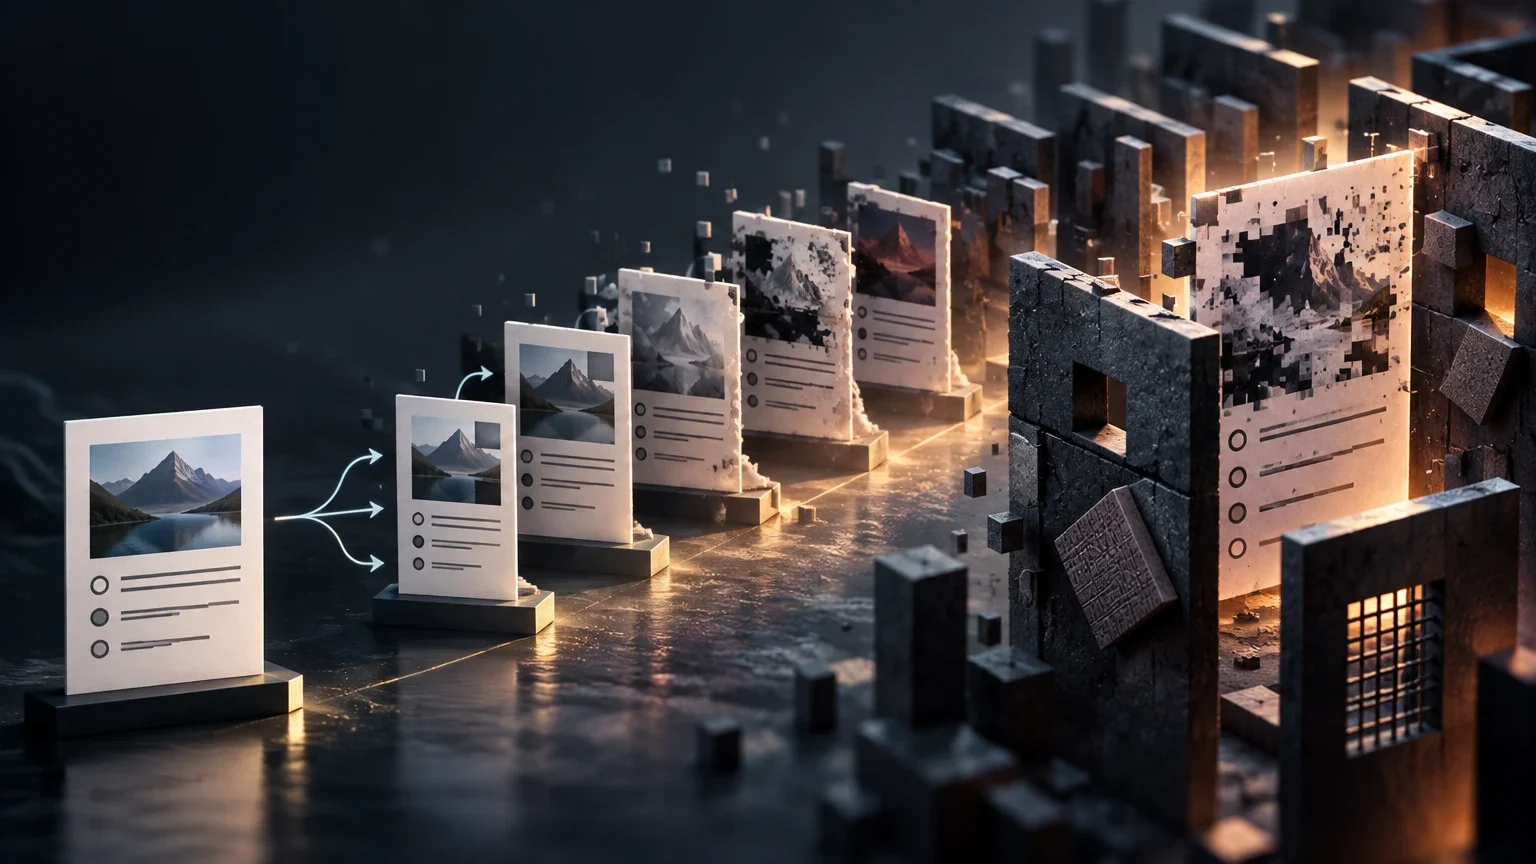
HARDEN es un método presentado en un preprint para hacer más exigentes ciertos casos de evaluación de modelos de lenguaje. En lugar de crear tareas desde cero, parte de casos que ya existen y busca modificar sus entradas para producir variantes más difíciles, manteniendo fija la salida que se espera del sistema. Esa es la propuesta central descrita por sus autores; no equivale a demostrar que un modelo haya perdido capacidades generales ni que una nueva prueba mida mejor, por sí sola, el desempeño en todos los usos.
El trabajo parte de una preocupación sobre los benchmarks curados: según el resumen del preprint, pueden representar de manera insuficiente la complejidad de despliegues empresariales. Esa formulación explica la motivación de la investigación, pero el material disponible no ofrece una medición independiente de cuánto ocurre esa falta de representatividad ni define qué tipos de despliegue quedan cubiertos. Conviene, por tanto, tratarla como la premisa de los autores y no como un resultado probado por la cifra de precisión.
Cómo busca aumentar la dificultad
El resumen describe HARDEN como un método de búsqueda evolutiva restringida. El sistema explora variaciones de una entrada a lo largo de ejes de complejidad específicos del dominio y aplica condiciones de viabilidad. Entre las condiciones mencionadas figuran preservar la semántica de la tarea, mantener el realismo y conservar la validez de ejecución. La respuesta esperada del caso también debe permanecer fija.
En términos prácticos, el enfoque no consiste simplemente en añadir palabras o datos a una pregunta. La intención es hallar cambios que hagan más difícil resolverla sin convertirla en otra tarea ni invalidar su respuesta de referencia. Sin embargo, el resumen no detalla los ejes de complejidad usados en cada benchmark, el funcionamiento de la búsqueda, cómo se comprueba cada condición ni qué tasa de variantes descartadas se obtuvo. No es posible reconstruir esos aspectos a partir de la información disponible.
Flujo descrito en el resumen
- 01Partir de un caso de evaluación existente y de su salida esperada.
- 02Buscar variantes de la entrada mediante ejes de complejidad definidos para el dominio.
- 03Aplicar restricciones de viabilidad: conservar semántica, realismo y validez de ejecución.
- 04Evaluar los modelos sobre las variantes que satisfacen esas condiciones.
Qué se evaluó y qué cifras comunica el preprint
El resumen informa pruebas en tres conjuntos: FinQA, PubMedQA y ContractNLI. También indica que se evaluaron tres escalas de Qwen3.5: 35B-A3B, 122B-A10B y 397B-A17B. La variedad de tareas permite observar el método en más de un tipo de evaluación, pero los datos proporcionados no especifican aquí cuántos casos se generaron, qué versiones exactas de los conjuntos se usaron ni cómo se distribuyen los resultados por tarea y modelo.
La cifra destacada por los autores es una reducción de precisión de tarea-modelo del 22,7 % en promedio. Además, informan una reducción de hasta el 49,9 % en comparación con líneas base de una sola pasada que utilizan las mismas comprobaciones de viabilidad. El resumen no aclara con suficiente detalle si el promedio del 22,7 % se calcula como cambio relativo o como diferencia en puntos porcentuales, ni presenta el desglose necesario para recalcularlo. Por eso, no conviene traducir esa cifra a una caída uniforme de 22,7 puntos porcentuales en cada prueba.
Alcance que declara el resumen
| Elemento | Información reportada | Límite de lo disponible |
|---|---|---|
| Benchmarks | FinQA, PubMedQA y ContractNLI | El resumen no incluye resultados desglosados por conjunto. |
| Modelos | Qwen3.5 35B-A3B, 122B-A10B y 397B-A17B | No se aportan aquí resultados individuales por escala. |
| Resultado promedio | Reducción de precisión de tarea-modelo del 22,7 % | El resumen no permite auditar la fórmula del promedio. |
| Comparación máxima | Hasta un 49,9 % frente a líneas base de una pasada con las mismas comprobaciones | No se incluye aquí la tabla comparativa ni el detalle por tarea. |
Cómo interpretar la caída de precisión
Una prueba más difícil puede reducir la precisión sin que cambie la capacidad subyacente del modelo: basta con que las entradas exijan resolver casos más complejos. Ese es precisamente el efecto que busca HARDEN. La cifra indica, según el preprint, que los modelos obtuvieron menor precisión en las variantes producidas que en el marco de comparación señalado por los autores. No demuestra por sí misma que las variantes sean más parecidas a situaciones reales ni que un sistema vaya a fallar con esa frecuencia en un entorno de trabajo.
También importa el referente de la comparación. El resumen atribuye el máximo del 49,9 % a una comparación con métodos de una sola pasada que aplican las mismas comprobaciones de viabilidad; no dice que ese máximo se observe en todos los benchmarks o modelos. Para valorar la magnitud de cada resultado hacen falta las cifras por tarea, la definición precisa de la métrica y la forma de agregar resultados. Sin esos detalles, lo responsable es conservar la formulación reportada y no convertir un promedio o un máximo en una conclusión universal.
La validez de las variantes sigue siendo una cuestión clave
Preservar una respuesta de referencia mientras se transforma una entrada plantea una dificultad metodológica: una variante puede parecer más compleja y, aun así, cambiar inadvertidamente la tarea, introducir ambigüedad o dejar de representar un caso plausible. HARDEN declara restricciones para evitar algunos de esos problemas, incluidas la conservación semántica, el realismo y la validez de ejecución. Esa descripción es relevante, pero no sustituye la evidencia sobre cómo se aplicaron las comprobaciones ni sobre su fiabilidad.
El resumen disponible no especifica quién o qué valida el realismo, si hubo revisión humana independiente, qué criterios se usaron para determinar que la respuesta esperada sigue siendo correcta ni cuántos ejemplos fueron rechazados. Tampoco aporta pruebas de que los casos resultantes se parezcan a entradas observadas en despliegues reales. Por ello, la afirmación de que el método produce casos válidos debe entenderse dentro de las condiciones y evaluaciones descritas por el estudio, pendientes de examinar con mayor detalle.
Preguntas abiertas para evaluar la evidencia
| Aspecto | Qué informa el resumen | Qué convendría comprobar |
|---|---|---|
| Semántica y respuesta | Se citan como restricciones de viabilidad. | El procedimiento de comprobación y ejemplos revisados. |
| Realismo | Se incluye entre las condiciones que se buscan preservar. | Criterios, evaluadores y comparación con entradas reales. |
| Ejecución | Se menciona la validez de ejecución. | Qué tareas requieren ejecución y cómo se registran fallos. |
| Reproducibilidad | El resumen no detalla la disponibilidad de artefactos. | Acceso a casos, código, configuraciones y resultados completos. |
Qué falta para juzgar el alcance del método
La evidencia resumida permite identificar la propuesta, los tres benchmarks, las tres escalas de Qwen3.5 y los resultados agregados comunicados por los autores. No basta, en cambio, para responder con precisión cómo se calculó el promedio del 22,7 %, qué resultados hubo en cada combinación de tarea y modelo o cuánto influye cada restricción. Tampoco permite establecer si HARDEN supera de forma consistente otros métodos de generación de casos difíciles: la única comparación especificada en el resumen es con líneas base de una sola pasada que usan las mismas comprobaciones de viabilidad.
Para juzgar la reproducibilidad sería necesario examinar el texto completo y verificar si publica los casos generados, el código, las instrucciones de ejecución y las tablas desglosadas. Para evaluar la representatividad, sería útil saber cómo se compararon las variantes con entradas de uso real y qué valoración recibieron de expertos o usuarios del dominio. El resumen proporcionado no confirma esos elementos, por lo que no se deben dar por disponibles ni por ausentes sin revisar el material completo.
Lectura prudente de los resultados
- 01Separar el resultado observado en benchmarks de cualquier predicción sobre producción.
- 02Leer el promedio y el máximo con sus comparadores y métricas correspondientes.
- 03Buscar el desglose por benchmark, modelo y tarea antes de generalizar.
- 04Comprobar de forma independiente la conservación de semántica, realismo y respuesta objetivo.
- 05Revisar la disponibilidad de datos y código antes de valorar la reproducibilidad.
Una herramienta para endurecer pruebas, todavía por caracterizar
HARDEN propone una vía sistemática para buscar casos de evaluación más exigentes a partir de ejemplos existentes, con restricciones destinadas a preservar lo que hace válido cada caso. Los resultados comunicados sugieren que el método consiguió reducir la precisión de los modelos examinados en FinQA, PubMedQA y ContractNLI. La contribución que puede atribuirse con seguridad al resumen es esa demostración dentro del alcance del experimento, no una validación definitiva de la calidad de los benchmarks ni de la predicción de fallos en entornos empresariales.
La siguiente cuestión no es solo si las variantes confunden más a los modelos, sino si lo hacen por razones pertinentes y reproducibles. Una evaluación más exigente es útil cuando conserva la tarea, mantiene una respuesta verificable y representa dificultades que importan fuera del benchmark. El resumen afirma restricciones orientadas a esos objetivos, pero la información disponible no permite comprobar de manera independiente cómo se verificaron. Hasta contar con resultados desglosados y evidencia sobre realismo, el 22,7 % debe leerse como una cifra reportada para las pruebas del preprint, no como una medida general del rendimiento de la IA.
Qué sigue abierto
- El resumen no precisa si el 22,7 % expresa una reducción relativa o una diferencia en puntos porcentuales.
- No se incluyen resultados desglosados por benchmark, modelo y tarea, ni suficiente información para recalcular el promedio.
- No se detalla cómo se verificaron la conservación semántica, el realismo, la respuesta esperada y la validez de ejecución.
- El resumen no confirma si se publicaron los casos generados, el código y todos los resultados necesarios para reproducir el estudio.
- La comparación descrita no basta para determinar el desempeño relativo frente a otros métodos más allá de las líneas base de una sola pasada mencionadas.
- La evidencia proporcionada no demuestra que las variantes se parezcan a entradas observadas en despliegues reales.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección