Un enjeu d’évaluation, pas un nouveau test de capacité
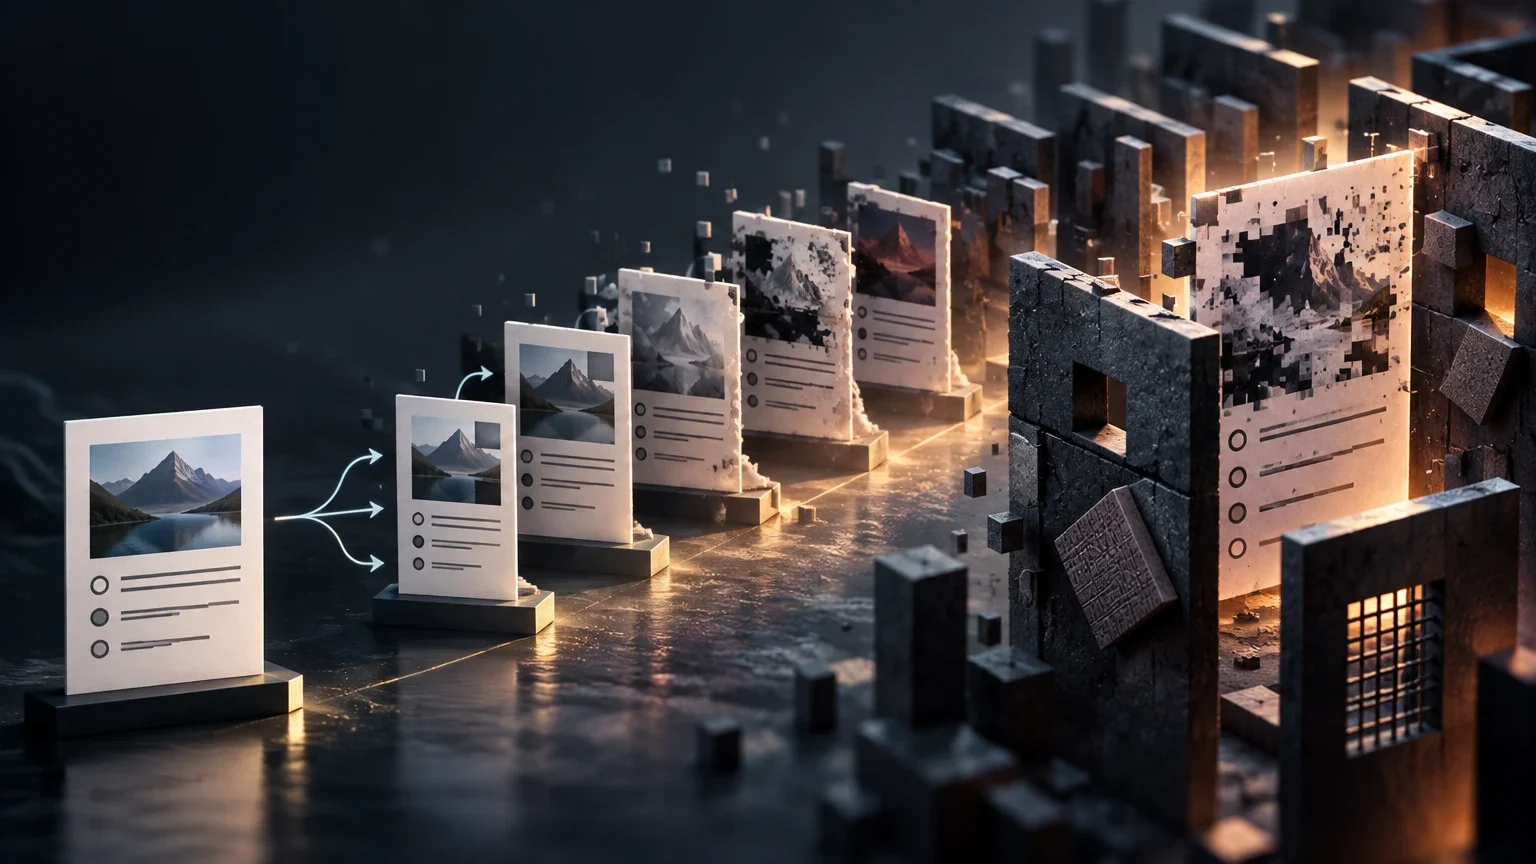
HARDEN est une méthode présentée dans un préprint pour rendre certains cas d’évaluation des modèles de langage plus exigeants. Au lieu de créer des tâches de toutes pièces, elle part de cas existants et cherche à modifier leurs entrées afin de produire des variantes plus difficiles, tout en conservant la sortie attendue par le système. C’est la proposition centrale décrite par les auteurs ; cela ne revient pas à démontrer qu’un modèle a perdu des capacités générales, ni qu’un nouveau test mesure à lui seul les performances dans tous les usages.
Le travail part d’une préoccupation concernant les benchmarks élaborés et sélectionnés : selon le résumé du préprint, ils peuvent représenter de façon insuffisante la complexité des déploiements en entreprise. Cette formulation explique la motivation de la recherche, mais les éléments disponibles ne fournissent pas de mesure indépendante de l’ampleur de ce manque de représentativité et ne définissent pas les types de déploiement concernés. Il convient donc de la considérer comme le point de départ des auteurs, et non comme un résultat démontré par le chiffre de précision.
Comment la méthode cherche à accroître la difficulté
Le résumé décrit HARDEN comme une méthode de recherche évolutive sous contraintes. Le système explore des variations d’une entrée selon des axes de complexité propres au domaine et applique des conditions de faisabilité. Parmi celles qui sont mentionnées figurent la préservation de la sémantique de la tâche, du réalisme et de la validité d’exécution. La réponse attendue pour le cas doit également rester inchangée.
En pratique, l’approche ne consiste pas simplement à ajouter des mots ou des données à une question. Il s’agit de trouver des modifications qui rendent sa résolution plus difficile sans la transformer en une autre tâche ni invalider sa réponse de référence. Toutefois, le résumé ne précise pas les axes de complexité employés pour chaque benchmark, le fonctionnement de la recherche, la façon dont chaque condition est vérifiée ni le taux de variantes rejetées. Les informations disponibles ne permettent pas de reconstituer ces éléments.
Étapes décrites dans le résumé
- 01Partir d’un cas d’évaluation existant et de sa sortie attendue.
- 02Rechercher des variantes de l’entrée au moyen d’axes de complexité définis pour le domaine.
- 03Appliquer des contraintes de faisabilité : préserver la sémantique, le réalisme et la validité d’exécution.
- 04Évaluer les modèles sur les variantes qui satisfont à ces conditions.
Les évaluations menées et les chiffres rapportés par le préprint
Le résumé fait état de tests sur trois jeux de données : FinQA, PubMedQA et ContractNLI. Il indique également que trois tailles de Qwen3.5 ont été évaluées : 35B-A3B, 122B-A10B et 397B-A17B. La diversité des tâches permet d’observer la méthode dans plusieurs types d’évaluation, mais les informations fournies ne précisent pas ici combien de cas ont été générés, quelles versions exactes des jeux de données ont été utilisées, ni comment les résultats se répartissent selon la tâche et le modèle.
Le chiffre mis en avant par les auteurs est une baisse moyenne de 22,7 % de la précision tâche-modèle. Ils rapportent aussi une baisse pouvant atteindre 49,9 % par rapport à des références en un seul passage utilisant les mêmes vérifications de faisabilité. Le résumé ne précise pas suffisamment si la moyenne de 22,7 % correspond à une variation relative ou à une différence en points de pourcentage, et ne fournit pas le détail nécessaire pour la recalculer. Il serait donc imprudent de traduire ce chiffre par une baisse uniforme de 22,7 points de pourcentage dans chaque test.
Périmètre indiqué dans le résumé
| Élément | Informations rapportées | Limites des éléments disponibles |
|---|---|---|
| Benchmarks | FinQA, PubMedQA et ContractNLI | Le résumé ne détaille pas les résultats pour chaque jeu de données. |
| Modèles | Qwen3.5 35B-A3B, 122B-A10B et 397B-A17B | Aucun résultat individuel par taille n’est fourni ici. |
| Résultat moyen | Baisse de 22,7 % de la précision tâche-modèle | Le résumé ne permet pas d’auditer la formule utilisée pour calculer la moyenne. |
| Comparaison maximale | Jusqu’à 49,9 % par rapport à des références en un seul passage utilisant les mêmes vérifications | Le tableau comparatif et les détails par tâche ne sont pas inclus ici. |
Comment interpréter la baisse de précision
Un test plus difficile peut faire baisser la précision sans que les capacités sous-jacentes du modèle aient changé : il suffit que les entrées nécessitent de résoudre des cas plus complexes. C’est précisément l’effet recherché par HARDEN. Selon le préprint, le chiffre indique que les modèles ont obtenu une précision moindre sur les variantes produites que dans le cadre de comparaison indiqué par les auteurs. À lui seul, il ne démontre pas que ces variantes sont davantage comparables à des situations réelles, ni qu’un système échouera avec cette fréquence dans un environnement de travail.
Le point de comparaison compte également. Le résumé attribue le maximum de 49,9 % à une comparaison avec des méthodes en un seul passage qui appliquent les mêmes vérifications de faisabilité ; il ne dit pas que ce maximum est observé dans tous les benchmarks ou pour tous les modèles. Pour apprécier l’ampleur de chaque résultat, il faut disposer des chiffres par tâche, de la définition précise de la métrique et de la méthode d’agrégation des résultats. En l’absence de ces détails, il est préférable de reprendre les résultats tels qu’ils sont rapportés, sans transformer une moyenne ou un maximum en conclusion universelle.
La validité des variantes reste une question centrale
Préserver une réponse de référence tout en transformant une entrée pose une difficulté méthodologique : une variante peut sembler plus complexe et pourtant modifier involontairement la tâche, introduire de l’ambiguïté ou ne plus correspondre à un cas plausible. HARDEN déclare appliquer des contraintes pour éviter certains de ces problèmes, notamment la préservation de la sémantique, du réalisme et de la validité d’exécution. Cette description est pertinente, mais elle ne remplace pas les éléments qui permettraient de savoir comment les vérifications ont été appliquées et quelle est leur fiabilité.
Le résumé disponible ne précise pas qui ou quoi valide le réalisme, si une vérification humaine indépendante a eu lieu, quels critères ont permis de déterminer que la réponse attendue restait correcte, ni combien d’exemples ont été rejetés. Il ne fournit pas non plus de preuve que les cas produits ressemblent à des entrées observées dans des déploiements réels. L’affirmation selon laquelle la méthode génère des cas valides doit donc être comprise dans le cadre des conditions et des évaluations décrites par l’étude, et reste à examiner plus en détail.
Questions ouvertes pour évaluer les éléments disponibles
| Aspect | Ce qu’indique le résumé | Ce qu’il serait utile de vérifier |
|---|---|---|
| Sémantique et réponse | Elles sont citées parmi les contraintes de faisabilité. | La procédure de vérification et des exemples examinés. |
| Réalisme | Il figure parmi les conditions que la méthode cherche à préserver. | Les critères, les évaluateurs et la comparaison avec des entrées réelles. |
| Exécution | La validité d’exécution est mentionnée. | Les tâches nécessitant une exécution et la façon dont les échecs sont consignés. |
| Reproductibilité | Le résumé ne précise pas si les artefacts sont disponibles. | L’accès aux cas, au code, aux configurations et aux résultats complets. |
Ce qui manque pour juger la portée de la méthode
Les éléments résumés permettent d’identifier la proposition, les trois benchmarks, les trois tailles de Qwen3.5 et les résultats agrégés rapportés par les auteurs. En revanche, ils ne suffisent pas à expliquer précisément comment la moyenne de 22,7 % a été calculée, quels résultats ont été obtenus pour chaque combinaison de tâche et de modèle, ni l’influence de chacune des contraintes. Ils ne permettent pas non plus d’établir si HARDEN surpasse de façon constante d’autres méthodes de génération de cas difficiles : la seule comparaison précisée dans le résumé concerne des références en un seul passage qui utilisent les mêmes vérifications de faisabilité.
Pour juger la reproductibilité, il faudrait examiner le texte intégral et vérifier s’il met à disposition les cas générés, le code, les consignes d’exécution et les tableaux détaillés. Pour évaluer la représentativité, il serait utile de savoir comment les variantes ont été comparées à des entrées provenant d’usages réels et quelle appréciation leur ont donnée des experts ou des utilisateurs du domaine. Le résumé fourni ne confirme pas ces éléments : il ne faut donc pas supposer qu’ils sont disponibles ou qu’ils ne le sont pas sans examiner le contenu complet.
Lire les résultats avec prudence
- 01Distinguer les résultats observés sur des benchmarks de toute prédiction concernant la production.
- 02Lire la moyenne et le maximum en tenant compte de leurs comparateurs et des métriques correspondantes.
- 03Rechercher le détail par benchmark, modèle et tâche avant de généraliser.
- 04Vérifier de manière indépendante la préservation de la sémantique, du réalisme et de la réponse cible.
- 05Examiner la disponibilité des données et du code avant de se prononcer sur la reproductibilité.
Un outil pour renforcer les tests, dont la portée reste à caractériser
HARDEN propose une méthode systématique pour rechercher des cas d’évaluation plus exigeants à partir d’exemples existants, avec des contraintes destinées à préserver les propriétés qui rendent chaque cas valide. Les résultats rapportés suggèrent que la méthode a réduit la précision des modèles étudiés sur FinQA, PubMedQA et ContractNLI. La conclusion que l’on peut attribuer avec certitude au résumé est cette démonstration dans le périmètre de l’expérience, et non une validation définitive de la qualité des benchmarks ou de la prédiction des échecs dans des environnements d’entreprise.
La question suivante n’est pas seulement de savoir si les variantes déstabilisent davantage les modèles, mais si elles le font pour des raisons pertinentes et reproductibles. Une évaluation plus exigeante est utile si elle préserve la tâche, conserve une réponse vérifiable et représente des difficultés importantes au-delà du benchmark. Le résumé affirme que des contraintes ont été conçues dans cette optique, mais les informations disponibles ne permettent pas de vérifier de façon indépendante comment elles ont été contrôlées. Dans l’attente de résultats détaillés et d’éléments sur le réalisme des cas, les 22,7 % doivent être lus comme un chiffre rapporté pour les tests du préprint, et non comme une mesure générale des performances de l’IA.
Questions ouvertes
- Le résumé ne précise pas si les 22,7 % correspondent à une baisse relative ou à une différence en points de pourcentage.
- Les résultats ne sont pas détaillés par benchmark, modèle et tâche, et les informations fournies ne suffisent pas à recalculer la moyenne.
- La façon dont la préservation de la sémantique, du réalisme, de la réponse attendue et de la validité d’exécution a été vérifiée n’est pas précisée.
- Le résumé ne confirme pas si les cas générés, le code et l’ensemble des résultats nécessaires à la reproduction de l’étude ont été publiés.
- La comparaison décrite ne suffit pas à déterminer les performances relatives à d’autres méthodes, au-delà des références en un seul passage mentionnées.
- Les éléments fournis ne démontrent pas que les variantes ressemblent à des entrées observées dans des déploiements réels.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction